Запускать несколько сценариев Python одновременно
Как я могу запускать несколько скриптов python? В настоящий момент я запускаю один так, как python script1.py .
Я пробовал python script1.py script2.py , и это не работает: запускается только первый script. Кроме того, я попытался использовать один файл следующим образом:
Однако это тоже не работает.
6 ответов
Что все script. Он будет запускать два сценария Python в одно и то же время.
Python мог бы сделать то же самое, но потребовалось бы намного больше ввода текста и плохой выбор для этой проблемы.
Я думаю, что это возможно, хотя вы принимаете неправильный подход к решению своей проблемы, и я хотел бы услышать, что вы получаете.
Простейшим решением одновременного запуска двух процессов Python является запуск из файла bash и указание каждому процессу перейти в фоновый режим с помощью оператора оболочки & .
Для более контролируемого способа одновременного запуска нескольких процессов просмотрите проект Supervisor или используйте модуль многопроцессорности для организации изнутри Python.
Я делаю это в node.js(в Windows 10), открывая 2 отдельных экземпляра cmd и запуская каждую программу в каждом экземпляре.
Это имеет то преимущество, что запись на консоль легко видна для каждого script.
Я вижу, что в python можно сделать то же самое: 2 оболочки.
Вы можете одновременно запускать несколько экземпляров оболочки IDLE/Python. Итак, откройте IDLE и запустите код сервера, а затем снова откройте IDLE, который запустит отдельный экземпляр, а затем запустит ваш код клиента.
Я работаю в Windows 7 с Python IDLE. У меня две программы,
Я открываю IDLE, а затем открываю файл progA.py. Я запускаю программу, и когда будет предложено ввести ввод, введите «b» + <Enter> , а затем «c» + <Enter>
Я смотрю это окно:
Затем я возвращаюсь в Windows Start и снова открываю IDLE, на этот раз открывая файл progB.py. Я запускаю программу, и когда будет предложено ввести ввод, введите «x» + <Enter> , а затем «y» + <Enter>
Я смотрю это окно:
Теперь две программы IDLE Python 3.6.3 Shell запускаются одновременно, одна оболочка запускает progA, а другая — progB.
Введение в асинхронное программирование на Python
Асинхронное программирование – это вид параллельного программирования, в котором какая-либо единица работы может выполняться отдельно от основного потока выполнения приложения. Когда работа завершается, основной поток получает уведомление о завершении рабочего потока или произошедшей ошибке. У такого подхода есть множество преимуществ, таких как повышение производительности приложений и повышение скорости отклика.
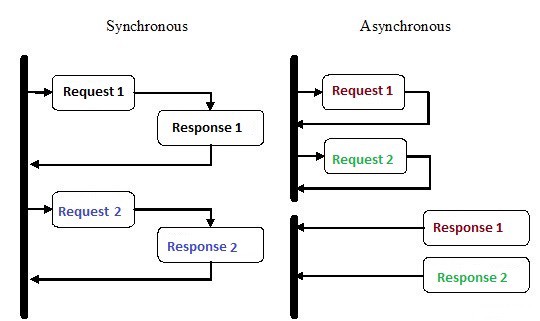
В последние несколько лет асинхронное программирование привлекло к себе пристальное внимание, и на то есть причины. Несмотря на то, что этот вид программирования может быть сложнее традиционного последовательного выполнения, он гораздо более эффективен.
Например, вместо того, что ждать завершения HTTP-запроса перед продолжением выполнения, вы можете отправить запрос и выполнить другую работу, которая ждет своей очереди, с помощью асинхронных корутин в Python.
Асинхронность – это одна из основных причин популярности выбора Node.js для реализации бэкенда. Большое количество кода, который мы пишем, особенно в приложениях с тяжелым вводом-выводом, таком как на веб-сайтах, зависит от внешних ресурсов. В нем может оказаться все, что угодно, от удаленного вызова базы данных до POST-запросов в REST-сервис. Как только вы отправите запрос в один из этих ресурсов, ваш код будет просто ожидать ответа. С асинхронным программированием вы позволяете своему коду обрабатывать другие задачи, пока ждете ответа от ресурсов.
Как Python умудряется делать несколько вещей одновременно?
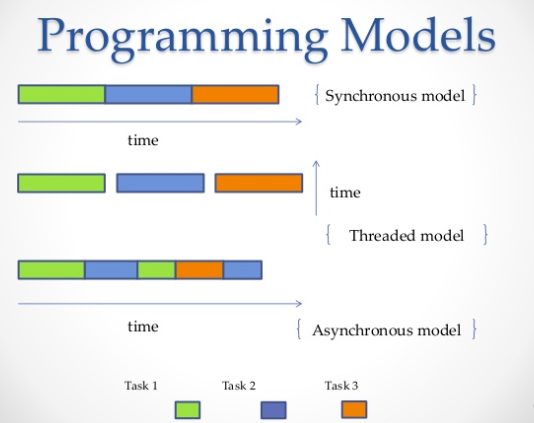
1. Множественные процессы
Самый очевидный способ – это использование нескольких процессов. Из терминала вы можете запустить свой скрипт два, три, четыре, десять раз, и все скрипты будут выполняться независимо и одновременно. Операционная система сама позаботится о распределении ресурсов процессора между всеми экземплярами. В качестве альтернативы вы можете воспользоваться библиотекой multiprocessing, которая умеет порождать несколько процессов, как показано в примере ниже.
2. Множественные потоки
Еще один способ запустить несколько работ параллельно – это использовать потоки. Поток – это очередь выполнения, которая очень похожа на процесс, однако в одном процессе вы можете иметь несколько потоков, и у всех них будет общий доступ к ресурсам. Однако из-за этого написать код потока будет сложно. Аналогично, все тяжелую работу по выделению памяти процессора сделает операционная система, но глобальная блокировка интерпретатора (GIL) позволит только одному потоку Python запускаться в одну единицу времени, даже если у вас есть многопоточный код. Так GIL на CPython предотвращает многоядерную конкурентность. То есть вы насильно можете запуститься только на одном ядре, даже если у вас их два, четыре или больше.
3. Корутины и yield :
Корутины – это обобщение подпрограмм. Они используются для кооперативной многозадачности, когда процесс добровольно отдает контроль ( yield ) с какой-то периодичностью или в периоды ожидания, чтобы позволить нескольким приложениям работать одновременно. Корутины похожи на генераторы, но с дополнительными методами и небольшими изменениями в том, как мы используем оператор yield. Генераторы производят данные для итерации, в то время как корутины могут еще и потреблять данные.
4. Асинхронное программирование
Четвертый способ – это асинхронное программирование, в котором не участвует операционная система. Со стороны операционной системы у вас останется один процесс, в котором будет всего один поток, но вы все еще сможете выполнять одновременно несколько задач. Так в чем тут фокус?
Asyncio – модуль асинхронного программирования, который был представлен в Python 3.4. Он предназначен для использования корутин и future для упрощения написания асинхронного кода и делает его почти таким же читаемым, как синхронный код, из-за отсутствия callback-ов.
Asyncio использует разные конструкции: event loop , корутины и future .
- event loop управляет и распределяет выполнение различных задач. Он регистрирует их и обрабатывает распределение потока управления между ними. (о которых мы говорили выше) – это специальные функции, работа которых схожа с работой генераторов в Python, с помощью await они возвращают поток управления обратно в event loop. Запуск корутины должен быть запланирован в event loop. Запланированные корутины будут обернуты в Tasks, что является типом Future.
- Future отражает результат таска, который может или не может быть выполнен. Результатом может быть exception.
Переключение контекста в asyncio представляет собой event loop , который передает поток управления от одной корутины к другой.
В следующем примере, мы запускаем 3 асинхронных таска, которые по-отдельности делают запросы к Reddit, извлекают и выводят содержимое JSON. Мы используем aiohttp – клиентскую библиотеку http, которая гарантирует, что даже HTTP-запрос будет выполнен асинхронно.
Использование Redis и Redis Queue RQ
Использование asyncio и aiohttp не всегда хорошая идея, особенно если вы пользуетесь более старыми версиями Python. К тому же, бывают моменты, когда вам нужно распределить задачи по разным серверам. В этом случае можно использовать RQ (Redis Queue). Это обычная библиотека Python для добавления работ в очередь и обработки их воркерами в фоновом режиме. Для организации очереди используется Redis – база данных ключей/значений.
В примере ниже мы добавили в очередь простую функцию count_words_at_url с помощью Redis.
Заключение
В качестве примера возьмем шахматную выставку, где один из лучших шахматистов соревнуется с большим количеством людей. У нас есть 24 игры и 24 человека, с которыми можно сыграть, и, если шахматист будет играть с ними синхронно, это займет не менее 12 часов (при условии, что средняя игра занимает 30 ходов, шахматист продумывает ход в течение 5 секунд, а противник – примерно 55 секунд.) Однако в асинхронном режиме шахматист сможет делать ход и оставлять противнику время на раздумья, тем временем переходя к следующему противнику и деля ход. Таким образом, сделать ход во всех 24 играх можно за 2 минуты, и выиграны они все могут быть всего за один час.
Это и подразумевается, когда говорят о том, что асинхронность ускоряет работу. О такой быстроте идет речь. Хороший шахматист не начинает играть в шахматы быстрее, просто время более оптимизировано, и оно не тратится впустую на ожидание. Так это работает.
По этой аналогии шахматист будет процессором, а основная идея будет заключаться в том, чтобы процессор простаивал как можно меньше времени. Речь о том, чтобы у него всегда было занятие.
На практике асинхронность определяется как стиль параллельного программирования, в котором одни задачи освобождают процессор в периоды ожидания, чтобы другие задачи могли им воспользоваться. В Python есть несколько способов достижения параллелизма, отвечающих вашим требованиям, потоку кода, обработке данных, архитектуре и вариантам использования, и вы можете выбрать любой из них.
Параллельная обработка в Python
Когда вы запускаете программу на своем компьютере, она запускается в своем собственном «пузыре», который полностью отделен от других программ, которые активны в то же время. Этот «пузырь» называется процессом и включает в себя все, что необходимо для управления этим вызовом программы.
Эта так называемая среда процесса включает в себя страницы памяти, которые использует процесс, обрабатываемый этим процессом файл, права доступа пользователей и групп, а также весь вызов командной строки, включая заданные параметры.
Эта информация хранится в файловой системе процесса вашей системы UNIX/Linux, которая является виртуальной файловой системой и доступна через каталог proc. Записи сортируются по идентификатору процесса, который уникален для каждого процесса. Пример 1 показывает это для произвольно выбранного процесса с идентификатором # 177.
Пример 1: информация, доступная процессу
Структурирование программного кода и данных
- Один процесс охватывает фрагмент кода, который можно запускать отдельно.
- Некоторые участки кода могут выполняться одновременно, что в принципе допускает распараллеливание.
- Использование возможностей современных процессоров и операционных систем, например каждого доступного ядра процессора, для сокращения общего времени выполнения программы.
- Чтобы снизить сложность вашей программы или кода и передать часть работы специализированным агентам, выступающим в качестве подпроцессов.
Использование подпроцессов требует от вас переосмысления способа выполнения вашей программы, от линейного к параллельному. Это похоже на изменение вашей рабочей точки зрения в компании с обычного работника на менеджера – вам нужно будет следить за тем, кто что делает, сколько времени занимает один шаг и каковы зависимости между промежуточными результатами.
- Почему вы хотите распараллеливать код? Имеет ли смысл думать об этом в вашем конкретном случае и с точки зрения усилий?
- Ваша программа предназначена для запуска только один раз или она будет запускаться регулярно с аналогичным набором данных?
- Можете ли вы разделить свой алгоритм на несколько этапов выполнения?
- Допускают ли ваши данные вообще распараллеливание? Если еще нет, то каким образом нужно адаптировать организацию ваших данных?
- Какие промежуточные результаты ваших вычислений зависят друг от друга?
- Какое изменение оборудования необходимо для этого?
- Есть ли узкое место в аппаратном обеспечении или алгоритме, и как можно избежать или минимизировать влияние этих факторов?
- Какие еще побочные эффекты распараллеливания могут возникнуть?
Возможный вариант использования – это основной процесс и демон, работающий в фоновом режиме (ведущий или ведомый), ожидающий активации. Кроме того, это может быть главный процесс, запускающий рабочие процессы, выполняемые по запросу. На практике основной процесс – это процесс подачи, который управляет двумя или более агентами, которым подаются части данных, и которые выполняют вычисления для данной части.
Имейте в виду, что распараллеливание требует больших затрат и времени из-за накладных расходов на подпроцессы, которые необходимы вашей операционной системе. По сравнению с выполнением двух или более задач линейным способом, выполняя это параллельно, вы можете сэкономить от 25 до 30 процентов времени на подпроцесс, в зависимости от вашего варианта использования.
Например, две задачи, каждая из которых занимает 5 секунд, требуют в сумме 10 секунд при последовательном выполнении и могут потребовать в среднем около 8 секунд на многоядерной машине при распараллеливании. 3 из этих 8 секунд могут быть потеряны из-за накладных расходов, что ограничит ваши улучшения скорости.
Запуск функции параллельно с Python
Python предлагает четыре возможных способа справиться с этим. Во-первых, вы можете выполнять функции параллельно, используя модуль многопроцессорности. Во-вторых, альтернативой процессам являются потоки. Технически это легкие процессы, выходящие за рамки данной статьи.
Для дальнейшего чтения вы можете взглянуть на модуль потоковой передачи Python. В-третьих, вы можете вызывать внешние программы с помощью метода system() модуля os или методов, предоставляемых модулем подпроцесса, и впоследствии собирать результаты.
Модуль многопроцессорности предлагает хороший набор методов для параллельного выполнения подпрограмм. Сюда входят процессы, пулы агентов, очереди и каналы.
Пример 1 работает с пулом из пяти агентов, которые обрабатывают блок из трех значений одновременно. Значения количества агентов и размера фрагмента выбраны произвольно в демонстрационных целях. Отрегулируйте эти значения в соответствии с количеством ядер в вашем процессоре.
Метод Pool.map() требует трех параметров – функции, вызываемой для каждого элемента набора данных, самого набора данных и размера фрагмента. В примере 1 мы используем функцию с именем square, которая вычисляет квадрат заданного целочисленного значения. Кроме того, можно не указывать размер фрагмента. Если не задан явно, размер блока по умолчанию равен 1.
Обратите внимание, что порядок выполнения агентов не гарантируется, но набор результатов находится в правильном порядке. Он содержит квадратные значения в соответствии с порядком элементов исходного набора данных.
Пример 1
Выполнение этого кода должно привести к следующему результату:
Примечание. Для этих примеров мы будем использовать Python 3.
Запуск нескольких функций с использованием очереди
Как структура данных, очередь очень распространена и существует несколькими способами. Он организован как «первым пришел – первым обслужен» (FIFO) или «последним пришел – первым обслужен» (LIFO), а также с приоритетами и без них (очередь с приоритетами). Структура данных реализована, как массив с фиксированным количеством записей или как список, содержащий переменное количество отдельных элементов.
В примерах 2.1–2.7 мы используем очередь FIFO. Он реализован в виде списка, который уже предоставлен соответствующим классом из модуля многопроцессорности. Кроме того, загружается модуль time, который используется для имитации рабочей нагрузки.
Листинг 2.1: используемые модули
Затем определяется рабочая функция (пример 2.2). Эта функция фактически представляет агента и требует трех аргументов. Имя процесса указывает, что это за процесс, а задачи и результаты относятся к соответствующей очереди.
Внутри рабочей функции находится бесконечный цикл while. И задачи, и результаты – это очереди, которые определены в основной программе. tasks.get() возвращает текущую задачу из очереди задач для обработки. Значение задачи меньше 0 выходит из цикла while и возвращает значение -1. Любое другое значение задачи выполнит вычисление (квадрат) и вернет это значение. Возврат значения в основную программу реализован, как results.put(). Это добавляет вычисленное значение в конец очереди результатов.
Листинг 2.2: рабочая функция
Следующим шагом является основной цикл. Сначала определяется менеджер для межпроцессного взаимодействия (IPC). Затем добавляются две очереди – одна для задач, а другая для результатов.
Пример 2.3: IPC и очереди
После такой настройки мы определяем пул процессов с четырьмя рабочими процессами (агентами). Мы используем класс multiprocessing.Pool() и создаем его экземпляр. Затем мы определяем пустой список процессов.
Пример 2.4: определение пула процессов
На следующем шаге мы запускаем четыре рабочих процесса (агента). Для простоты они называются от «P0» до «P3». Создание четырех рабочих процессов выполняется с помощью multiprocessing.Process(). Это связывает каждый из них с рабочей функцией, а также с задачей и очередью результатов. Наконец, мы добавляем вновь инициализированный процесс в конец списка процессов и запускаем новый процесс с помощью new_process.start().
Пример 2.5: подготовка рабочих процессов
Наши рабочие процессы ждут работы. Мы определяем список задач, которые в нашем случае являются произвольно выбранными целыми числами. Эти значения добавляются в список задач с помощью tasks.put(). Каждый рабочий процесс ожидает выполнения задач и выбирает следующую доступную задачу из списка задач. Этим занимается сама очередь.
Пример 2.6: подготовка очереди задач
Через некоторое время мы хотим, чтобы наши агенты закончили. Каждый рабочий процесс реагирует на задачу со значением -1. Он интерпретирует это значение, как сигнал завершения и после этого завершается. Вот почему мы помещаем в очередь задач столько -1, сколько у нас запущенных процессов. Перед завершением процесс помещает -1 в очередь результатов. Это должно быть сигналом подтверждения для основного цикла, что агент завершает работу.
В основном цикле мы читаем из этой очереди и подсчитываем число -1. Основной цикл завершается, как только мы посчитаем столько подтверждений завершения, сколько у нас есть процессов. В противном случае выводим результат расчета из очереди.
Пример 2.7: завершение и вывод результатов
В примере 2 показан вывод программы Python. Запуская программу несколько раз, вы можете заметить, что порядок, в котором запускаются рабочие процессы, столь же непредсказуем, как и сам процесс, выбирающий задачу из очереди. Однако после завершения порядок элементов очереди результатов совпадает с порядком элементов очереди задач.
Пример 3
Примечание. Как упоминалось ранее, ваш вывод может не точно совпадать с показанным выше, поскольку порядок выполнения непредсказуем.
Использование метода os.system()
Метод system() является частью модуля os, который позволяет выполнять внешние программы командной строки в отдельном процессе от вашей программы Python. Метод system() – это блокирующий вызов, и вам нужно дождаться завершения вызова и возврата. Как вы знаете, что команду можно запускать в фоновом режиме и записывать вычисленный результат в выходной поток, который перенаправляется в такой файл.
Пример 4: команда с перенаправлением вывода
В программе Python вы просто инкапсулируете этот вызов, как показано ниже.
Пример 4: системный вызов с использованием модуля os
Этот системный вызов создает процесс, который выполняется параллельно вашей текущей программе Python. Получение результата может стать немного сложным, потому что этот вызов может завершиться после отключения программы Python – вы никогда не узнаете.
Использование этого метода намного дороже, чем предыдущие методы, которые я описал. Во-первых, накладные расходы намного больше (переключение процесса), а во-вторых, данные записываются в физическую память, например на диск, что занимает больше времени. Хотя это лучший вариант, у вас ограниченная память (например, с ОЗУ), и вместо этого вы можете записывать большие выходные данные на твердотельный диск.
Использование модуля subprocess
Этот модуль предназначен для замены вызовов os.system() и os.spawn(). Идея подпроцесса состоит в том, чтобы упростить процессы порождения, общаться с ними через каналы и сигналы и собирать вывод, который они производят, включая сообщения об ошибках.
Начиная с Python 3.5, подпроцесс содержит метод subprocess.run() для запуска внешней команды, которая является оболочкой для базового класса subprocess.Popen(). В качестве примера мы запускаем команду U или NIX Linux df -h, чтобы узнать, сколько дискового пространства все еще доступно в разделе home. В программе Python вы выполняете этот вызов, как показано ниже.
Пример 5: базовый пример запуска внешней команды
Это основной вызов, очень похожий на команду df -h или home, выполняемую в терминале. Обратите внимание, что параметры разделены списком, а не одной строкой. Вывод будет аналогичен примеру 5. По сравнению с официальной документацией Python для этого модуля, он выводит результат вызова stdout в дополнение к возвращаемому значению вызова.
В примере 5 показан результат нашего вызова. Последняя строка вывода показывает успешное выполнение команды. Вызов subprocess.run() возвращает экземпляр класса CompletedProcess, который имеет два атрибута с именами args (аргументы командной строки) и код возврата (возвращаемое значение команды).
Пример 6: запуск скрипта
Чтобы подавить вывод на стандартный вывод и перехватить вывод и возвращаемое значение для дальнейшей оценки, вызов subprocess.run() должен быть немного изменен. Без дальнейших изменений subprocess.run() отправляет вывод выполненной команды на stdout, который является каналом вывода базового процесса в Python. Чтобы получить вывод, мы должны изменить это и установить канал вывода на предварительно определенное значение subprocess.PIPE.
Пример 7: захват вывода в конвейер
Как объяснялось ранее, subprocess.run() возвращает экземпляр класса CompletedProcess. В примере этот экземпляр представляет собой переменную с простым именем output. Код возврата команды сохраняется в атрибуте output.returncode, а вывод, выводимый на стандартный вывод, можно найти в атрибуте output.stdout. Имейте в виду, что это не касается обработки сообщений об ошибках, потому что мы не меняли для этого выходной канал.
Заключение
Параллельная обработка данных – прекрасная возможность использовать мощь современного оборудования. Python предоставляет вам доступ к этим методам на очень сложном уровне. Как вы уже видели ранее, модуль multiprocessing и subprocess позволяет легко погрузиться в эту тему.
(Решено) как в пайтон запустить несколько программ одновременно…
Python – это интерпретируемый язык программирования, который позволяет создавать разнообразные приложения и скрипты. Возможность запуска нескольких программ одновременно в Python предоставляются механизмом многопоточности, который имеет следующие преимущества:
1. Эффективное использование процессорного времени – при использовании многопоточности можно запускать несколько фрагментов кода одновременно, что повышает эффективность работы.
2. Упрощенная работа с асинхронными функциями – при запуске нескольких программ одновременно, асинхронные функции сильно упрощаются, так как каждая функция работает в отдельном потоке.
3. Улучшенная возможность распараллеливания вычислений – многопоточная обработка позволяет повысить скорость работы приложений, когда одновременно работают несколько потоков, обрабатывающих данные.
Для запуска нескольких программ одновременно в Python можно использовать библиотеку threading, которая предоставляет удобные и простые способы многопоточности. Вот несколько примеров использования этой библиотеки:
1. Пример запуска нескольких функций в разных потоках:
def count_up(upper_limit):
for i in range(upper_limit):
print(«Count up:», i)
def count_down(lower_limit):
for i in range(lower_limit, 0, -1):
print(«Count down:», i)
t1 = threading.Thread(target=count_up, args=(5,))
t2 = threading.Thread(target=count_down, args=(5,))
t1.start()
t2.start()
t1.join()
t2.join()
«`
В этом примере мы создали две функции – count_up и count_down, которые считают вверх и вниз соответственно. Далее мы создали два объекта Thread, указав каждый объект функцию, которую он должен выполнить, и передав параметры через args. Затем мы запустили каждый поток и вызвали метод join для ожидания завершения обоих потоков.
2. Пример запуска нескольких экземпляров одного класса в разных потоках:
class Counter:
def __init__(self, upper_limit):
self.upper_limit = upper_limit
def count_up(self):
for i in range(self.upper_limit):
print(«Count up:», i)
def count_down(self):
for i in range(self.upper_limit, 0, -1):
print(«Count down:», i)
c1 = Counter(5)
c2 = Counter(5)
t1 = threading.Thread(target=c1.count_up)
t2 = threading.Thread(target=c2.count_down)
t1.start()
t2.start()
t1.join()
t2.join()
«`
В этом примере мы создали класс Counter, который имеет два метода – count_up и count_down – каждый из которых выполняет свою функцию. Затем мы создали два объекта Counter и два объекта Thread, указав каждый объект функцию, которую он должен выполнить. Затем мы запустили каждый поток и вызвали метод join для ожидания завершения обоих потоков.
3. Пример запуска нескольких скриптов Python с помощью метода os.system:
os.system(«python script1.py &»)
os.system(«python script2.py &»)
«`
В этом примере мы используем метод os.system, который позволяет запускать внешние программы, передавая им команды. Мы запускаем два скрипта Python, указывая их названия – script1.py и script2.py – и добавляя амперсанд в конце, чтобы каждый скрипт работал в отдельном потоке.
Таким образом, Python предоставляет несколько способов запуска нескольких программ одновременно с помощью механизма многопоточности и методов реализации внешних программ. Они значительно упрощают и ускоряют работу программиста, повышают эффективность обработки данных и усиливают функционал многопоточности.
Чтобы оставить комментарий, необходимо авторизоваться.
Задай любой вопрос нейросети!
Для того, чтобы задать вопрос нейросети, необходимо войти на сайт.
Последние вопросы
Искусственный интеллект ChatGPT на русском: полный обзор, возможности и использование
(Решено) решить кейс. Ученик посещает школу хорошо, за исключением одного урока. Говорит что ему там неинтересно.ЗАДАНИЕ КЕЙСА:1. Обозначьте педагогическую з…
(Решено) Напишите аннотацию, ответьте на вопросы:— что пользователь хотел найти, задавая такой запрос?— какая картинка хорошо подойдет под такой запрос, кака…
(Решено) Понятие реабилитации инвалидов, основное содержание и виды реабилитации инвалидов…
(Решено) Даниил, учится в 9-ом классе муниципальной школы, расположенной в крупном городе: «О Российском движении детей и молодежи я узнал случайно от моего др…
(Решено) Используя таксономию Д.Толлингеровой, составьте наборы заданий длявводного и заключительного уроков по определенной теме. Объяснитепринцип выбора за…
(Решено) Во время ссоры в селе Бутузово произошла драка между пятью односельчанами. Один из ее участливо А сбегал домой и взяв топор бросился к дерущимся. Стоя…
(Решено) Составьте перечень педагогических целей конкретного урока по любомупредмет, а также серии уроков по определенной теме, учитывая когнитивную,аффектив…
(Решено) найти или сгенерировать код для регистрации в игре The SIms:3 …
Хотите задать любой вопрос нейросети?
Нажимая «Регистрация» или «Войти через Google», вы соглашаетесь с Публичной офертой, даете Согласие на обработку персональных данных, а также подтверждаете что вам есть 18 лет»
Форма репорта неправомерного контента.
Обратная связь с администрацией проекта
Уведомление об использовании cookie файлов
Наш сайт, как и большинство других, использует файлы cookie и другие похожие технологии (пиксельные тэги и т. п.), чтобы предоставлять услуги, наиболее отвечающие Вашим интересам и потребностям, а также собирать статистическую и маркетинговую информацию для анализа и совершенствования наших услуг и сайтов.
При использовании данного сайта, вы подтверждаете свое согласие на использование файлов cookie и других похожих технологий в соответствии с настоящим Уведомлением.
Если Вы не согласны, чтобы мы использовали данный тип файлов, Вы должны соответствующим образом установить настройки Вашего браузера или не использовать наш сайт.
Обращаем Ваше внимание на то, что при блокировании или удалении cookie файлов, мы не можем гарантировать корректную работу нашего сайта в Вашем браузере.
Cookie файлы, которые сохраняются через веб-сайт, не содержат сведений, на основании которых можно Вас идентифицировать.
Что такое файл cookie и другие похожие технологии
Файл cookie представляет собой небольшой текстовый файл, сохраняемый на вашем компьютере, смартфоне или другом устройстве, которое Вы используете для посещения интернет-сайтов.
Некоторые посещаемые Вами страницы могут также собирать информацию, используя пиксельные тэги и веб-маяки, представляющие собой электронные изображения, называемые одно-пиксельными (1×1) или пустыми GIF-изображениями.
Файлы cookie могут размещаться на вашем устройстве нами («собственные» файлы cookie) или другими операторами (файлы cookie «третьих лиц»).
Мы используем два вида файлов cookie на сайте: «cookie сессии» и «постоянные cookie». Cookie сессии — это временные файлы, которые остаются на устройстве пока вы не покинете сайт. Постоянные cookie остаются на устройстве в течение длительного времени или пока вы вручную не удалите их (как долго cookie останется на вашем устройстве будет зависеть от продолжительности или «времени жизни» конкретного файла и настройки вашего браузера).
Cookie файлы бывают различных типов:
Необходимые. Эти файлы нужны для обеспечения правильной работы сайта, использования его функций. Отключение использования таких файлов приведет к падению производительности сайта, невозможности использовать его компоненты и сервисы.
Файлы cookie, относящиеся к производительности, эффективности и аналитике. Данные файлы позволяют анализировать взаимодействие посетителей с сайтом, оптимизировать содержание сайта, измерять эффективность рекламных кампаний, предоставляя информацию о количестве посетителей сайта, времени его использования, возникающих ошибках.
Функциональные файлы cookie запоминают пользователей, которые уже заходили на наш сайт, их индивидуальные параметры (такие как язык и регион, например) и предпочтения, и помогают индивидуализировать содержание сайта.
Рекламные файлы cookie определяют, какие сайты Вы посещали и как часто, какие ссылки Вы выбирали, что позволяет показывать Вам рекламные объявления, которые заинтересуют именно Вас.
Электронная почта. Мы также можем использовать технологии, позволяющие отслеживать, открывали ли вы, прочитали или переадресовывали определенные сообщения, отправленные нами на вашу электронную почту. Это необходимо, чтобы сделать наши средства коммуникации более полезными для пользователя. Если вы не желаете, чтобы мы получали сведения об этом, вам нужно аннулировать подписку посредством ссылки «Отписаться» («Unsubscribe»), находящейся внизу соответствующей электронной рассылки.
Кнопки доступа к социальным сетям. Они используются для того, чтобы пользователи могли поделиться ссылкой на страницу в социальных сетях или сделать электронную закладку. Данные кнопки являются ссылками на веб-сайты социальных сетей, принадлежащих третьим лицам, которые, в свою, очередь могут фиксировать информацию о вашей активности в интернете, в том числе на нашем сайте. Пожалуйста, ознакомьтесь с соответствующими условиями использования и политикой конфиденциальности таких сайтов для понимания того, как они используют ваши данные, и того, как можно отказаться от использования ими ваших данных или удалить их.
Сторонние веб-сервисы. Иногда на данном сайте мы используем сторонние веб-сервисы. Например, для отображения тех или иных элементов (изображения, видео, презентации и т. п.), организации опросов и т. п. Как и в случае с кнопками доступа к социальным сетям, мы не можем препятствовать сбору этими сайтами или внешними доменами информации о том, как вы используете содержание сайта.
Как управлять файлами cookie?
Большинство интернет-браузеров изначально настроены на автоматический прием файлов cookie.
В любое время Вы можете изменить настройки вашего браузера таким образом, чтобы блокировать файлы cookie или предупреждать вас о том, когда они будут отправляться к вам на устройство (обратитесь к руководству использования конкретного браузера). Отключение файлов cookie может повлиять на Вашу работу в интернете.
Если вы используете несколько устройств и (или) браузеров для доступа в интернет, соответствующие настройки должны быть изменены в каждом из них.
Заключительные положения
По собственному усмотрению мы можем периодически изменять настоящее Уведомление.
По возникающим вопросам с нами можно связаться, используя контакты, размещенные на нашем сайте.