Как в строке найти и вывести все слова, начинающиеся на букву N и слова оканчивающиеся на букву P? [закрыт]
Учебные задания допустимы в качестве вопросов только при условии, что вы пытались решить их самостоятельно перед тем, как задать вопрос. Пожалуйста, отредактируйте вопрос и укажите, что именно вызвало у вас трудности при решении задачи. Например, приведите код, который вы написали, пытаясь решить задачу
Закрыт 2 года назад .
Как в строке найти и вывести все слова, начинающиеся на букву N и слова оканчивающиеся на букву P?
Регулярные выражения в Python от простого к сложному

Регулярное выражение — это строка, задающая шаблон поиска подстрок в тексте. Одному шаблону может соответствовать много разных строчек. Термин «Регулярные выражения» является переводом английского словосочетания «Regular expressions». Перевод не очень точно отражает смысл, правильнее было бы «шаблонные выражения». Регулярное выражение, или коротко «регулярка», состоит из обычных символов и специальных командных последовательностей. Например, \d задаёт любую цифру, а \d+ — задает любую последовательность из одной или более цифр. Работа с регулярками реализована во всех современных языках программирования. Однако существует несколько «диалектов», поэтому функционал регулярных выражений может различаться от языка к языку. В некоторых языках программирования регулярками пользоваться очень удобно (например, в питоне), в некоторых — не слишком (например, в C++).
Примеры регулярных выражений
Регулярные выражения, или коротко, регулярки — это очень мощный инструмент. Но использовать их следует с умом и осторожностью, и только там, где они действительно приносят пользу, а не вред. Во-первых, плохо написанные регулярные выражения работают медленно. Во-вторых, их зачастую очень сложно читать, особенно если регулярка написана не лично тобой пять минут назад. В-третьих, очень часто даже небольшое изменение задачи (того, что требуется найти) приводит к значительному изменению выражения. Поэтому про регулярки часто говорят, что это write only code (код, который только пишут с нуля, но не читают и не правят). А также шутят: Некоторые люди, когда сталкиваются с проблемой, думают «Я знаю, я решу её с помощью регулярных выражений.» Теперь у них две проблемы. Вот пример write-only регулярки (для проверки валидности e-mail адреса (не надо так делать. )):
А вот здесь более точная регулярка для проверки корректности email адреса стандарту RFC822. Если вдруг будете проверять email, то не делайте так!Если адрес вводит пользователь, то пусть вводит почти что угодно, лишь бы там была собака. Надёжнее всего отправить туда письмо и убедиться, что пользователь может его получить.
Документация и ссылки
- Оригинальная документация: https://docs.python.org/3/library/re.html;
- Очень подробный и обстоятельный материал: https://www.regular-expressions.info/;
- Разные сложные трюки и тонкости с примерами: http://www.rexegg.com/;
- Он-лайн отладка регулярок https://regex101.com (не забудьте поставить галочку Python в разделе FLAVOR слева);
- Он-лайн визуализация регулярок https://www.debuggex.com/ (не забудьте выбрать Python);
- Могущественный текстовый редактор Sublime text 3, в котором очень удобный поиск по регуляркам;
Основы синтаксиса
Любая строка (в которой нет символов .^$*+?<>[]\|() ) сама по себе является регулярным выражением. Так, выражению Хаха будет соответствовать строка “Хаха” и только она. Регулярные выражения являются регистрозависимыми, поэтому строка “хаха” (с маленькой буквы) уже не будет соответствовать выражению выше. Подобно строкам в языке Python, регулярные выражения имеют спецсимволы .^$*+?<>[]\|() , которые в регулярках являются управляющими конструкциями. Для написания их просто как символов требуется их экранировать, для чего нужно поставить перед ними знак \ . Так же, как и в питоне, в регулярных выражения выражение \n соответствует концу строки, а \t — табуляции.
Шаблоны, соответствующие одному символу
Во всех примерах ниже соответствия регулярному выражению выделяются бирюзовым цветом с подчёркиванием.
Квантификаторы (указание количества повторений)
Жадность в регулярках и границы найденного шаблона
Как указано выше, по умолчанию квантификаторы жадные. Этот подход решает очень важную проблему — проблему границы шаблона. Скажем, шаблон \d+ захватывает максимально возможное количество цифр. Поэтому можно быть уверенным, что перед найденным шаблоном идёт не цифра, и после идёт не цифра. Однако если в шаблоне есть не жадные части (например, явный текст), то подстрока может быть найдена неудачно. Например, если мы хотим найти «слова», начинающиеся на СУ , после которой идут цифры, при помощи регулярки СУ\d* , то мы найдём и неправильные шаблоны:
В тех случаях, когда это важно, условие на границу шаблона нужно обязательно добавлять в регулярку. О том, как это можно делать, будет дальше.
Пересечение подстрок
В обычной ситуации регулярки позволяют найти только непересекающиеся шаблоны. Вместе с проблемой границы слова это делает их использование в некоторых случаях более сложным. Например, если мы решим искать e-mail адреса при помощи неправильной регулярки \w+@\w+ (или даже лучше, [\w'._+-]+@[\w'._+-]+ ), то в неудачном случае найдём вот что:
То есть это с одной стороны и не e-mail, а с другой стороны это не все подстроки вида текст-собака-текст , так как boo@goo и moo@roo пропущены.
Эксперименты в песочнице
Если вы впервые сталкиваетесь с регулярными выражениями, то лучше всего сначала попробовать песочницу. Посмотрите, как работают простые шаблоны и квантификаторы. Решите следующие задачи для этого текста (возможно, к части придётся вернуться после следующей теории):
- Найдите все натуральные числа (возможно, окружённые буквами);
- Найдите все «слова», написанные капсом (то есть строго заглавными), возможно внутри настоящих слов (аааБББввв);
- Найдите слова, в которых есть русская буква, а когда-нибудь за ней цифра;
- Найдите все слова, начинающиеся с русской или латинской большой буквы ( \b — граница слова);
- Найдите слова, которые начинаются на гласную ( \b — граница слова);;
- Найдите все натуральные числа, не находящиеся внутри или на границе слова;
- Найдите строчки, в которых есть символ * ( . — это точно не конец строки!);
- Найдите строчки, в которых есть открывающая и когда-нибудь потом закрывающая скобки;
- Выделите одним махом весь кусок оглавления (в конце примера, вместе с тегами);
- Выделите одним махом только текстовую часть оглавления, без тегов;
- Найдите пустые строчки;
Регулярки в питоне
Функции для работы с регулярками живут в модуле re . Основные функции:
Пример использования всех основных функций
Тонкости экранирования в питоне ( '\\\\\\\\foo' )
Так как символ \ в питоновских строках также необходимо экранировать, то в результате в шаблонах могут возникать конструкции вида '\\\\par' . Первый слеш означает, что следующий за ним символ нужно оставить «как есть». Третий также. В результате с точки зрения питона '\\\\' означает просто два слеша \\ . Теперь с точки зрения движка регулярных выражений, первый слеш экранирует второй. Тем самым как шаблон для регулярки '\\\\par' означает просто текст \par . Для того, чтобы не было таких нагромождений слешей, перед открывающей кавычкой нужно поставить символ r , что скажет питону «не рассматривай \ как экранирующий символ (кроме случаев экранирования открывающей кавычки)». Соответственно можно будет писать r'\\par' .
Использование дополнительных флагов в питоне
Каждой из функций, перечисленных выше, можно дать дополнительный параметр flags , что несколько изменит режим работы регулярок. В качестве значения нужно передать сумму выбранных констант, вот они:
Написание и тестирование регулярных выражений
Для написания и тестирования регулярных выражений удобно использовать сервис https://regex101.com (не забудьте поставить галочку Python в разделе FLAVOR слева) или текстовый редактор Sublime text 3.
Скобочные группы (. ) и перечисления |
Перечисления (операция «ИЛИ»)
Чтобы проверить, удовлетворяет ли строка хотя бы одному из шаблонов, можно воспользоваться аналогом оператора or , который записывается с помощью символа | . Так, некоторая строка подходит к регулярному выражению A|B тогда и только тогда, когда она подходит хотя бы к одному из регулярных выражений A или B . Например, отдельные овощи в тексте можно искать при помощи шаблона морковк|св[её]кл|картошк|редиск .
Скобочные группы (группировка плюс квантификаторы)
Зачастую шаблон состоит из нескольких повторяющихся групп. Так, MAC-адрес сетевого устройства обычно записывается как шесть групп из двух шестнадцатиричных цифр, разделённых символами — или : . Например, 01:23:45:67:89:ab . Каждый отдельный символ можно задать как [0-9a-fA-F] , и можно весь шаблон записать так:
[0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]
Ситуация становится гораздо сложнее, когда количество групп заранее не зафиксировано.
Чтобы разрешить эту проблему в синтаксисе регулярных выражений есть группировка (. ) . Можно писать круглые скобки и без значков ?: , однако от этого у группировки значительно меняется смысл, регулярка начинает работать гораздо медленнее. Об этом будет написано ниже. Итак, если REGEXP — шаблон, то (?:REGEXP) — эквивалентный ему шаблон. Разница только в том, что теперь к (?:REGEXP) можно применять квантификаторы, указывая, сколько именно раз должна повториться группа. Например, шаблон для поиска MAC-адреса, можно записать так:
[0-9a-fA-F]<2>(?:[:-][0-9a-fA-F]<2>)
Скобки плюс перечисления
Также скобки (. ) позволяют локализовать часть шаблона, внутри которой происходит перечисление. Например, шаблон (?:он|тот) (?:шёл|плыл) соответствует каждой из строк «он шёл», «он плыл», «тот шёл», «тот плыл», и является синонимом он шёл|он плыл|тот шёл|тот плыл .
Ещё примеры
Группирующие скобки (. ) и match -объекты в питоне
Match-объекты
Если функции re.search , re.fullmatch не находят соответствие шаблону в строке, то они возвращают None , функция re.finditer не выдаёт ничего. Однако если соответствие найдено, то возвращается match -объект. Эта штука содержит в себе кучу полезной информации о соответствии шаблону. Полный набор атрибутов можно посмотреть в документации, а здесь приведём самое полезное.
Группирующие скобки (. )
Если в шаблоне регулярного выражения встречаются скобки (. ) без ?: , то они становятся группирующими. В match-объекте, который возвращают re.search , re.fullmatch и re.finditer , по каждой такой группе можно получить ту же информацию, что и по всему шаблону. А именно часть подстроки, которая соответствует (. ) , а также индексы начала и окончания в исходной строке. Достаточно часто это бывает полезно.
Тонкости со скобками и нумерацией групп.
Если к группирующим скобкам применён квантификатор (то есть указано число повторений), то подгруппа в match-объекте будет создана только для последнего соответствия. Например, если бы в примере выше квантификаторы были снаружи от скобок '\s*([А-Яа-яЁё])+(\d)+\s*' , то вывод был бы таким:
Внутри группирующих скобок могут быть и другие группирующие скобки. В этом случае их нумерация производится в соответствии с номером появления открывающей скобки с шаблоне.
Группы и re.findall
Если в шаблоне есть группирующие скобки, то вместо списка найденных подстрок будет возвращён список кортежей, в каждом из которых только соответствие каждой группе. Это не всегда происходит по плану, поэтому обычно нужно использовать негруппирующие скобки (. ) .
Группы и re.split
Если в шаблоне нет группирующих скобок, то re.split работает очень похожим образом на str.split . А вот если группирующие скобки в шаблоне есть, то между каждыми разрезанными строками будут все соответствия каждой из подгрупп.
В некоторых ситуация эта возможность бывает чрезвычайно удобна! Например, достаточно из предыдущего примера убрать лишние группы, и польза сразу станет очевидна!
Использование групп при заменах
Использование групп добавляет замене ( re.sub , работает не только в питоне, а почти везде) очень удобную возможность: в шаблоне для замены можно ссылаться на соответствующую группу при помощи \1, \2, \3, . . Например, если нужно даты из неудобного формата ММ/ДД/ГГГГ перевести в удобный ДД.ММ.ГГГГ, то можно использовать такую регулярку:
Если групп больше 9, то можно ссылаться на них при помощи конструкции вида \g<12> .
Замена с обработкой шаблона функцией в питоне
Ещё одна питоновская фича для регулярных выражений: в функции re.sub вместо текста для замены можно передать функцию, которая будет получать на вход match-объект и должна возвращать строку, на которую и будет произведена замена. Это позволяет не писать ад в шаблоне для замены, а использовать удобную функцию. Например, «зацензурим» все слова, начинающиеся на букву «Х»:
Ссылки на группы при поиске
При помощи \1, \2, \3, . и \g<12> можно ссылаться на найденную группу и при поиске. Необходимость в этом встречается довольно редко, но это бывает полезно при обработке простых xml и html.
Только пообещайте, что не будете парсить сложный xml и тем более html при помощи регулярок! Регулярные выражения для этого не подходят. Используйте другие инструменты. Каждый раз, когда неопытный программист парсит html регулярками, в мире умирает котёнок. Если кажется «Да здесь очень простой html, напишу регулярку», то сразу вспоминайте шутку про две проблемы. Не нужно пытаться парсить html регулярками, даже Пётр Митричев не сможет это сделать в общем случае 🙂 Использование регулярных выражений при парсинге html подобно залатыванию резиновой лодки шилом. Закон Мёрфи для парсинга html и xml при помощи регулярок гласит: парсинг html и xml регулярками иногда работает, но в точности до того момента, когда правильность результата будет очень важна.
Шаблоны, соответствующие не конкретному тексту, а позиции
Отдельные части регулярного выражения могут соответствовать не части текста, а позиции в этом тексте. То есть такому шаблону соответствует не подстрока, а некоторая позиция в тексте, как бы «между» буквами.
Простые шаблоны, соответствующие позиции
Для определённости строку, в которой мы ищем шаблон будем называть всем текстом.Каждую строчку всего текста (то есть каждый максимальный кусок без символов конца строки) будем называть строчкой текста.
Сложные шаблоны, соответствующие позиции (lookaround и Co)
Следующие шаблоны применяются в основном в тех случаях, когда нужно уточнить, что должно идти непосредственно перед или после шаблона, но при этом не включать найденное в match-объект.
На всякий случай ещё раз. Каждый их этих шаблонов проверяет лишь то, что идёт непосредственно перед позицией или непосредственно после позиции. Если пару таких шаблонов написать рядом, то проверки будут независимы (то есть будут соответствовать AND в каком-то смысле).
lookaround на примере королей и императоров Франции
Людовик(?=VI) — Людовик, за которым идёт VI
КарлIV, КарлIX, КарлV, КарлVI, КарлVII, КарлVIII,
ЛюдовикIX, ЛюдовикVI, ЛюдовикVII, ЛюдовикVIII, ЛюдовикX, …, ЛюдовикXVIII,
ФилиппI, ФилиппII, ФилиппIII, ФилиппIV, ФилиппV, ФилиппVI
Людовик(?!VI) — Людовик, за которым идёт не VI
КарлIV, КарлIX, КарлV, КарлVI, КарлVII, КарлVIII,
ЛюдовикIX, ЛюдовикVI, ЛюдовикVII, ЛюдовикVIII, ЛюдовикX, …, ЛюдовикXVIII,
ФилиппI, ФилиппII, ФилиппIII, ФилиппIV, ФилиппV, ФилиппVI
(?<=Людовик)VI — «шестой», но только если Людовик
КарлIV, КарлIX, КарлV, КарлVI, КарлVII, КарлVIII,
ЛюдовикIX, ЛюдовикVI, ЛюдовикVII, ЛюдовикVIII, ЛюдовикX, …, ЛюдовикXVIII,
ФилиппI, ФилиппII, ФилиппIII, ФилиппIV, ФилиппV, ФилиппVI
(?<!Людовик)VI — «шестой», но только если не Людовик
КарлIV, КарлIX, КарлV, КарлVI, КарлVII, КарлVIII,
ЛюдовикIX, ЛюдовикVI, ЛюдовикVII, ЛюдовикVIII, ЛюдовикX, …, ЛюдовикXVIII,
ФилиппI, ФилиппII, ФилиппIII, ФилиппIV, ФилиппV, ФилиппVI
Регулярные выражения в Python от простого к сложному
Решил я давеча моим школьникам дать задачек на регулярные выражения для изучения. А к задачкам нужна какая-нибудь теория. И стал я искать хорошие тексты на русском. Пяток сносных нашёл, но всё не то. Что-то смято, что-то упущено. У этих текстов был не только фатальный недостаток. Мало картинок, мало примеров. И почти нет разумных задач. Ну неужели поиск IP-адреса — это самая частая задача для регулярных выражений? Вот и я думаю, что нет.
Про разницу (. ) / (. ) фиг найдёшь, а без этого знания в некоторых случаях можно только страдать.
Плюс в питоне есть немало регулярных плюшек. Например, re.split может добавлять тот кусок текста, по которому был разрез, в список частей. А в re.sub можно вместо шаблона для замены передать функцию. Это — реальные вещи, которые прямо очень нужны, но никто про это не пишет.
Так и родился этот достаточно многобуквенный материал с подробностями, тонкостями, картинками и задачами.
Надеюсь, вам удастся из него извлечь что-нибудь новое и полезное, даже если вы уже в ладах с регулярками.
PS. Решения задач школьники сдают в тестирующую систему, поэтому задачи оформлены в несколько формальном виде.
Содержание
Регулярное выражение — это строка, задающая шаблон поиска подстрок в тексте. Одному шаблону может соответствовать много разных строчек. Термин «Регулярные выражения» является переводом английского словосочетания «Regular expressions». Перевод не очень точно отражает смысл, правильнее было бы «шаблонные выражения». Регулярное выражение, или коротко «регулярка», состоит из обычных символов и специальных командных последовательностей. Например, \d задаёт любую цифру, а \d+ — задает любую последовательность из одной или более цифр. Работа с регулярками реализована во всех современных языках программирования. Однако существует несколько «диалектов», поэтому функционал регулярных выражений может различаться от языка к языку. В некоторых языках программирования регулярками пользоваться очень удобно (например, в питоне), в некоторых — не слишком (например, в C++).
Примеры регулярных выражений
| Регулярка | Её смысл |
|---|---|
| simple text | В точности текст «simple text» |
| \d | Последовательности из 5 цифр \d означает любую цифру <5>— ровно 5 раз |
| \d\d/\d\d/\d | Даты в формате ДД/ММ/ГГГГ (и прочие куски, на них похожие, например, 98/76/5432) |
| \b\w<3>\b | Слова в точности из трёх букв \b означает границу слова (с одной стороны буква, а с другой — нет) \w — любая буква, <3>— ровно три раза |
| [-+]?\d+ | Целое число, например, 7, +17, -42, 0013 (возможны ведущие нули) [-+]? — либо -, либо +, либо пусто \d+ — последовательность из 1 или более цифр |
| [-+]?(?:\d+(?:\.\d*)?|\.\d+)(?:[eE][-+]?\d+)? | Действительное число, возможно в экспоненциальной записи Например, 0.2, +5.45, -.4, 6e23, -3.17E-14. См. ниже картинку. |

Сила и ответственность
Регулярные выражения, или коротко, регулярки — это очень мощный инструмент. Но использовать их следует с умом и осторожностью, и только там, где они действительно приносят пользу, а не вред. Во-первых, плохо написанные регулярные выражения работают медленно. Во-вторых, их зачастую очень сложно читать, особенно если регулярка написана не лично тобой пять минут назад. В-третьих, очень часто даже небольшое изменение задачи (того, что требуется найти) приводит к значительному изменению выражения. Поэтому про регулярки часто говорят, что это write only code (код, который только пишут с нуля, но не читают и не правят). А также шутят: Некоторые люди, когда сталкиваются с проблемой, думают «Я знаю, я решу её с помощью регулярных выражений.» Теперь у них две проблемы. Вот пример write-only регулярки (для проверки валидности e-mail адреса (не надо так делать. )):
А вот здесь более точная регулярка для проверки корректности email адреса стандарту RFC822. Если вдруг будете проверять email, то не делайте так!Если адрес вводит пользователь, то пусть вводит почти что угодно, лишь бы там была собака. Надёжнее всего отправить туда письмо и убедиться, что пользователь может его получить.
Документация и ссылки
- Оригинальная документация: https://docs.python.org/3/library/re.html;
- Очень подробный и обстоятельный материал: https://www.regular-expressions.info/;
- Разные сложные трюки и тонкости с примерами: http://www.rexegg.com/;
- Он-лайн отладка регулярок https://regex101.com (не забудьте поставить галочку Python в разделе FLAVOR слева);
- Он-лайн визуализация регулярок https://www.debuggex.com/ (не забудьте выбрать Python);
- Могущественный текстовый редактор Sublime text 3, в котором очень удобный поиск по регуляркам;
Основы синтаксиса
Любая строка (в которой нет символов .^$*+?<>[]\|() ) сама по себе является регулярным выражением. Так, выражению Хаха будет соответствовать строка “Хаха” и только она. Регулярные выражения являются регистрозависимыми, поэтому строка “хаха” (с маленькой буквы) уже не будет соответствовать выражению выше. Подобно строкам в языке Python, регулярные выражения имеют спецсимволы .^$*+?<>[]\|() , которые в регулярках являются управляющими конструкциями. Для написания их просто как символов требуется их экранировать, для чего нужно поставить перед ними знак \ . Так же, как и в питоне, в регулярных выражениях выражение \n соответствует концу строки, а \t — табуляции.
Шаблоны, соответствующие одному символу
| Шаблон | Описание | Пример | Применяем к тексту |
|---|---|---|---|
| . | Один любой символ, кроме новой строки \n . | м.л.ко | молоко , малако , И м0л0ко Ихлеб |
| \d | Любая цифра | СУ\d\d | СУ35 , СУ11 1, АЛ СУ14 |
| \D | Любой символ, кроме цифры | 926\D123 | 926)123 , 1 926-123 4 |
| \s | Любой пробельный символ (пробел, табуляция, конец строки и т.п.) | бор\sода | бор ода , бор ода , борода |
| \S | Любой непробельный символ | \S123 | X123 , я123 , !123 456, 1 + 123456 |
| \w | Любая буква (то, что может быть частью слова), а также цифры и _ | \w\w\w | Год , f_3 , qwe rt |
| \W | Любая не-буква, не-цифра и не подчёркивание | сом\W | сом! , сом? |
| [..] | Один из символов в скобках, а также любой символ из диапазона a-b |
[0-9][0-9A-Fa-f] | 12 , 1F , 4B |
| [^..] | Любой символ, кроме перечисленных | <[^>]> | <1> , <a> , <>> |
| \d≈[0-9], \D≈[^0-9], \w≈[0-9a-zA-Z а-яА-ЯёЁ], \s≈[ \f\n\r\t\v] |
Буква “ё” не включается в общий диапазон букв! Вообще говоря, в \d включается всё, что в юникоде помечено как «цифра», а в \w — как буква. Ещё много всего! |
||
| [abc-], [-1] | если нужен минус, его нужно указать последним или первым | ||
| [*[(+\\\]\t] | внутри скобок нужно экранировать только ] и \ | ||
| \b | Начало или конец слова (слева пусто или не-буква, справа буква и наоборот). В отличие от предыдущих соответствует позиции, а не символу |
\bвал | вал , перевал, Перевалка |
| \B | Не граница слова: либо и слева, и справа буквы, либо и слева, и справа НЕ буквы |
\Bвал | пере вал , вал, Пере вал ка |
| \Bвал\B | перевал, вал, Пере вал ка |
Квантификаторы (указание количества повторений)
| Шаблон | Описание | Пример | Применяем к тексту |
|---|---|---|---|
| Ровно n повторений | \d | 1, 12, 123, 1234 , 12345 | |
| От m до n повторений включительно | \d | 1, 12 , 123 , 1234 , 12345 | |
| Не менее m повторений | \d | 1, 12, 123 , 1234 , 12345 | |
| Не более n повторений | \d | 1 , 12 , 12 3 | |
| ? | Ноль или одно вхождение, синоним | валы? | вал , валы , вал ов |
| * | Ноль или более, синоним | СУ\d* | СУ , СУ1 , СУ12 , . |
| + | Одно или более, синоним | a\)+ | a) , a)) , a))) , b a) ]) |
| *? +? ?? <,n>? |
По умолчанию квантификаторы жадные — захватывают максимально возможное число символов. Добавление ? делает их ленивыми, они захватывают минимально возможное число символов |
\(.*\) \(.*?\) |
(a + b) * (c + d) * (e + f) (a + b) * (c + d) * (e + f) |
Жадность в регулярках и границы найденного шаблона
Как указано выше, по умолчанию квантификаторы жадные. Этот подход решает очень важную проблему — проблему границы шаблона. Скажем, шаблон \d+ захватывает максимально возможное количество цифр. Поэтому можно быть уверенным, что перед найденным шаблоном идёт не цифра, и после идёт не цифра. Однако если в шаблоне есть не жадные части (например, явный текст), то подстрока может быть найдена неудачно. Например, если мы хотим найти «слова», начинающиеся на СУ , после которой идут цифры, при помощи регулярки СУ\d* , то мы найдём и неправильные шаблоны:
В тех случаях, когда это важно, условие на границу шаблона нужно обязательно добавлять в регулярку. О том, как это можно делать, будет дальше.
Пересечение подстрок
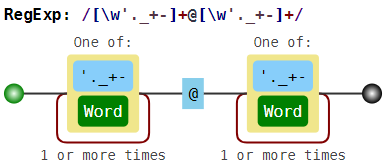
В обычной ситуации регулярки позволяют найти только непересекающиеся шаблоны. Вместе с проблемой границы слова это делает их использование в некоторых случаях более сложным. Например, если мы решим искать e-mail адреса при помощи неправильной регулярки \w+@\w+ (или даже лучше, [\w’._+-]+@[\w’._+-]+ ), то в неудачном случае найдём вот что:
То есть это с одной стороны и не e-mail, а с другой стороны это не все подстроки вида текст-собака-текст , так как boo@goo и moo@roo пропущены.
Эксперименты в песочнице
- Найдите все натуральные числа (возможно, окружённые буквами);
- Найдите все «слова», написанные капсом (то есть строго заглавными), возможно внутри настоящих слов (ааа БББ ввв);
- Найдите слова, в которых есть русская буква, а когда-нибудь за ней цифра;
- Найдите все слова, начинающиеся с русской или латинской большой буквы ( \b — граница слова);
- Найдите слова, которые начинаются на гласную ( \b — граница слова);;
- Найдите все натуральные числа, не находящиеся внутри или на границе слова;
- Найдите строчки, в которых есть символ * ( . — это точно не конец строки!);
- Найдите строчки, в которых есть открывающая и когда-нибудь потом закрывающая скобки;
- Выделите одним махом весь кусок оглавления (в конце примера, вместе с тегами);
- Выделите одним махом только текстовую часть оглавления, без тегов;
- Найдите пустые строчки;
Регулярки в питоне
Функции для работы с регулярками живут в модуле re . Основные функции:
| Функция | Её смысл |
|---|---|
| re.search(pattern, string) | Найти в строке string первую строчку, подходящую под шаблон pattern ; |
| re.fullmatch(pattern, string) | Проверить, подходит ли строка string под шаблон pattern ; |
| re.split(pattern, string, maxsplit=0) | Аналог str.split() , только разделение происходит по подстрокам, подходящим под шаблон pattern ; |
| re.findall(pattern, string) | Найти в строке string все непересекающиеся шаблоны pattern ; |
| re.finditer(pattern, string) | Итератор всем непересекающимся шаблонам pattern в строке string (выдаются match -объекты); |
| re.sub(pattern, repl, string, count=0) | Заменить в строке string все непересекающиеся шаблоны pattern на repl ; |
Пример использования всех основных функций
Тонкости экранирования в питоне ( ‘\\\\\\\\foo’ )
Так как символ \ в питоновских строках также необходимо экранировать, то в результате в шаблонах могут возникать конструкции вида ‘\\\\par’ . Первый слеш означает, что следующий за ним символ нужно оставить «как есть». Третий также. В результате с точки зрения питона ‘\\\\’ означает просто два слеша \\ . Теперь с точки зрения движка регулярных выражений, первый слеш экранирует второй. Тем самым как шаблон для регулярки ‘\\\\par’ означает просто текст \par . Для того, чтобы не было таких нагромождений слешей, перед открывающей кавычкой нужно поставить символ r , что скажет питону «не рассматривай \ как экранирующий символ (кроме случаев экранирования открывающей кавычки)». Соответственно можно будет писать r’\\par’ .
Использование дополнительных флагов в питоне
| Константа | Её смысл |
|---|---|
| re.ASCII | По умолчанию \w , \W , \b , \B , \d , \D , \s , \S соответствуют все юникодные символы с соответствующим качеством. Например, \d соответствуют не только арабские цифры, но и вот такие: ٠١٢٣٤٥٦٧٨٩. re.ASCII ускоряет работу, если все соответствия лежат внутри ASCII. |
| Не различать заглавные и маленькие буквы. Работает медленнее, но иногда удобно |
|
| re.MULTILINE | Специальные символы ^ и $ соответствуют началу и концу каждой строки |
| re.DOTALL | По умолчанию символ \n конца строки не подходит под точку. С этим флагом точка — вообще любой символ |
Написание и тестирование регулярных выражений
Для написания и тестирования регулярных выражений удобно использовать сервис https://regex101.com (не забудьте поставить галочку Python в разделе FLAVOR слева) или текстовый редактор Sublime text 3.
Задачи — 1
В России применяются регистрационные знаки нескольких видов.
Общего в них то, что они состоят из цифр и букв. Причём используются только 12 букв кириллицы, имеющие графические аналоги в латинском алфавите — А, В, Е, К, М, Н, О, Р, С, Т, У и Х.
У частных легковых автомобилях номера — это буква, три цифры, две буквы, затем две или три цифры с кодом региона. У такси — две буквы, три цифры, затем две или три цифры с кодом региона. Есть также и другие виды, но в этой задаче они не понадобятся.
Вам потребуется определить, является ли последовательность букв корректным номером указанных двух типов, и если является, то каким.
На вход даются строки, которые претендуют на то, чтобы быть номером. Определите тип номера. Буквы в номерах — заглавные русские. Маленькие и английские для простоты можно игнорировать.
| Ввод | Вывод |
|---|
| Ввод | Вывод |
|---|
Допустимый формат e-mail адреса регулируется стандартом RFC 5322.
Если говорить вкратце, то e-mail состоит из одного символа @ (at-символ или собака), текста до собаки (Local-part) и текста после собаки (Domain part). Вообще в адресе может быть всякий беспредел (вкратце можно прочитать о нём в википедии). Довольно странные штуки могут быть валидным адресом, например:
"very.(),:;<>[]\".VERY.\"very@\\ \"very\".unusual"@[IPv6:2001:db8::1]
"()<>[]:,;@\\\"!#$%&’-/=?^_`<>|
.a"@(comment)exa-mple
Но большинство почтовых сервисов такой ад и вакханалию не допускают. И мы тоже не будем 🙂
Будем рассматривать только адреса, имя которых состоит из не более, чем 64 латинских букв, цифр и символов ‘._+- , а домен — из не более, чем 255 латинских букв, цифр и символов .- . Ни Local-part, ни Domain part не может начинаться или заканчиваться на .+- , а ещё в адресе не может быть более одной точки подряд.
Кстати, полезно знать, что часть имени после символа + игнорируется, поэтому можно использовать синонимы своего адреса (например, shаshkоv+spam@179.ru и shаshkоv+vk@179.ru ), для того, чтобы упростить себе сортировку почты. (Правда не все сайты позволяют использовать "+", увы)
На вход даётся текст. Необходимо вывести все e-mail адреса, которые в нём встречаются. В общем виде задача достаточно сложная, поэтому у нас будет 3 ограничения:
две точки внутри адреса не встречаются;
две собаки внутри адреса не встречаются;
считаем, что e-mail может быть частью «слова», то есть в boo@ya_ru мы видим адрес boo@ya , а в foo№boo@ya.ru видим boo@ya.ru .
PS. Совсем не обязательно делать все проверки только регулярками. Регулярные выражения — это просто инструмент, который делает часть задач простыми. Не нужно делать их назад сложными 🙂
| Ввод | Вывод |
|---|
Скобочные группы (. ) и перечисления |
Перечисления (операция «ИЛИ»)
Чтобы проверить, удовлетворяет ли строка хотя бы одному из шаблонов, можно воспользоваться аналогом оператора or , который записывается с помощью символа | . Так, некоторая строка подходит к регулярному выражению A|B тогда и только тогда, когда она подходит хотя бы к одному из регулярных выражений A или B . Например, отдельные овощи в тексте можно искать при помощи шаблона морковк|св[её]кл|картошк|редиск .
Скобочные группы (группировка плюс квантификаторы)
Зачастую шаблон состоит из нескольких повторяющихся групп. Так, MAC-адрес сетевого устройства обычно записывается как шесть групп из двух шестнадцатиричных цифр, разделённых символами — или : . Например, 01:23:45:67:89:ab . Каждый отдельный символ можно задать как [0-9a-fA-F] , и можно весь шаблон записать так:
[0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]<2>[:-][0-9a-fA-F]
Ситуация становится гораздо сложнее, когда количество групп заранее не зафиксировано.
Чтобы разрешить эту проблему в синтаксисе регулярных выражений есть группировка (. ) . Можно писать круглые скобки и без значков ?: , однако от этого у группировки значительно меняется смысл, регулярка начинает работать гораздо медленнее. Об этом будет написано ниже. Итак, если REGEXP — шаблон, то (?:REGEXP) — эквивалентный ему шаблон. Разница только в том, что теперь к (?:REGEXP) можно применять квантификаторы, указывая, сколько именно раз должна повториться группа. Например, шаблон для поиска MAC-адреса, можно записать так:
[0-9a-fA-F]<2>(?:[:-][0-9a-fA-F]<2>)
Скобки плюс перечисления
Также скобки (. ) позволяют локализовать часть шаблона, внутри которого происходит перечисление. Например, шаблон (?:он|тот) (?:шёл|плыл) соответствует каждой из строк «он шёл», «он плыл», «тот шёл», «тот плыл», и является синонимом он шёл|он плыл|тот шёл|тот плыл .
Ещё примеры
| Шаблон | Применяем к тексту |
|---|---|
| (?:\w\w\d\d)+ | Есть м иг29 а, ту15 4б. Некоторые делают даже м иг29ту15 4 ил86 . |
| (?:\w+\d+)+ | Есть миг29 а, ту154 б. Некоторые делают даже миг29ту154ил86 . |
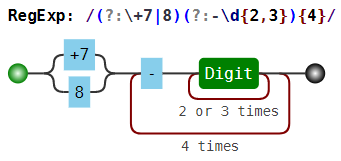
| (?:\+7|8)(?:-\d<2,3>) | +7-926-123-12-12 , 8-926-123-12-12 |
| (?:[Хх][аоеи]+)+ | Му ха — хахахехо , ну хааахооохе , да хахахехохииии ! Ха м трамвайный. |
| \b(?:[Хх][аоеи]+)+\b | Муха — хахахехо , ну хааахооохе , да хахахехохииии ! Хам трамвайный. |
Задачи — 2
Вовочка подготовил одно очень важное письмо, но везде указал неправильное время.
Поэтому нужно заменить все вхождения времени на строку (TBD) . Время — это строка вида HH:MM:SS или HH:MM , в которой HH — число от 00 до 23, а MM и SS — число от 00 до 59.
| Ввод | Вывод |
|---|
Pascal requires that real constants have either a decimal point, or an exponent (starting with the letter e or E, and officially called a scale factor), or both, in addition to the usual collection of decimal digits. If a decimal point is included it must have at least one decimal digit on each side of it. As expected, a sign (+ or -) may precede the entire number, or the exponent, or both. Exponents may not include fractional digits. Blanks may precede or follow the real constant, but they may not be embedded within it. Note that the Pascal syntax rules for real constants make no assumptions about the range of real values, and neither does this problem. Your task in this problem is to identify legal Pascal real constants.
| Ввод | Вывод |
|---|
Владимир устроился на работу в одно очень важное место. И в первом же документе он ничего не понял,
там были сплошные ФГУП НИЦ ГИДГЕО, ФГОУ ЧШУ АПК и т.п. Тогда он решил собрать все аббревиатуры, чтобы потом найти их расшифровки на http://sokr.ru/. Помогите ему.
Будем считать аббревиатурой слова только лишь из заглавных букв (как минимум из двух). Если несколько таких слов разделены пробелами, то они
считаются одной аббревиатурой.
| Ввод | Вывод |
|---|
Группирующие скобки (. ) и match -объекты в питоне
Match-объекты
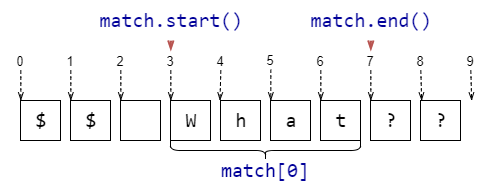
Если функции re.search , re.fullmatch не находят соответствие шаблону в строке, то они возвращают None , функция re.finditer не выдаёт ничего. Однако если соответствие найдено, то возвращается match -объект. Эта штука содержит в себе кучу полезной информации о соответствии шаблону. Полный набор атрибутов можно посмотреть в документации, а здесь приведём самое полезное.
| Метод | Описание | Пример |
|---|---|---|
| match[0] , match.group() |
Подстрока, соответствующая шаблону | match = re.search(r’\w+’, r’$$ What??’) match[0] # -> ‘What’ |
| match.start() | Индекс в исходной строке, начиная с которого идёт найденная подстрока | match = re.search(r’\w+’, r’$$ What??’) match.start() # -> 3 |
| match.end() | Индекс в исходной строке, который следует сразу за найденной подстрока | match = re.search(r’\w+’, r’$$ What??’) match.end() # -> 7 |
Группирующие скобки (. )
Если в шаблоне регулярного выражения встречаются скобки (. ) без ?: , то они становятся группирующими. В match-объекте, который возвращают re.search , re.fullmatch и re.finditer , по каждой такой группе можно получить ту же информацию, что и по всему шаблону. А именно часть подстроки, которая соответствует (. ) , а также индексы начала и окончания в исходной строке. Достаточно часто это бывает полезно.
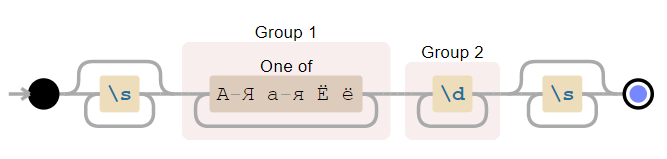
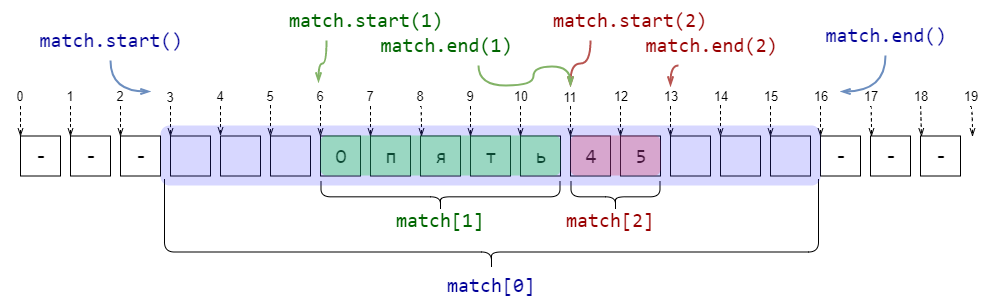
Тонкости со скобками и нумерацией групп.
Если к группирующим скобкам применён квантификатор (то есть указано число повторений), то подгруппа в match-объекте будет создана только для последнего соответствия. Например, если бы в примере выше квантификаторы были снаружи от скобок ‘\s*([А-Яа-яЁё])+(\d)+\s*’ , то вывод был бы таким:
Внутри группирующих скобок могут быть и другие группирующие скобки. В этом случае их нумерация производится в соответствии с номером появления открывающей скобки с шаблоне.
Группы и re.findall
Если в шаблоне есть группирующие скобки, то вместо списка найденных подстрок будет возвращён список кортежей, в каждом из которых только соответствие каждой группе. Это не всегда происходит по плану, поэтому обычно нужно использовать негруппирующие скобки (. ) .
Группы и re.split
Если в шаблоне нет группирующих скобок, то re.split работает очень похожим образом на str.split . А вот если группирующие скобки в шаблоне есть, то между каждыми разрезанными строками будут все соответствия каждой из подгрупп.
В некоторых ситуация эта возможность бывает чрезвычайно удобна! Например, достаточно из предыдущего примера убрать лишние группы, и польза сразу станет очевидна!
Использование групп при заменах
Использование групп добавляет замене ( re.sub , работает не только в питоне, а почти везде) очень удобную возможность: в шаблоне для замены можно ссылаться на соответствующую группу при помощи \1, \2, \3, . . Например, если нужно даты из неудобного формата ММ/ДД/ГГГГ перевести в удобный ДД.ММ.ГГГГ, то можно использовать такую регулярку:
Если групп больше 9, то можно ссылаться на них при помощи конструкции вида \g<12> .
Замена с обработкой шаблона функцией в питоне
Ещё одна питоновская фича для регулярных выражений: в функции re.sub вместо текста для замены можно передать функцию, которая будет получать на вход match-объект и должна возвращать строку, на которую и будет произведена замена. Это позволяет не писать ад в шаблоне для замены, а использовать удобную функцию. Например, «зацензурим» все слова, начинающиеся на букву «Х»:
Ссылки на группы при поиске
При помощи \1, \2, \3, . и \g<12> можно ссылаться на найденную группу и при поиске. Необходимость в этом встречается довольно редко, но это бывает полезно при обработке простых xml и html.
Только пообещайте, что не будете парсить сложный xml и тем более html при помощи регулярок! Регулярные выражения для этого не подходят. Используйте другие инструменты. Каждый раз, когда неопытный программист парсит html регулярками, в мире умирает котёнок. Если кажется «Да здесь очень простой html, напишу регулярку», то сразу вспоминайте шутку про две проблемы. Не нужно пытаться парсить html регулярками, даже Пётр Митричев не сможет это сделать в общем случае 🙂 Использование регулярных выражений при парсинге html подобно залатыванию резиновой лодки шилом. Закон Мёрфи для парсинга html и xml при помощи регулярок гласит: парсинг html и xml регулярками иногда работает, но в точности до того момента, когда правильность результата будет очень важна.
Задачи — 3
Владимиру потребовалось срочно запутать финансовую документацию. Но так, чтобы это было обратимо.
Он не придумал ничего лучше, чем заменить каждое целое число (последовательность цифр) на его куб. Помогите ему.
| Ввод | Вывод |
|---|
| Ввод | Вывод |
|---|
Хайку — жанр традиционной японской лирической поэзии века, известный с XIV века.
Оригинальное японское хайку состоит из 17 слогов, составляющих один столбец иероглифов. Особыми разделительными словами — кирэдзи — текст хайку делится на части из 5, 7 и снова 5 слогов. При переводе хайку на западные языки традиционно вместо разделительного слова использую разрыв строки и, таким образом, хайку записываются как трёхстишия.
Перед вами трёхстишия, которые претендуют на то, чтобы быть хайку. В качестве разделителя строк используются символы / . Если разделители делят текст на строки, в которых 5/7/5 слогов, то выведите «Хайку!». Если число строк не равно 3, то выведите строку «Не хайку. Должно быть 3 строки.» Иначе выведите строку вида «Не хайку. В i строке слогов не s, а j.», где строка i — самая ранняя, в которой количество слогов неправильное.
Для простоты будем считать, что слогов ровно столько же, сколько гласных, не задумываясь о тонкостях.
| Ввод | Вывод |
|---|---|
| Вечер за окном. / Еще один день прожит. / Жизнь скоротечна. | Хайку! |
| Просто текст | Не хайку. Должно быть 3 строки. |
| Как вишня расцвела! / Она с коня согнала / И князя-гордеца. | Не хайку. В 1 строке слогов не 5, а 6. |
| На голой ветке / Ворон сидит одиноко… / Осенний вечер! | Не хайку. В 2 строке слогов не 7, а 8. |
| Тихо, тихо ползи, / Улитка, по склону Фудзи, / Вверх, до самых высот! | Не хайку. В 1 строке слогов не 5, а 6. |
| Жизнь скоротечна… / Думает ли об этом / Маленький мальчик. | Хайку! |
Шаблоны, соответствующие не конкретному тексту, а позиции
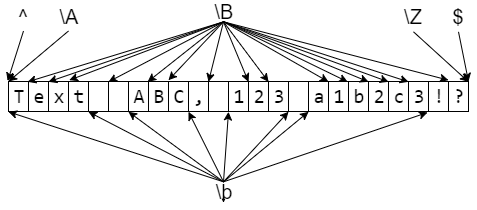
Отдельные части регулярного выражения могут соответствовать не части текста, а позиции в этом тексте. То есть такому шаблону соответствует не подстрока, а некоторая позиция в тексте, как бы «между» буквами.
Простые шаблоны, соответствующие позиции
| Шаблон | Описание | Пример | Применяем к тексту |
|---|---|---|---|
| ^ | Начало всего текста или начало строчки текста, если flag=re.MULTILINE |
^Привет | |
| $ | Конец всего текста или конец строчки текста, если flag=re.MULTILINE |
Будь здоров!$ | |
| \A | Строго начало всего текста | ||
| \Z | Строго конец всего текста | ||
| \b | Начало или конец слова (слева пусто или не-буква, справа буква и наоборот) | \bвал | вал , перевал, Перевалка |
| \B | Не граница слова: либо и слева, и справа буквы, либо и слева, и справа НЕ буквы |
\Bвал | пере вал , вал, Пере вал ка |
| \Bвал\B | перевал, вал, Пере вал ка |
Сложные шаблоны, соответствующие позиции (lookaround и Co)
Следующие шаблоны применяются в основном в тех случаях, когда нужно уточнить, что должно идти непосредственно перед или после шаблона, но при этом
не включать найденное в match-объект.
| Шаблон | Описание | Пример | Применяем к тексту |
|---|---|---|---|
| (?=. ) | lookahead assertion, соответствует каждой позиции, сразу после которой начинается соответствие шаблону . |
Isaac (?=Asimov) | Isaac Asimov, Isaac other |
| (. ) | negative lookahead assertion, соответствует каждой позиции, сразу после которой НЕ может начинаться шаблон . |
Isaac (?!Asimov) | Isaac Asimov, Isaac other |
| (?<=. ) | positive lookbehind assertion, соответствует каждой позиции, которой может заканчиваться шаблон . Длина шаблона должна быть фиксированной, то есть abc и a|b — это ОК, а a* и a <2,3>— нет. |
(?<=abc)def | abc def , bcdef |
| negative lookbehind assertion, соответствует каждой позиции, которой НЕ может заканчиваться шаблон . |
(?<!abc)def | abcdef, bc def |
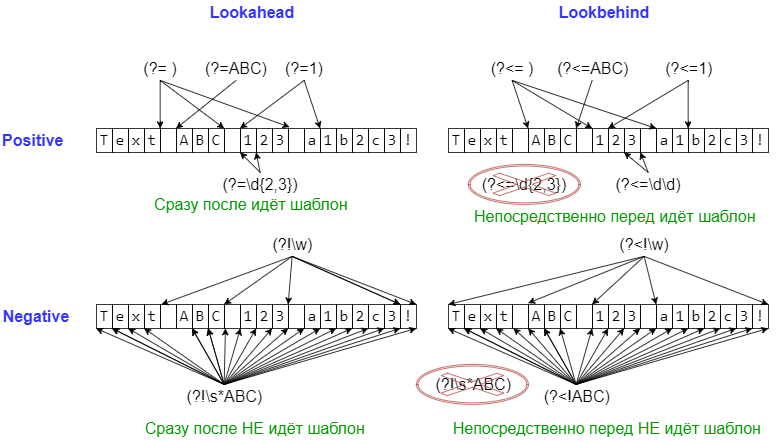
На всякий случай ещё раз. Каждый их этих шаблонов проверяет лишь то, что идёт непосредственно перед позицией или непосредственно после позиции. Если пару таких шаблонов написать рядом, то проверки будут независимы (то есть будут соответствовать AND в каком-то смысле).
lookaround на примере королей и императоров Франции
Людовик(?=VI) — Людовик, за которым идёт VI
| Шаблон | Комментарий | Применяем к тексту |
|---|---|---|
| (?<!\d)\d(?!\d) | Цифра, окружённая не-цифрами | Text ABC 123 A 1 B 2 C 3 ! |
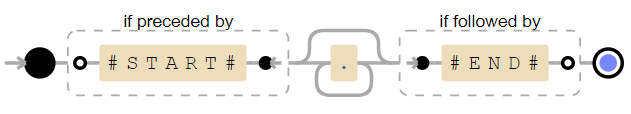
| (?<=#START#).*?(?=#END#) | Текст от #START# до #END# | text from #START# till #END# |
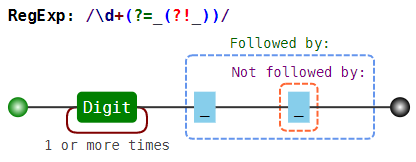
| \d+(?=_(?!_)) | Цифра, после которой идёт ровно одно подчёркивание | 12 _34__56 |
| ^(?:(?!boo).)*?$ | Строка, в которой нет boo (то есть нет такого символа, перед которым есть boo) |
a foo and boo and zoo and others |
| ^(?:(?!boo)(?!foo).)*?$ | Строка, в которой нет ни boo, ни foo | a foo and boo and zoo and others |
Прочие фичи
Конечно, здесь описано не всё, что умеют регулярные выражения, и даже не всё, что умеют регулярные выражения в питоне. За дальнейшим можно обращаться к этому разделу. Из полезного за кадром осталась компиляция регулярок для ускорения многократного использования одного шаблона, использование именных групп и разные хитрые трюки.
А уж какие извращения можно делать с регулярными выражениями в языке Perl — поручик Ржевский просто отдыхает 🙂
Задачи — 4
Владимир написал свой открытый проект, именуя переменные в стиле «ВерблюжийРегистр».
И только после того, как написал о нём статью, он узнал, что в питоне для имён переменных принято использовать подчёркивания для разделения слов (under_score). Нужно срочно всё исправить, пока его не «закидали тапками».
Задача могла бы оказаться достаточно сложной, но, к счастью, Владимир совсем не использовал строковых констант и классов.
Поэтому любая последовательность букв и цифр, внутри которой есть заглавные, — это имя переменной, которое нужно поправить.
| Ввод | Вывод |
|---|
Довольно распространённая ошибка ошибка — это повтор слова.
Вот в предыдущем предложении такая допущена. Необходимо исправить каждый такой повтор (слово, один или несколько пробельных символов, и снова то же слово).
| Ввод | Вывод |
|---|---|
| Довольно распространённая ошибка ошибка — это лишний повтор повтор слова слова. Смешно, не не правда ли? Не нужно портить хор хоровод. | Довольно распространённая ошибка — это лишний повтор слова. Смешно, не правда ли? Не нужно портить хор хоровод. |
Для простоты будем считать словом любую последовательность букв, цифр и знаков _ (то есть символов \w ).
Дан текст. Необходимо найти в нём любой фрагмент, где сначала идёт слово «олень», затем не более 5 слов, и после этого идёт слово «заяц».
| Ввод | Вывод |
|---|
Большие целые числа удобно читать, когда цифры в них разделены на тройки запятыми.
Переформатируйте целые числа в тексте.
| Ввод | Вывод |
|---|
Для простоты будем считать, что:
- каждое предложение начинается с заглавной русской или латинской буквы;
- каждое предложение заканчивается одним из знаков препинания .;!? ;
- между предложениями может быть любой непустой набор пробельных символов;
- внутри предложений нет заглавных и точек (нет пакостей в духе «Мы любим творчество А. С. Пушкина)».
Разделите текст на предложения так, чтобы каждое предложение занимало одну строку.
Пустых строк в выводе быть не должно. Любые наборы из полее одного пробельного символа замените на один пробел.
| Ввод | Вывод |
|---|
Если вы когда-нибудь пытались собирать номера мобильных телефонов, то наверняка знаете, что почти любые 10 человек используют как минимум пяток различных способов записать номер телефона. Кто-то начинает с +7 , кто-то просто с 7 или 8 , а некоторые вообще не пишут префикс. Трёхзначный код кто-то отделяет пробелами, кто-то при помощи дефиса, кто-то скобками (и после скобки ещё пробел некоторые добавляют). После следующих трёх цифр кто-то ставит пробел, кто-то дефис, кто-то ничего не ставит. И после следующих двух цифр — тоже. А некоторые начинают за здравие, а заканчивают… В общем очень неудобно!
На вход даётся номер телефона, как его мог бы ввести человек. Необходимо его переформатировать в формат +7 123 456-78-90 . Если с номером что-то не так, то нужно вывести строчку Fail! .
| Ввод | Вывод |
|---|
В предыдущей задаче мы немного схалтурили.
Однако к этому моменту задача должна стать посильной!
На вход даётся текст. Необходимо вывести все e-mail адреса, которые в нём встречаются. При этом e-mail не может быть частью слова, то есть слева и справа от e-mail’а должен быть либо конец строки, либо не-буква и при этом не один из символов ‘._+- , допустимых в адресе.
Python RegEx: практическое применение регулярок
Рассмотрим регулярные выражения в Python, начиная синтаксисом и заканчивая примерами использования.
Примечание Вы читаете улучшенную версию некогда выпущенной нами статьи.
Основы регулярных выражений
Регулярками в Python называются шаблоны, которые используются для поиска соответствующего фрагмента текста и сопоставления символов.
Грубо говоря, у нас есть input-поле, в которое должен вводиться email-адрес. Но пока мы не зададим проверку валидности введённого email-адреса, в этой строке может оказаться совершенно любой набор символов, а нам это не нужно.
Чтобы выявить ошибку при вводе некорректного адреса электронной почты, можно использовать следующее регулярное выражение:
По сути, наш шаблон — это набор символов, который проверяет строку на соответствие заданному правилу. Давайте разберёмся, как это работает.
Синтаксис RegEx
Синтаксис у регулярок необычный. Символы могут быть как буквами или цифрами, так и метасимволами, которые задают шаблон строки:
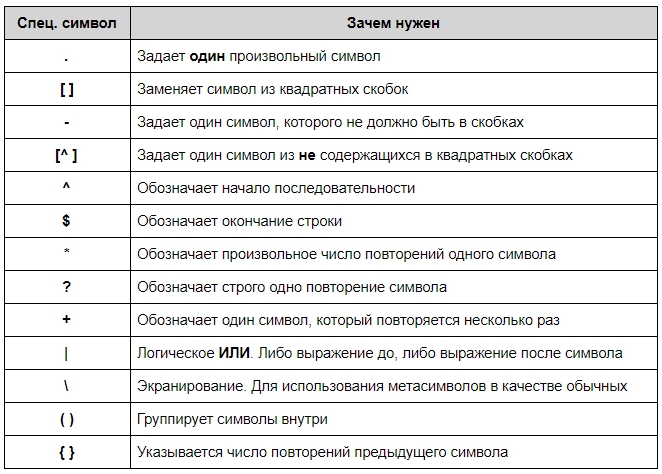
Также есть дополнительные конструкции, которые позволяют сокращать регулярные выражения:
- \d — соответствует любой одной цифре и заменяет собой выражение [0-9];
- \D — исключает все цифры и заменяет [^0-9];
- \w — заменяет любую цифру, букву, а также знак нижнего подчёркивания;
- \W — любой символ кроме латиницы, цифр или нижнего подчёркивания;
- \s — соответствует любому пробельному символу;
- \S — описывает любой непробельный символ.
Для чего используются регулярные выражения
- для определения нужного формата, например телефонного номера или email-адреса;
- для разбивки строк на подстроки;
- для поиска, замены и извлечения символов;
- для быстрого выполнения нетривиальных операций.
Синтаксис таких выражений в основном стандартизирован, так что вам следует понять их лишь раз, чтобы использовать в любом языке программирования.
Примечание Не стоит забывать, что регулярные выражения не всегда оптимальны, и для простых операций часто достаточно встроенных в Python функций.
Хотите узнать больше? Обратите внимание на статью о регулярках для новичков.
Регулярные выражения в Python
В Python для работы с регулярками есть модуль re . Его нужно просто импортировать:
А вот наиболее популярные методы, которые предоставляет модуль:
- re.match()
- re.search()
- re.findall()
- re.split()
- re.sub()
- re.compile()
Рассмотрим каждый из них подробнее.
re.match(pattern, string)
Этот метод ищет по заданному шаблону в начале строки. Например, если мы вызовем метод match() на строке «AV Analytics AV» с шаблоном «AV», то он завершится успешно. Но если мы будем искать «Analytics», то результат будет отрицательный:
Искомая подстрока найдена. Чтобы вывести её содержимое, применим метод group() (мы используем «r» перед строкой шаблона, чтобы показать, что это «сырая» строка в Python):
Теперь попробуем найти «Analytics» в данной строке. Поскольку строка начинается на «AV», метод вернет None :
Также есть методы start() и end() для того, чтобы узнать начальную и конечную позицию найденной строки.
Эти методы иногда очень полезны для работы со строками.
re.search(pattern, string)
Метод похож на match() , но ищет не только в начале строки. В отличие от предыдущего, search() вернёт объект, если мы попытаемся найти «Analytics»:
Метод search() ищет по всей строке, но возвращает только первое найденное совпадение.
re.findall(pattern, string)
Возвращает список всех найденных совпадений. У метода findall() нет ограничений на поиск в начале или конце строки. Если мы будем искать «AV» в нашей строке, он вернет все вхождения «AV». Для поиска рекомендуется использовать именно findall() , так как он может работать и как re.search() , и как re.match() .
re.split(pattern, string, [maxsplit=0])
Этот метод разделяет строку по заданному шаблону.
В примере мы разделили слово «Analytics» по букве «y». Метод split() принимает также аргумент maxsplit со значением по умолчанию, равным 0. В данном случае он разделит строку столько раз, сколько возможно, но если указать этот аргумент, то разделение будет произведено не более указанного количества раз. Давайте посмотрим на примеры Python RegEx:
Мы установили параметр maxsplit равным 1, и в результате строка была разделена на две части вместо трех.
re.sub(pattern, repl, string)
Ищет шаблон в строке и заменяет его на указанную подстроку. Если шаблон не найден, строка остается неизменной.
re.compile(pattern, repl, string)
Мы можем собрать регулярное выражение в отдельный объект, который может быть использован для поиска. Это также избавляет от переписывания одного и того же выражения.
До сих пор мы рассматривали поиск определенной последовательности символов. Но что, если у нас нет определенного шаблона, и нам надо вернуть набор символов из строки, отвечающий определенным правилам? Такая задача часто стоит при извлечении информации из строк. Это можно сделать, написав выражение с использованием специальных символов. Вот наиболее часто используемые из них:
| Оператор | Описание |
|---|---|
| . | Один любой символ, кроме новой строки \n. |
| ? | 0 или 1 вхождение шаблона слева |
| + | 1 и более вхождений шаблона слева |
| * | 0 и более вхождений шаблона слева |
| \w | Любая цифра или буква (\W — все, кроме буквы или цифры) |
| \d | Любая цифра [0-9] (\D — все, кроме цифры) |
| \s | Любой пробельный символ (\S — любой непробельный символ) |
| \b | Граница слова |
| [..] | Один из символов в скобках ([^..] — любой символ, кроме тех, что в скобках) |
| \ | Экранирование специальных символов (\. означает точку или \+ — знак «плюс») |
| ^ и $ | Начало и конец строки соответственно |
| От n до m вхождений ( — от 0 до m) | |
| a|b | Соответствует a или b |
| () | Группирует выражение и возвращает найденный текст |
| \t, \n, \r | Символ табуляции, новой строки и возврата каретки соответственно |
Больше информации по специальным символам можно найти в документации для регулярных выражений в Python 3.
Перейдём к практическому применению Python регулярных выражений и рассмотрим примеры.
Задачи
Вернуть первое слово из строки
Сначала попробуем вытащить каждый символ (используя . )
Для того, чтобы в конечный результат не попал пробел, используем вместо . \w .
Теперь попробуем достать каждое слово (используя * или + )
И снова в результат попали пробелы, так как * означает «ноль или более символов». Для того, чтобы их убрать, используем + :
Теперь вытащим первое слово, используя ^ :
Если мы используем $ вместо ^ , то мы получим последнее слово, а не первое:
Вернуть первые два символа каждого слова
Вариант 1: используя \w , вытащить два последовательных символа, кроме пробельных, из каждого слова:
Вариант 2: вытащить два последовательных символа, используя символ границы слова ( \b ):
Вернуть домены из списка email-адресов
Сначала вернём все символы после «@»:
Как видим, части «.com», «.in» и т. д. не попали в результат. Изменим наш код:
Второй вариант — вытащить только домен верхнего уровня, используя группировку — ( ) :
Извлечь дату из строки
Используем \d для извлечения цифр.
Для извлечения только года нам опять помогут скобки:
Извлечь слова, начинающиеся на гласную
Для начала вернем все слова:
А теперь — только те, которые начинаются на определенные буквы (используя [] ):
Выше мы видим обрезанные слова «argest» и «ommunity». Для того, чтобы убрать их, используем \b для обозначения границы слова:
Также мы можем использовать ^ внутри квадратных скобок для инвертирования группы:
В результат попали слова, «начинающиеся» с пробела. Уберем их, включив пробел в диапазон в квадратных скобках:
Проверить формат телефонного номера
Номер должен быть длиной 10 знаков и начинаться с 8 или 9. Есть список телефонных номеров, и нужно проверить их, используя регулярки в Python:
Разбить строку по нескольким разделителям
Также мы можем использовать метод re.sub() для замены всех разделителей пробелами:
Извлечь информацию из html-файла
Допустим, нужно извлечь информацию из html-файла, заключенную между <td> и </td> , кроме первого столбца с номером. Также будем считать, что html-код содержится в строке.
Пример содержимого html-файла:
С помощью регулярных выражений в Python это можно решить так (если поместить содержимое файла в переменную test_str ):