Способы удаления дубликатов в SQL Server

При проектировании объектов, в частности таблиц в БД SQL Server, необходимо придерживаться определенных правил. Однако, даже если следовать данным правилам существует вероятность появления дубликатов в строках таблиц. Данная статья посвящена различным способам очистки данных от дубликатов.
При проектировании объектов, в частности таблиц в БД SQL Server необходимо придерживаться определенных правил: рекомендуется использовать правила нормализации БД; таблица должна иметь первичные ключи, кластерные и некластерные индексы; ограничения для обеспечения целостности данных и производительности. Но даже если следовать этим правилам, мы можем столкнуться с проблемой появления дубликатов в строках таблицы. Кроме этого, возможна ситуация получения дубликатов при импорте данных, когда мы загружаем данные as is в промежуточные таблицы, и далее требуется удалить дублирующие записи перед загрузкой в промышленные таблицы.
Рассмотрим различные способы для очистки данных от дублей. Создадим простую таблицу сотрудников и наполним её несколькими записями.
CREATE TABLE Employee ( [id] int identity(1,1), [Фамилия] nvarchar(100), [Имя] nvarchar(100), [Отчество] nvarchar(100), [Дата рождения] date, ) GO Insert into Employee ([Фамилия],[Имя],[Отчество],[Дата рождения]) values (N’Алексеев’,N’Алексей’,N’Алексеевич’,’1990–03–01'), (N’Алексеев’,N’Алексей’,N’Алексеевич’,’1990–03–01'), (N’Алексеев’,N’Алексей’,N’Алексеевич’,’1990–03–01') (N’Иванов’,N’Иван’,N’Иванович’,’1985–01–01'), (N’Иванов’,N’Иван’,N’Иванович’,’1985–01–01'), (N’Петров’,N’Петр’,N’Петрович’,’1988–02–01'),
Как мы видим, в таблице присутствуют дублирующие строки, которые необходимо удалить.
- Удаление дубликатов с использованием агрегатных функций
C помощью условия GROUP BY мы группируем данные по определенным столбцам и используем функцию COUNT для подсчета вхождений строк в таблицу.
Например, с помощью следующего запроса, определим записи, которые присутствуют в таблице более 1 раза.
Select [Фамилия], [Имя], [Отчество], [Дата рождения], count(*) as CNT FROM NTA.dbo.Employee GROUP BY [Фамилия], [Имя], [Отчество], [Дата рождения] having count(*) > 1
Т.е. сотрудники Алексеев А.А. и Иванов И.И. присутствуют в таблице 3 и 2 раза соответственно.
Удалим дублирующие записи, оставив только строки с MIN id сотрудника.
Delete FROM NTA.dbo.Employee Where id not in ( select min(id) as MinRowID FROM NTA.dbo.Employee group by [Фамилия],[Имя],[Отчество],[Дата рождения] )
Выведем оставшиеся записи таблицы, и убедимся, что дубликаты отсутствуют.
Отметим, что данный способ удаления дубликатов возможен в случае таблиц, для которых определен первичный ключ.
- Удаление дубликатов используя обобщенные табличные выражения (CTE)
Мы можем использовать связку обобщенных табличных выражений и функции ROW_number() для удаления дубликатов, например следующим образом:
WITH CTE ([Фамилия], [Имя], [Отчество], [Дата рождения], [Нумерация] ) AS (SELECT [Фамилия], [Имя], [Отчество], [Дата рождения], ROW_NUMBER () OVER (PARTITION BY [Фамилия], [Имя], [Отчество], [Дата рождения] ORDER BY id) AS [Нумерация] FROM NTA.dbo.Employee) DELETE FROM CTE WHERE [Нумерация] > 1
В данном запросе мы используем функцию ROW_number() с конструкцией partition BY в предложении OVER для нумерации записей, и удаляем записи с пронумерованными значениями > 1, соответствующие дубликатам.
- Удаление дубликатов с использованием инструментария SSIS пакетов.
Создадим в SQL Server Data Tools новый пакет integration Services.
Добавим в пакет элемент «OLE DB Source», откроем редактор OLE DB Source, в графе Connection Manager укажем реквизиты экземпляра СУБД и БД, и наименование исходной таблицы с данными, содержащей дубликаты.
С помощью кнопки Preview убедимся, что в исходной таблице присутствуют дубликаты.
Добавим оператор «Sort», и выделим поля, в которых присутствуют дублирующие данные.
Установим галку «Remove rows with duplicate sort values» для удаления дубликатов.
Добавим элемент «OLE DB Destination», в котором укажем целевую таблицу для записей результата очистки данных.
Запустив на исполнение реализованный SSIS пакет, мы видим, что в целевой источник загрузилось 3 строки, проверим, что отсутствуют дубликаты.
Необходимо отметить, что при использовании данного способа потребуется дополнительное место для хранения новой целевой таблицы, однако данный вариант позволяет избежать ошибок и вернуться к исходному варианту, в случае если результат в целевой таблице не будет являться удовлетворительным.
В данной статье мы рассмотрели различные способы удаления дубликатов записей в таблицах БД SQL Server, которые могут быть использованы в работе в зависимости от задачи и объема данных.
При больших объемах дубликатов в данных целесообразно рассмотреть возможность сохранения уникальных значений в промежуточную таблицу, очистку рабочей таблицы, и возврат оставленных уникальных записей.
How To Delete Duplicate Rows in MySQL
Summary: in this tutorial, you will learn various ways to delete duplicate rows in MySQL.
In the previous tutorial, we have shown you how to find duplicate values in a table. Once the duplicates rows are identified, you may want to delete them to clean up your data.
Prepare sample data
The following script creates table contacts and inserts sample data into the contacts table for the demonstration.
Note that you can execute this script to recreate test data after you execute a DELETE statement.
This query returns data from the contacts table:
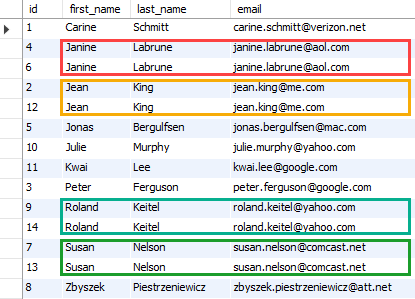
The following query returns the duplicate emails in the contacts table:
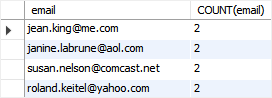
As you can see, we have four rows with duplicate emails.
A) Delete duplicate rows using DELETE JOIN statement
MySQL provides you with the DELETE JOIN statement that allows you to remove duplicate rows quickly.
The following statement deletes duplicate rows and keeps the highest id:
This query references the contacts table twice, therefore, it uses the table alias t1 and t2.
It indicated that four rows have been deleted. You can execute the query that find duplicate emails again to verify the delete:
The query returns an empty set, which means that the duplicate rows have been deleted.
Let’s verify data from the contacts table:
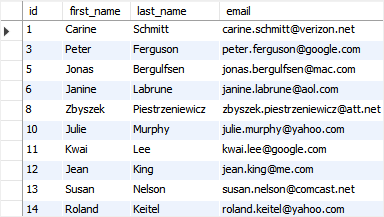
The rows with id 2, 4, 7, and 9 have been deleted.
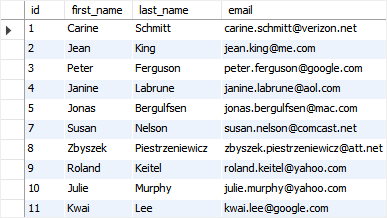
In case you want to delete duplicate rows and keep the lowest id, you can use the following statement:
Note that you can execute the script for creating contacts table again and test this query. The following output shows the data of the contacts table after removing duplicate rows.
B) Delete duplicate rows using an intermediate table
The following shows the steps for removing duplicate rows using an intermediate table:
-
with the structure the same as the original table that you want to delete duplicate rows. distinct rows from the original table to the immediate table. and rename the immediate table to the original table.
The following queries illustrate the steps:
Step 1. Create a new table whose structure is the same as the original table:
Step 2. Insert distinct rows from the original table to the new table:
Step 3. drop the original table and rename the immediate table to the original one
For example, the following statements delete rows with duplicate emails from the contacts table:
C) Delete duplicate rows using the ROW_NUMBER() function
The following statement uses the ROW_NUMBER() function to assign a sequential integer number to each row. If the email is duplicate, the row number will be greater than one.
The following statement returns id list of the duplicate rows:

And you just delete the duplicate rows from the contacts table using the DELETE statement with a subquery in the WHERE clause:
MySQL issued the following message:
In this tutorial, you have learned how to delete duplicate rows in MySQL by using the the DELETE JOIN statement or an intermediate table.
Как удалить дубликаты строк из таблицы?
Обычно такой вопрос возникает, когда при проектировании таблиц допущены ошибки, в частности, отсутствует первичный ключ, и уже имеются данные, которые препятствуют его созданию. При этом ограничения предметной области требуют уникальности соответствующих данных.
Пусть имеется следующая таблица T:
Для простоты я не включаю сюда другие столбцы, предполагая, что данные в них однозначно определяются значением в столбце name. Требуется сделать столбец name уникальным (скажем, первичным ключом), предварительно удалив дубликаты.
Распространенным решением данной проблемы является создание вспомогательной таблицы требуемой структуры, в которую копируются уникальные строки из таблицы T с последующим удалением таблицы T и переименованием вспомогательной таблицы. Ниже приводится код на языке T-SQL, реализующий данный алгоритм.
В результате получим то, что и требовалось:
При этом ограничение первичного ключа будет препятствовать появлению дубликатов впоследствии.
А можно ли обойтись без создания новой таблицы? Можно. Например, с помощью такого алгоритма:
— добавить новый столбец типа счетчик (IDENTITY), который перенумерует все имеющиеся строки в таблице;
— из каждой группы строк с одинаковым значением в столбце name удалить все строки за исключением строки с максимальным номером (или минимальным — это все равно, т.к. мы имеем дело с дубликатами);
— удалить вспомогательный столбец;
— наложить ограничение.
Вот пример реализации такого подхода:
А если без создания дополнительного столбца? Опять ответ утвердительный, но тут нам потребуются новые возможности языка, специфицированные в стандарте ANSI SQL-99. Идея состоит в том, чтобы создавать не постоянный столбец в таблице, который потом потребуется удалять, а виртуальный (вычисляемый). Этот столбец мы создадим с помощью оконных функций, присвоив ранг каждой строке внутри окна, определяемого равенством значений в столбце name. Наконец, мы удалим все строки с рангом выше 1.
Давайте подробно рассмотрим построение запроса на удаление дубликатов этим методом.
1. Нумерация строк
Мы не можем сразу ранжировать строки просто потому, что их не по чем ранжировать. Дело в том, что одинаковые строки будут иметь одинаковый ранг. Поэтому сначала пронумеруем их, упорядочив по столбцу name.
В результате получим
2. Ранжирование строк внутри групп дубликатов
К сожалению, запрещено (MS SQL Server) использовать оконные функции внутри оконных функций. Т.е. мы не можем написать так:
а потому используем подзапрос:
Ниже представлен результат этого запроса.
3. Удаление дубликатов из виртуальной таблицы
Недопустимо удалять записи из запроса, т.е. мы не можем воспользоваться таким вариантом:
т.к. в операторе DELETE допускается использовать только базовую таблицу или представление. Поэтому мы могли бы создать представление и удалить записи уже из него. Конечно, на самом деле записи удаляются из базовой таблицы, на которой создано представление. Итак, мы можем поступить следующим образом:
«Опять что-то создавать», — скажете вы. Не обязательно, и, чтобы доказать это, нам помогут общие табличные выражения (CTE), которые можно назвать виртуальными представлениями. CTE, хотя и не являются сохраняемыми в базе данных объектами, могут использоваться с операторами обновления. В результате все сводится к одному запросу:
Не забудьте только создать первичный ключ. 🙂
Попал по внешней ссылке на эту статью и решил себе возразить. 🙂
Вот эта фраза: «Мы не можем сразу ранжировать строки просто потому, что их не по чем ранжировать.»
Разумеется, это правильно, но мы можем отказаться от ранжирования (в ущерб обучению :-)), выполнив «псевдоранжирование». Дело в том, что есть возможность выполнить независимую нумерацию для каждой группы, если в предложении OVER для функции ROW_NUMBER использовать конструкцию PARTITION BY. Итак, можно вообще обойтись без функции RANK, если выполнить разбиение по name
Это упростит все последующие запросы, в частности, последнее решение задачи удаления дубликатов можно переписать в виде:
Как убрать дубликаты в mysql запросе?
Нужно из нее получить все from_id & to_id связанные с 5, т.е.
пользователь с id 5 написал сообщение пользователю 7, пользователю 8 и получил, например, сообщение от 7 и 6
Нужно узнать всех пользователей, проще говоря вывести с кем он общался
- Вопрос задан более трёх лет назад
- 11543 просмотра
- Вконтакте
Одним запросом можно сделать через UNION (объединение нескольких запросов)
Подробнее про UNION и DISTINCT с его участием тут: www.mysql.ru/docs/man/UNION.html
И ещё один способ с обычным DISTINCT одним запросом:
- можно указать distinct у конкретного поля (distinct from_id), не для этого случаях, вспомнить подходящий с ходу не удалось
- можно указать GROUP BY и перечислить нужные поля не указывая DISTINCT
Подсчёт дополнительной колонки unread и вывод даты последнего сообщения: