# GROUP BY
Results of a SELECT query can be grouped by one or more columns using the GROUP BY statement: all results with the same value in the grouped columns are aggregated together. This generates a table of partial results, instead of one result. GROUP BY can be used in conjunction with aggregation functions using the HAVING statement to define how non-grouped columns are aggregated.
# Basic GROUP BY example
It might be easier if you think of GROUP BY as "for each" for the sake of explanation. The query below:
"Give me the sum of MonthlySalary’s for each EmpID"
So if your table looked like this:
Sum wouldn’t appear to do anything because the sum of one number is that number. On the other hand if it looked like this:
Then it would because there are two EmpID 1’s to sum together.
# USE GROUP BY to COUNT the number of rows for each unique entry in a given column
Let’s say you want to generate counts or subtotals for a given value in a column.
Given this table, "Westerosians":
| Name | GreatHouseAllegience |
|---|---|
| Arya | Stark |
| Cercei | Lannister |
| Myrcella | Lannister |
| Yara | Greyjoy |
| Catelyn | Stark |
| Sansa | Stark |
Without GROUP BY, COUNT will simply return a total number of rows:
| Number_of_Westerosians |
|---|
| 6 |
But by adding GROUP BY, we can COUNT the users for each value in a given column, to return the number of people in a given Great House, say:
| House | Number_of_Westerosians |
|---|---|
| Stark | 3 |
| Greyjoy | 1 |
| Lannister | 2 |
It’s common to combine GROUP BY with ORDER BY to sort results by largest or smallest category:
| House | Number_of_Westerosians |
|---|---|
| Stark | 3 |
| Lannister | 2 |
| Greyjoy | 1 |
# Filter GROUP BY results using a HAVING clause
A HAVING clause filters the results of a GROUP BY expression. Note: The following examples are using the Library
Examples:
Return all authors that wrote more than one book (live example
Return all books that have more than three authors (live example
# ROLAP aggregation (Data Mining)
# Description
The SQL standard provides two additional aggregate operators. These use the polymorphic value "ALL" to denote the set of all values that an attribute can take. The two operators are:
- with data cube that it provides all possible combinations than the argument attributes of the clause.
- with roll up that it provides the aggregates obtained by considering the attributes in order from left to right compared how they are listed in the argument of the clause.
SQL standard versions that support these features: 1999,2003,2006,2008,2011.
# Examples
Consider this table:
| Food | Brand | Total_amount |
|---|---|---|
| Pasta | Brand1 | 100 |
| Pasta | Brand2 | 250 |
| Pizza | Brand2 | 300 |
# With cube
| Food | Brand | Total_amount |
|---|---|---|
| Pasta | Brand1 | 100 |
| Pasta | Brand2 | 250 |
| Pasta | ALL | 350 |
| Pizza | Brand2 | 300 |
| Pizza | ALL | 300 |
| ALL | Brand1 | 100 |
| ALL | Brand2 | 550 |
| ALL | ALL | 650 |
# With roll up
| Food | Brand | Total_amount |
|---|---|---|
| Pasta | Brand1 | 100 |
| Pasta | Brand2 | 250 |
| Pizza | Brand2 | 300 |
| Pasta | ALL | 350 |
| Pizza | ALL | 300 |
| ALL | ALL | 650 |
# Syntax
GROUP BY <
column-expression
| ROLLUP ( [ . n ] )
| CUBE ( [ . n ] )
| GROUPING SETS ( [ . n ] )
| () —calculates the grand total
> [ . n ]
Как работает группировка в sql
Давайте выполним запрос:
| id | home_type | has_tv | price |
|---|---|---|---|
| 1 | Private room | 1 | 149 |
| 2 | Entire home/apt | 0 | 225 |
| 3 | Private room | 1 | 150 |
| 4 | Entire home/apt | 1 | 89 |
| 5 | Entire home/apt | 0 | 80 |
| 6 | Entire home/apt | 0 | 200 |
| 7 | Private room | 0 | 60 |
| 8 | Private room | 1 | 79 |
| 9 | Private room | 1 | 79 |
| 10 | Entire home/apt | 1 | 150 |
| 11 | Entire home/apt | 1 | 135 |
| 12 | Private room | 0 | 85 |
| 13 | Private room | 0 | 89 |
| 14 | Private room | 0 | 85 |
| 15 | Entire home/apt | 1 | 120 |
| 40 | Shared room | 1 | 40 |
Так мы получили информацию по каждому сдаваемому жилому помещению. А что если мы хотим получить информацию не о каждой записи отдельно, а о группах, которые они образуют?
Например, такими группами могут выступать записи разбитые по типу жилья:
- Shared room (аренда комнаты на несколько человек)
- Private room (аренда целой комнаты)
- Entire home/apt (аренда целой квартиры)
Эти группы включают разные записи в таблице и, соответственно, обладают разными характеристиками, которые нам могут быть весьма полезны.
Такой полезной информацией о группах может быть:
- средняя стоимость аренды комнаты или целого жилого помещения
- количество сдаваемых жилых помещений каждого типа
Для ответов на все эти и многие другие вопросы есть оператор GROUP BY .
Для того, чтобы записи у нас образовали группы по типу жилья мы должны после GROUP BY указать home_type , т.е. поле, по которому будет происходить группировка.
| home_type |
|---|
| Private room |
| Entire home/apt |
| Shared room |
Следует иметь в виду, что для GROUP BY все значения NULL трактуются как равные, т.е. при группировке по полю, содержащему NULL -значения, все такие строки попадут в одну группу
При использовании оператора GROUP BY мы перешли от работы с отдельными записями на работу с образовавшимися группами. В связи с этим мы не можем просто вывести любое поле из записи (например, has_tv или price ), как мы это могли делать раньше. Так как в каждой группе может быть несколько записей и в каждой из них в этом поле может быть разное значение.
При использовании GROUP BY мы можем выводить только:
литералы, т.е. указанное явным образом фиксированные значения.
Мы можем их выводить, так как это фиксированные значения, которые ни от чего не зависят.
Например,
| home_type | literal |
|---|---|
| Private room | literal |
| Entire home/apt | literal |
| Shared room | literal |
результаты агрегатных функций, т.е. вычисленные значения на основании набора значений.
Более детальную информацию об агрегатных функциях мы затронем на следующем уроке. Но для примера рассмотрим агрегатную функцию AVG .
Функция AVG принимает в качестве аргумента название поля, по которому мы хотим вычислить среднее значение для каждой группы.
| home_type | avg_price |
|---|---|
| Private room | 89.4286 |
| Entire home/apt | 148.6667 |
| Shared room | 40 |
Так выполненный запрос сначала разбивает все записи из таблицы Rooms на 3 группы, опираясь на поле home_type . Далее, для каждой группы суммирует все значения, взятые из поля price у каждой записи, входящей в текущую группу, и затем полученный результат делится на количество записей в данной группе.
Мы можем их выводить, так как в рамках одной группы поля, по которым осуществлялась группировка, одинаковые.
Мы уже рассмотрели как записи в таблице группируются по одному полю. Для дополнительной иллюстрации это выглядит примерно так, когда поле группировки home_type :

При группировке по 2 и более полям принцип остается такой же, только теперь образовавшиеся группы дополнительно разбиваются на более мелкие группы в зависимости от второго поля группировки.
Пример группировки по home_type и has_tv :

Давайте проверим себя ? При использовании оператора GROUP BY в SELECT выражение мы можем выводить:
Группировки и оконные функции в Oracle
Привет, Хабр! В компании, где я работаю, часто проходят (за мат извините) митапы. На одном из них выступал мой коллега с докладом об оконных функциях и группировках Oracle. Эта тема показалась мне стоящей того, чтобы сделать о ней пост.
С самого начала хотелось бы уточнить, что в данном случае Oracle представлен как собирательный язык SQL. Группировки и методы их применения подходят ко всему семейству SQL (который понимается здесь как структурированный язык запросов) и применимы ко всем запросам с поправками на синтаксис каждого языка.
Всю необходимую информацию я постараюсь кратко и доступно объяснить в двух частях. Пост скорее будет полезен начинающим разработчикам. Кому интересно — добро пожаловать под кат.
Часть 1: предложения Order by, Group by, Having
Здесь мы поговорим о сортировке — Order by, группировке — Group by, фильтрации — Having и о плане запроса. Но обо всем по-порядку.
Order by
Оператор Order by выполняет сортировку выходных значений, т.е. сортирует извлекаемое значение по определенному столбцу. Сортировку также можно применять по псевдониму столбца, который определяется с помощью оператора.
Преимущество Order by в том, что его можно применять и к числовым, и к строковым столбцам. Строковые столбцы обычно сортируются по алфавиту.
Сортировка по возрастанию применяется по умолчанию. Если хотите отсортировать столбцы по убыванию — используйте дополнительный оператор DESC.
SELECT column1, column2, … (указывает на название)
FROM table_name
ORDER BY column1, column2… ASC|DESC;
Давайте все рассмотрим на примерах: 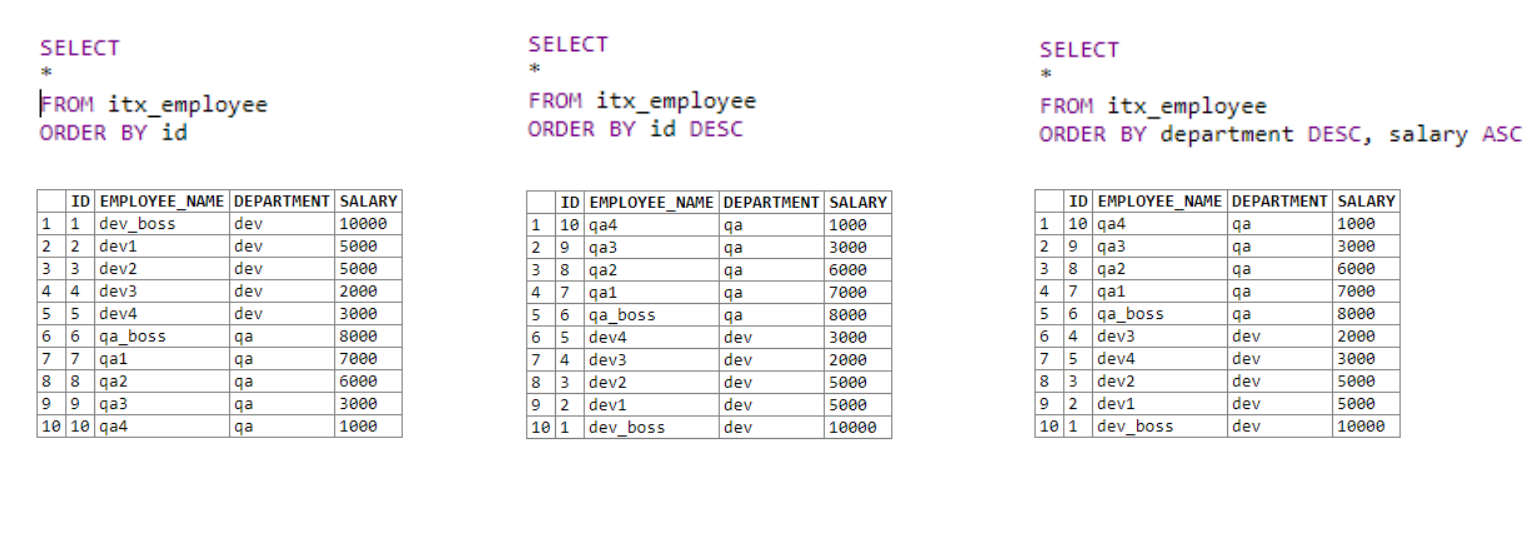
В первой таблице мы получаем все данные и сортируем их по возрастанию по столбцу ID.
Во второй мы также получаем все данные. Сортируем по столбцу ID по убыванию, используя ключевое слово DESC.
В третьей таблице используется несколько полей для сортировки. Сначала идет сортировка по отделу. При равенстве первого оператора для полей с одинаковым отделом применяется второе условие сортировки; в нашем случае — это зарплата.
Все довольно просто. Мы можем задать более одного условия сортировки, что позволяет более грамотно сортировать выходные списки.
Group by
В SQL оператор Group by собирает данные, полученные из базы данных в определенных группах. Группировка разделяет все данные на логические наборы, что дает возможность выполнять статистические вычисления отдельно в каждой группе.
Этот оператор используется для объединения результатов выборки по одному или нескольким столбцам. После группировки будет только одна запись для каждого значения, использованного в столбце.
С использованием оператора SQL Group by тесно связано использование агрегатных функций и оператор SQL Having. Агрегатная функция в SQL — это функция, возвращающая какое-либо одно значение по набору значений столбца. Например: COUNT(), MIN(), MAX(), AVG(), SUM()
SELECT column_name(s)
FROM table_name
WHERE condition
GROUP BY column_name(s)
ORDER BY column_name(s);
Group by стоит после условного оператора WHERE в запросе SELECT. По желанию можно использовать ORDER BY, чтобы отсортировать выходные значения.
Итак, опираясь на таблицу из предыдущего примера, нам нужно найти максимальную зарплату сотрудников каждого отдела. В итоговой выборке должно получиться название отдела и максимальная зарплата.
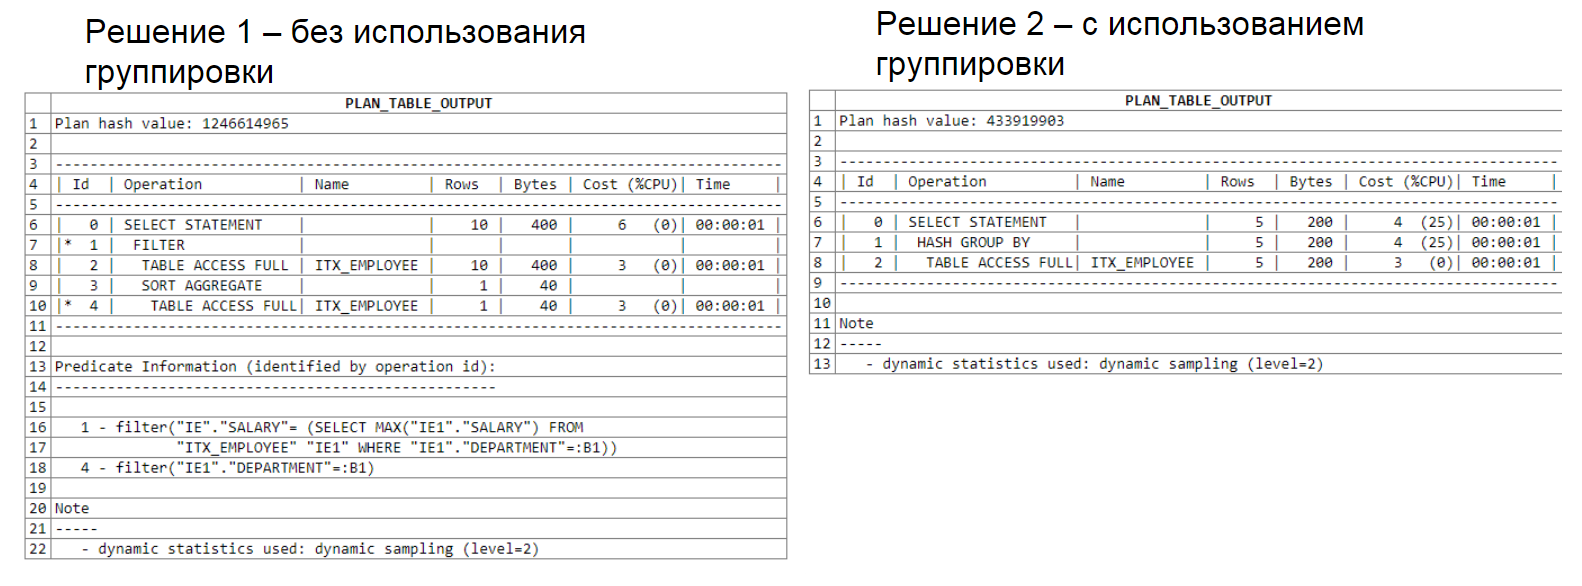
Решение 1 (без использования группировки):
Решение 2 (с использованием группировки):
В первом примере решаем задачу без использования группировки, но с использованием подселекта, т.е. в один селект вкладываем второй. Во втором решении используем группировку.
Второй пример вышел короче и читабельнее, хотя выполняет такие же функции, что и первый.
Как у нас работает Group by: сначала разбивает два отдела на группы qa и dev. Потом для каждого из них ищет максимальную зарплату.
Having
Having это инструмент фильтрации. Он указывает на результат выполнения агрегатных функций. Предложение Having используется в SQL там, где нельзя применить WHERE.
Если предложение WHERE определяет предикат для фильтрации строк, то Having используется после группировки для определения логичного предиката, фильтрующего группу по значениям агрегатных функций. Предложение необходимо для проверки значений, полученных при помощи агрегатных функций из групп строк.
SELECT column_name(s)
FROM table_name
WHERE condition
GROUP BY column_name(s)
HAVING condition
Сначала мы выводим отделы со средней зарплатой больше 4000. Затем выводим максимальную зарплату с применением фильтрации.
Решение 1 (без использования GROUP BY и HAVING):
Решение 2 (с использованием GROUP BY и HAVING):
В первом примере используется два подселекта: один для нахождения максимальной зарплаты, другой для фильтрации средней зарплаты. Второй пример, опять же, вышел намного проще и лаконичнее.
План запроса
Нередко бывают ситуации, когда запрос работает долго, потребляя значительные ресурсы памяти и дисков. Чтобы понять, почему запрос работает долго и неэффективно, мы можем посмотреть план запроса.
План запроса — это предполагаемый план выполнения запроса, т.е. как СУБД будет его выполнять. СУБД распишет все операции, которые будут выполняться в рамках подзапроса. Проанализировав все, мы сможем понять, где в запросе слабые места и с помощью плана запроса сможем оптимизировать их.
Исполнение любого SQL предложения в Oracle извлекает так называемый “план исполнения”. Этот план исполнения запроса является описанием того, как Oracle будет осуществлять выборку данных, согласно исполняемому SQL предложению. План представляет собой дерево, которое содержит порядок шагов и связь между ними.
К средствам, позволяющим получить предполагаемый план выполнения запроса, относятся Toad, SQL Navigator, PL/SQL Developer и др. Они выдают ряд показателей ресурсоемкости запроса, среди которых основными являются: cost — стоимость выполнения и cardinality (или rows) — кардинальность (или количество строк).
Чем больше значение этих показателей, тем менее эффективен запрос.
Ниже можно увидеть анализ плана запроса. В первом решении используется подселект, во втором — группировка. Обратите внимание, что в первом решении обработано 22 строки, во втором — 15.
Анализ плана запроса:
Ещё один анализ плана запроса, в котором применяется два подселекта: 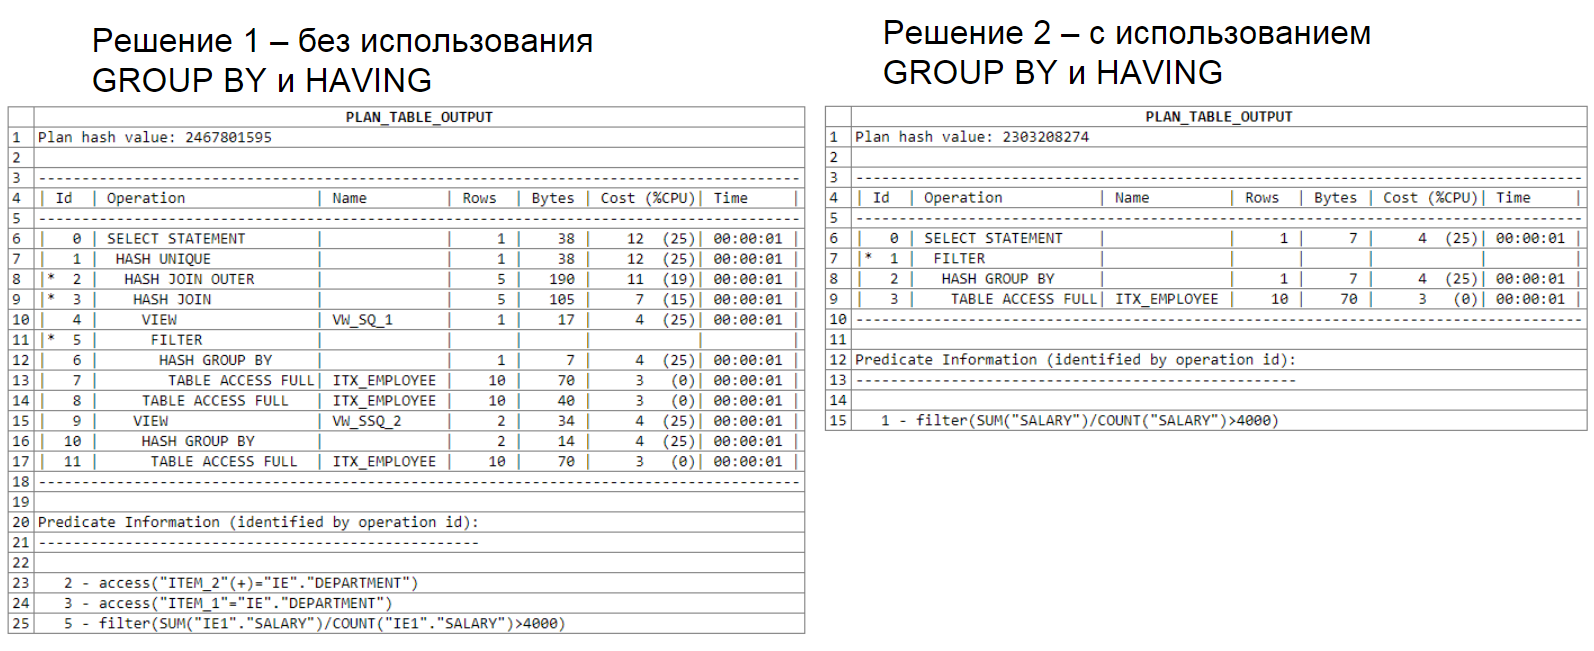
Этот пример приведен как вариант нерационального использования средств SQL и я не рекомендую вам его использовать в своих запросах.
Все перечисленные выше функции упростят вам жизнь при написании запросов и повысят качество и читабельность вашего кода.
Часть 2: Оконные функции
Оконные функции появились ещё в Microsoft SQL Server 2005. Они осуществляют вычисления в заданном диапазоне строк внутри предложения Select. Если говорить кратко, то “окно” — это набор строк, в рамках которого происходит вычисление. “Окно” позволяет уменьшить данные и более качественно их обработать. Такая функция позволяет разбивать весь набор данных на окна.
Оконные функции обладают огромным преимуществом. Нет необходимости формировать набор данных для расчетов, что позволяет сохранить все строки набора с их уникальными ID. Результат работы оконных функций добавляется к результатирующей выборке в еще одно поле.
SELECT column_name(s)
Агрегирующая функция (столбец для вычислений)
OVER ([PARTITION BY столбец для группировки]
FROM table_name
[ORDER BY столбец для сортировки]
[ROWS или RANGE выражение для ограничения строк в пределах группы])
OVER PARTITION BY — это свойство для задания размеров окна. Здесь можно указывать дополнительную информацию, давать служебные команды, например добавить номер строки. Синтаксис оконной функции вписывается прямо в выборку столбцов.
Давайте рассмотрим все на примере: в нашу таблицу добавился еще один отдел, теперь в таблице 15 строк. Мы попытаемся вывести работников, их з/п, а также максимальную з/п организации.
/>
В первом поле мы берем имя, во втором — зарплату. Дальше мы применяем оконную функцию over(). Используем её для получения максимальной зарплаты по всей организации, так как не указаны размеры “окна”. Over() с пустыми скобками применяется для всей выборки. Поэтому везде максимальная зарплата — 10 000. Результат действия оконной функции добавляется к каждой строчке.
Если убрать из четвертой строки запроса упоминание оконной функции, т.е. остается только max (salary), то запрос не сработает. Максимальную зарплату просто не удалось бы посчитать. Так как данные обрабатывались бы построчно, и на момент вызова max (salary) было бы только одно число текущей строки, т.е. текущего работника. Вот тут и можно заметить преимущество оконной функции. В момент вызова она работает со всем окном и со всеми доступными данными.
Давайте рассмотрим еще один пример, где нужно вывести максимальную з/п каждого отдела:
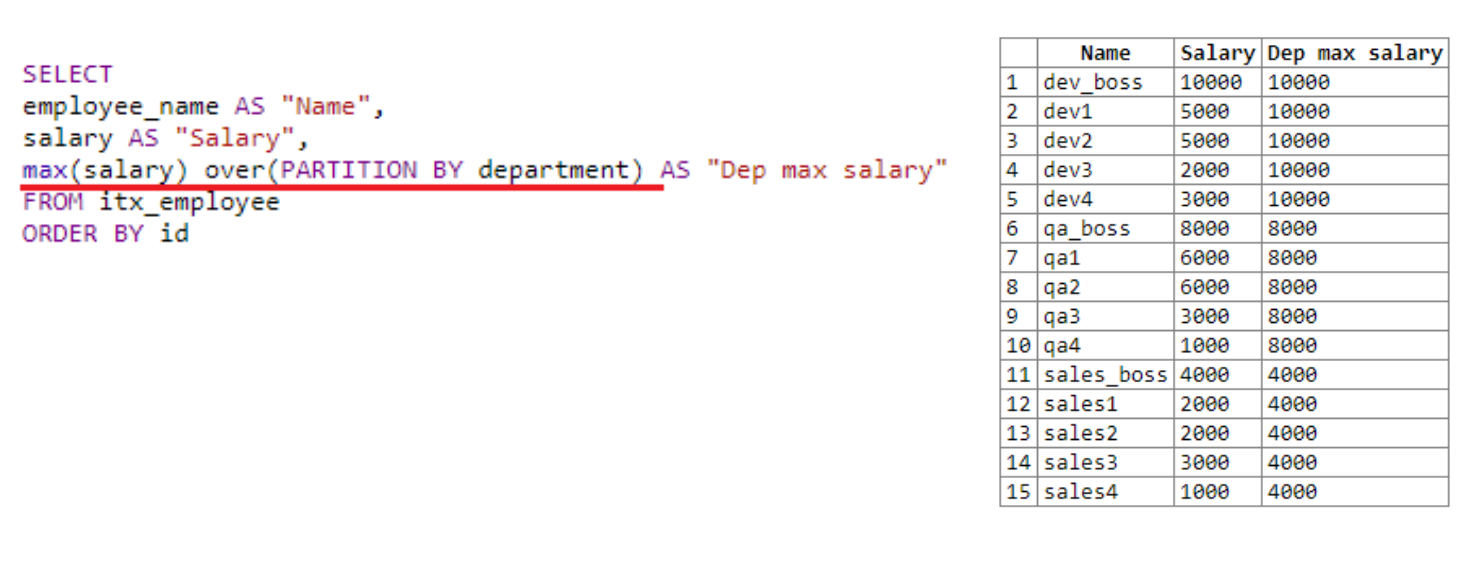
Фактически мы задаем рамки для “окна”, разбивая его на отделы. В качестве ранжирующего примера мы указываем department. У нас есть три отдела: dev, qa и sales.
“Окно” находит максимальную зарплату для каждого отдела. В результате выборки мы видим, что оно нашло максимальную зарплату сначала для dev, затем для qa, потом для sales. Как уже упоминалось выше, результат оконной функции записывается в результат выборки каждой строки.
В предыдущем примере в скобках после over не было указано. Здесь мы использовали PARTITION BY, которое позволило задать размеры нашего окна. Здесь можно указывать какую-то доп информацию, передавать служебные команды, например, номер строки.
Заключение
SQL не так прост, как кажется на первый взгляд. Все описанное выше — это базовые возможности оконных функций. С их помощью можно “упростить” наши запросы. Но в них скрыто намного больше потенциала: есть служебные операторы (например ROWS или RANGE), которые можно комбинировать, добавляя больше функциональности запросам.
Оператор SQL GROUP BY для группировки в запросах
Оператор SQL GROUP BY служит для распределения строк — результата запроса — по группам, в которых значения некоторого столбца, по которому происходит группировка, являются одинаковыми. Группировку можно производить как по одному столбцу, так и по нескольким.
Часто оператор SQL GROUP BY применяется вместе с агрегатными функциями (COUNT, SUM, AVG, MAX, MIN). В этих случаях агрегатные функции служат для вычисления соответствующего агрегатного значения ко всему набору строк, для которых некоторый столбец — общий.
Оператор GROUP BY имеет следующий синтаксис:
Группировка по одному столбцу без агрегатных функций
Если в результате запроса требуется вывести один столбец и по этому же столбцу производится группировка, то оператор GROUP BY просто выбирает уникальные значения и убирает дубликаты, то есть выполняет те же задачи, что и ключевое слово DISTINCT.
Если вы хотите выполнить запросы к базе данных из этого урока на MS SQL Server, но эта СУБД не установлена на вашем компьютере, то ее можно установить, пользуясь инструкцией по этой ссылке .
Скрипт для создания базы данных библиотеки, её таблиц и заполения таблиц данными — в файле по этой ссылке .
В примерах работаем с базой данных библиотеки и ее таблицей «Книга в пользовании» (Bookinuse). Отметим, что оператор GROUP BY ведёт себя несколько по-разному в MySQL и в MS SQL Server. Эти различия будут показаны на примерах.
| Author | Title | Pubyear | Inv_No | Customer_ID |
| Толстой | Война и мир | 2005 | 28 | 65 |
| Чехов | Вишневый сад | 2000 | 17 | 31 |
| Чехов | Избранные рассказы | 2011 | 19 | 120 |
| Чехов | Вишневый сад | 1991 | 5 | 65 |
| Ильф и Петров | Двенадцать стульев | 1985 | 3 | 31 |
| Маяковский | Поэмы | 1983 | 2 | 120 |
| Пастернак | Доктор Живаго | 2006 | 69 | 120 |
| Толстой | Воскресенье | 2006 | 77 | 47 |
| Толстой | Анна Каренина | 1989 | 7 | 205 |
| Пушкин | Капитанская дочка | 2004 | 25 | 47 |
| Гоголь | Пьесы | 2007 | 81 | 47 |
| Чехов | Избранные рассказы | 1987 | 4 | 205 |
| Пушкин | Сочинения, т.1 | 1984 | 6 | 47 |
| Пастернак | Избранное | 2000 | 137 | 18 |
| Пушкин | Сочинения, т.2 | 1984 | 8 | 205 |
| NULL | Наука и жизнь 9 2018 | 2019 | 127 | 18 |
| Чехов | Ранние рассказы | 2001 | 171 | 31 |
Пример 1. Вывести авторов выданных книг, сгруппировав их. Пишем следующий запрос:
Этот запрос вернёт следующий результат:
| Author |
| NULL |
| Гоголь |
| Ильф и Петров |
| Маяковский |
| Пастернак |
| Пушкин |
| Толстой |
| Чехов |
Как видим, в таблице стало меньше строк, так как фамилии авторов остались каждая по одной.
В следующем примере увидим, что оператор GROUP BY не следует путать с оператором ORDER BY и поймём, чем эти операторы отличаются друг от друга.
Пример 2. Вывести авторов и названия выданных книг, сгруппировав по авторам. Пишем следующий запрос, который допустим в MySQL:
Этот запрос вернёт следующий результат:
| Author | Title |
| NULL | Наука и жизнь 9 2018 |
| Гоголь | Пьесы |
| Ильф и Петров | Двенадцать стульев |
| Маяковский | Поэмы |
| Пастернак | Доктор Живаго |
| Пушкин | Капитанская дочка |
| Толстой | Война и мир |
| Чехов | Вишнёвый сад |
Как видим, в таблице каждому автору соответствует лишь одна книга, причём та, которая в таблице BOOKINUSE является первой по порядку записей.
Если бы нам требовалось вывести все книги, причём авторы должны были бы следовать не «вразброс», а по порядку: сначала Гоголь и все его книги, затем другие авторы и все их книги, то мы применили бы не оператор GROUP BY, а оператор ORDER BY.
Группировка по нескольким столбцам без агрегатных функций
И всё же вывести все записи, соответствующие значению столбца, по которому происходит группировка, можно. Но в этом случае в результирующей таблице должен появиться ещё один столбец. Такой случай проиллюстирован в следующем примере.
Пример 3. Вывести авторов, названия выданных книг, ID пользователя и инвентарный номер выданной книги. Сгруппировать по авторам, ID пользователя и инвентарному номеру. На MySQL запрос будет следующим:
Этот запрос вернёт следующий результат:
| Author | Title | Customer_ID | Inv_no |
| Гоголь | Пьесы | 47 | 81 |
| Ильф и Петров | Двенадцать стульев | 31 | 3 |
| Маяковский | Поэмы | 120 | 2 |
| Пастернак | Избранное | 18 | 137 |
| Пастернак | Доктор Живаго | 120 | 69 |
| Пушкин | Капитанская дочка | 47 | 25 |
| Пушкин | Сочинения, т.1 | 47 | 6 |
| Пушкин | Сочинения, т.2 | 205 | 8 |
| Толстой | Воскресенье | 47 | 77 |
| Толстой | Война и мир | 65 | 28 |
| Толстой | Анна Каренина | 205 | 7 |
| Чехов | Вишневый сад | 31 | 19 |
| Чехов | Ранние рассказы | 31 | 171 |
| Чехов | Вишневый сад | 65 | 5 |
| Чехов | Избранные рассказы | 120 | 19 |
| Чехов | Избранные рассказы | 205 | 4 |
Как видим, в результирующей таблице присутствуют все книги всех авторов, причём авторы следуют по порядку, как если бы мы применили оператор ORDER BY. Кроме того, видно, что записи сгруппированы и по второму указанному столбцу — Customer_ID. Так, у автора Пушкина сначала перечисляются книги, выданные пользователю с Customer_ID 47, а затем — 205. У автора Чехова сначала перечисляются книги, выданные пользователю с Customer_ID 31, а затем — с другими номерами. Третий столбец, по которому происходит группировка — Inv_no — добавлен только для того, чтобы в результирующей таблице выводились все строки, соответствующие значениям ранее перечисленных столбцов для группировки, а не только уникальные.
По-другому ведёт себя оператор GROUP BY в MS SQL Server и в случае этого запроса.