2.20. Переменные
Язык запросов Transact-SQL отличается не только мощной поддержкой транзакций, но и поддержкой переменных, благодаря которым, становиться возможным создание более сложных запросов и даже целых программ. Переменные есть и в других вариантах языка SQL (в том числе и PL/SQL), поэтому это не индивидуальное преимущество именно MS SQL Server.
Переменные – элементы языка с присвоенными значениями. Если честно, то такое определение мне не очень нравиться, потому что не отражает суть переменных и абсолютно не понятно, что это и для чего нужно. Чтобы понять, что такое переменная, нужно вспомнить, как данные хранятся в памяти.
Когда вы заносите в компьютер какое-то число или строку, то в оперативной памяти для хранения этих данных выделяется участок памяти. Эта память имеет числовой адрес, а как известно, числа запоминать намного сложнее. Лично я могу помнить не более 10 номеров телефонов, а все остальное записываю в блокнот. Понятные слова запоминаются лучше и с ними проще работать. Чтобы обратиться к данным в памяти, необходимо указать адрес, по которому находятся нужное нам число или строка.
Чтобы не мучаться с числами, придумали переменные, которые, по своей сути являются именами участков в памяти, где находятся данные.
Вы объявляете локальные переменные в операторе DECLARE и после этого назначаете ему индивидуальное значение с помощью операторов SET или SELECT. Используйте оператор SET, когда желаемое значение известно, а оператор SELECT, когда вам нужно получить желаемое значение из таблицы. После того, как вы назначили переменное значение, вы можете использовать его в операторах, группах и процедурах, в которых они объявлены. Группы — это набор операторов Transact-SQL, которые отправляются вместе и исполняются как группа (несколько последовательно выполняемых команд). Мы не раз уже использовали группы, и вы их можете увидеть в листингах 2.9, 2.10 и так далее.
Имя локальной переменной начинается с одного символом @ в начале имени. Общий вид объявления переменной:
Пример установки переменной значения:
После ключевого слова указывается локальная переменная (@имя). Далее идет знак равенства и значение, которое должно быть присвоено переменной.
Следующий пример объявляет две переменные и использует их:
Листинг 2.13. Пример использования переменных
В результате на экране мы должны увидеть сообщение:
Теперь посмотрим, что происходит в сценарии. Сначала мы объявляем две переменные. Это можно сделать двумя способами. Первый – после ключевого слова DECLARE перечислить через запятую имена переменных и их тип, как показано в листинге 2.13. Напоминаю, что имя переменной должно начинаться с @.
Второй способ – каждую переменную описать в отдельной секции DECLARE:
Теперь переменной @vLastName, которая должна хранить фамилию работника, присваиваем значение ‘%СИДОРОВ’. Вначале фамилии стоит знак %, потому что в конце раздела 2.17 мы прибавили в начало каждой фамилии буквы mr. Если вы выполняли этот запрос, то обязательно необходимо добавить знак процента или переменной присвоить значение ‘mr.СИДОРОВ’.
Теперь выполняем запрос SELECT. Давайте рассмотрим его построчно:
- SELECT @vFirstName = vcName – после оператора SELECT, указываем, что необходимо значение поля «vcName» присвоить переменной @vFirstName;
- FROM tbPeoples – данные выбираются из таблицы tbPeoples;
- WHERE vcFamil LIKE @vLastName – в условии поиска мы указываем, что поле «vcFamil» должно соответствовать содержимому шаблона в переменной @vLastName.
Новой для нас является и последняя строка, в которой происходит вывод на экран сообщения с помощью оператора PRINT. После оператора указывается сообщение, которое необходимо вывести. Сообщение может быть указано через пробел или в скобках. Следующий пример показывает, как использовать сообщение в скобках:
Содержимое переменной можно использовать и в качестве имени транзакции. В следующем примере, мы объявляем переменную @Transname, присваиваем ей значение, и используем в качестве имени транзакции:
Глобальные переменные начинаются с двух символов @@. Когда вы создаете собственные программы на языке Transact-SQL, то рекомендую использовать только локальные переменные, чтобы случайно не спровоцировать конфликта имен или значений. Так как глобальные переменные доступны всем, то их может увидеть любой пользователь, подключенный в данный момент к серверу.
И все же, глобальные переменные нужны. Существует несколько глобальных переменных, через которые можно определить полезную информацию о сервере или о времени выполнения. Давайте бегло рассмотрим некоторые из них:
- @@SERVERNAME – содержит имя экземпляра MS SQL Server;
- @@VERSION – информация о версии SQL Server;
- @@ROWCOUNT – содержит количество строк, обработанных последней выполненной командой;
- @@SPID – идентификатор текущего процесса;
- @@TRANCOUNT – уровень вложенности транзакций;
- @@NESTLEVEL – уровень вложенности при выполнении хранимых процедур и триггеров;
- @@OPTIONS – текущие настройки серверных параметров;
- @@ERROR – содержит код ошибки последней выполненной команды;
- @@IDENTITY – последнее значение счетчика, которое было использовано после добавления строки.
- @@CURSOR_ROWS – возвращает количество записей, полученных последней командой открытия курсора.
В следующих главах мы еще будем возвращаться к глобальным переменным и некоторые из них рассмотрим более подробно. Рассматривать все переменные сейчас не имеет смысла, потому что у нас еще не достаточно информации о языке Transact-SQL и базе данных MS SQL Server. А сейчас ограничимся только общими понятиями и простым примером.
В качестве примера, давайте посмотрим, как определить имя установленного экземпляра MS SQL Server. Для этого необходимо выполнить следующую команду:
В моем случае я увидел в качестве результата строку с единственным безымянным полем, в котором находился текст: CYD\FLENOV.
SQL-Ex blog
Переменные SQL в скриптах, функциях, хранимых процедурах, SQLCMD и т.д.
- Что такое переменные?
- Что такое типы переменных?
- Как объявить переменную?
- Как установить переменную?
- Зачем использовать переменные?
- Как использовать переменные в хранимых процедурах?
- Как использовать переменные в функциях?
- Как использовать переменные с SQLCMD?
- Как использовать переменные в скриптах?
- Как использовать переменные с SSIS?
Что такое переменные?
Переменная — это значение, которое может динамически меняться в программе. Переменные могут иметь различные типы данных и использоваться в базах данных SQL для придания большей гибкости операторам SQL вместо значений жесткого кодирования, которые постоянно меняются.
Что такое типы переменных?
- Числовые (int, smallint, money, decimal, bigint, numeric, bit, smallmoney, tinyint, float, real)
- Дата и/или время (date, datetime2, datetime, datetimeoffset, smalldatetime, time)
- Символы (char, varchar, text, nchar, nvarchar и ntext)
- Двоичные типы данных, например, image
- XML
- sql_variant, который может поддерживать различные типы данных
- Uniqueidentifier
- Переменные пространственной геометрии и пространственной географии
- Курсоры
- Предложение WHERE
- а также табличные переменные
Как объявить переменную SQL?
Базовый синтаксис объявления переменной следующий:
Для объявления переменной необходимо использовать слово DECLARE, после чего указать имя с префиксом @ и тип данных.
В следующем примере показано, как объявить переменную типа smallint.
Следующий пример показывает, как объявить и установить значение переменной, и использовать ее в операторе SELECT.

Следующий пример объявляет переменную @mytext типа varchar и присваивает ей значение Hello.

Обратите внимание, что результат отображает только первую букву слова Hello. Это происходит потому, что значением по умолчанию типа данных nvarchar или varchar является единственный символ. Если вам нужно больше символов, укажите длину. Следующий пример использует длину 10 символов.

Следующий пример показывает, как объявить переменную типа даты и присвоить ей значение. Затем мы отображаем дату в формате dd-MM-yyyy.

Как установить значение переменной SQL?
Вы можете объявить переменную, и сразу присвоить ей значение, как мы делали выше.
Вот другой подход установить переменную двумя строчками кода, а третья строка используется для вывода значения.
Второй пример присваивает значение непосредственно в операторе DECLARE, как в примерах выше.
Третий пример показывает как объявить переменную, а затем присвоить ей значение с помощью оператора SET во второй строке кода.
Результаты для всех трех примеров будут одинаковы.

Географические переменные
SQL Server имеет геопространственные типы данных, и в следующем примере мы объявляем географическую переменную с именем location, и присваиваем ей значения.
Ниже показан результат.

Чтобы больше узнать о типах данных Geography и Geometry, обратитесь к следующей статье.
Табличные переменные
Еще одним типом переменных является табличная переменная. Она подобна таблице, но является переменной. Вы используете префикс @ в имени переменной, а в остальном она подобна базовой таблице.
Следующий пример создает переменную с именем @TestTabe, а затем вставляет значения и выполняет выборку.

Более подробно о табличных переменных вы можете прочитать в статье.
Зачем использовать переменные SQL?
Переменные в T-SQL позволяют создавать интеллектуальный и динамичный код. Это дает больше возможностей пользователю для получения информации удобным способом, автоматизировать задачи и повторно использовать код. Все языки программирования используют переменные, и T-SQL не является исключением.
Как использовать переменные в хранимых процедурах?
Хранимые процедуры очень популярны в SQL Server. Они используются чаще, чем функции, во многом благодаря своей гибкости и простоте использования.
В следующем примере показывается, как создать хранимую процедуру с именем dbo.uspGetAddress. Входным параметром является @City, и хранимая процедура выведет все столбцы таблицы Person.address, когда город равен городу, переданному через аргумент процедуры. Выполните этот код в своей базе данных AdventureWorks.
В этом примере значением входного параметра будет New York.

Более подробно о хранимых процедурах можно узнать в статье.
Как использовать переменные в функциях SQL?
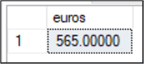
Вы можете также использовать переменные с функциями. Следующий пример показывает, как создать функцию, которая принимает сумму денег в USD, курс обмена и вычисляет сумму в евро.
Следующий пример показывает вызов этой функции.
Как использовать переменные с SQLCMD?
SQLCMD — это командная строка SQL Server. Если вам нравится автоматизировать задачи с помощью bat-файлов, SQLCMD — это то, что вам нужно. Если вы не знакомы с SQLCMD, но хотите познакомиться, обратитесь к следующей статье.
В командной строке Windows выполните эту команду для подключения к SQL, используя аккаунт Windows.
В sqlcmd перейдем к базе данных AdventureWorks, как показано ниже.
1> use adventureworks2019
2> go
Следующий пример установит переменную с именем tablename и значением humanresources.department, а затем сделает выборку из этой переменной.
1> :setvar tablename humanresources.department
1> select * from $(tablename)
2> go
Если все правильно, вы увидите данные в этой таблице.

Как использовать переменные в скрипте?
Вы можете также передать переменные в скрипт. Следующий пример создаст переменную с именем columnname1. Мы присвоим ей значение DepartmentID.
В примере мы создадим скрипт с именем myquery.sqlЮ который сохраним в папке sqlcmd.
USE AdventureWorks2019
GO
SELECT
$(columnname1)
from
[HumanResources].[Department]
Выйдите из sqlcmd, если вы еще находитесь там, и в командной строке Windows выполните команду:
sqlcmd -v columnname1 =DepartmentID -i c:\sqlcmd\myquery.sql
В командной строке будет выполнен оператор «select departmentid from humanresources.department».

Как использовать переменные в SSIS?
Переменные SSIS совершенно отличаются от переменных T-SQL. SSIS — это графическая среда, используемая для интеграции данных и которая имеет свои собственные переменные. Чтобы увидеть переменные в проекте SSIS, пройдите в Extensions > SSIS >Variables или для более ранних версий VS — SSIS > Variables.

Вы можете добавлять, удалять переменные на панели variables.

Существуют различные типы переменных в SSIS, например, Int32, int64, Object и Sbyte.
Переменные MySQL 2 мин для чтения
 Добавить в избранное

Введение в пользовательские переменные MySQL
Иногда вы хотите передать значение из оператора SQL в другой оператор SQL. Для этого вы сохраняете значение в пользовательской переменной MySQL в первом операторе и ссылаетесь на него в последующих инструкциях.
Для создания пользовательской переменной вы используете формат @variable_name, в котором она variable_name состоит из буквенно-цифровых символов. Максимальная длина пользовательской переменной составляет 64 символа с MySQL 5.7.5
Пользовательские переменные не чувствительны к регистру. Это означает, что @id и @ID то же самое.
Вы можете назначить пользовательскую переменную определенным типам данных, таким как целое число, число с плавающей запятой, десятичное число, строка или NULL.
Пользовательская переменная, определенная одним клиентом, не видна другим клиентам. Другими словами, пользовательская переменная является специфичной для сессии.
Обратите внимание, что пользовательские переменные являются специфичным для MySQL расширением стандарта SQL. Они могут быть недоступны в других системах баз данных.
Переменная MySQL
Есть два способа присвоить значение пользовательской переменной.
Первый способ заключается в следующем:
Вы можете использовать либо : =, либо = как оператор присваивания в операторе SET. Например, оператор присваивает число 100 переменной @counter.
Второй способ присвоения значения переменной — использование оператора SELECT. В этом случае вы должны использовать оператор присваивания : =, потому что в операторе SELECT в MySQL рассматривает оператор = как оператор равенства.
После назначения вы можете использовать переменную в последующем операторе, где выражение разрешено, например, в предложении WHERE, операторе INSERT или UPDATE.
Примеры переменных MySQL
Следующий оператор получает самый дорогой продукт в таблице products и назначает цену пользовательской переменной @msrp:

Следующий оператор использует переменную @msrp для запроса информации о самом дорогом продукте.
Иногда вы хотите вставить строку в таблицу, получить последний идентификатор вставки и использовать его для вставки данных в другую таблицу. В этом случае вы можете использовать пользовательскую переменную для хранения самого последнего идентификатора, сгенерированного столбцом AUTO_INCREMENT, следующим образом.
Пользовательская переменная может содержать только одно значение. Если оператор SELECT возвращает несколько значений, переменная будет принимать значение последней строки в результате.


В этой статье мы показали, как использовать переменные MySQL в операторах SQL для передачи данных между операторами в сеансе.
Если вы нашли ошибку, пожалуйста, выделите фрагмент текста и нажмите Ctrl+Enter.
MySQL — Использование переменных в запросе
Довольно часто спрашивают, есть ли аналоги аналитических (оконных) функций в MySQL. Примечание. На момент написания статьи таких аналогов не было, однако статья и ныне представляет собой академический интерес в плане разбора оригинального для MySQL подхода к использованию переменных.
Для замены аналитических функций часто используют запросы с самосоединением, сложные подзапросы и прочее. Большинство таких решений оказываются неэффективными с точки зрения производительности.
Также в MySQL нет рекурсии. Однако с некоторой частью задач, которые обычно решаются аналитическими функциями или рекурсией, можно справиться и средствами MySQL.
Одним из этих средств является уникальный, нехарактерный для прочих СУБД механизм работы с переменными внутри запроса SQL. Мы можем объявить переменную внутри запроса, менять ей значение и подставлять в SELECT для вывода. Причем порядок обработки строк в запросе и, как следствие, порядок присвоения значений переменным можно задать в пользовательской сортировке!
Предупреждение. В статье подразумевается, что обработка выражений в предложении SELECT осуществляется слева направо, однако официального подтверждения такого порядка обработки в документации MySQL нет. Это необходимо иметь в виду при смене версии сервера. Для гарантии последовательности вычисления можно использовать фиктивный оператор CASE или IF.
Аналог рекурсии
Рассмотрим простой пример, который генерирует последовательность Фибоначчи (в последовательности Фибоначчи каждый член равен сумме двух предыдущих, а первые 2 равны единице):
Данный запрос генерирует 18 чисел Фибоначчи, не считая первых двух:
Разберём теперь как оно работает.
В строчках 5) 6) генерируется 9 записей. Тут ничего необычного.
В строчке 7) мы объявляем две переменные @I, @J и присваиваем им 1.
В строке 3) происходит следующее: сначала переменной @I присваивается сумма двух переменных. Затем то же самое присваиваем переменной @J, причем с учетом того, что значение @I уже поменялось.
Другими словами, вычисления в SELECT выполняются слева направо – см. также замечание в начале статьи.
Причем изменение переменных осуществляется в каждой из наших 9 записей, т.е. при обработке каждой новой строки в переменных @I и @J будут содержаться значения, вычисленные при обработке предыдущей строки.
Чтобы решить эту же задачу средствами других СУБД, нам пришлось бы писать рекурсивный запрос!
Примечание:
Переменные нужно объявлять в отдельном подзапросе (строка 7), если бы мы объявили переменную в предложении SELECT, она, скорее всего, вычислилась бы только 1 раз (хотя конкретное поведение будет зависеть от версии сервера). Тип переменной определяется значением, которым она инициализирована. Этот тип может динамически меняться. Если переменной присвоить NULL, её типом будет BLOB.
Порядок обработки строк в SELECT, как было сказано выше, зависит от пользовательской сортировки. Простой пример нумерации строк в заданном порядке:
Аналоги аналитических функций
Переменные также можно использовать для замены аналитических функций. Далее несколько примеров. Для простоты будем считать, что все поля NOT NULL, а сортировка и партиционирование (PARTITION BY) происходят по одному полю. Использование NULL значений и более сложных сортировок сделает примеры более громоздкими, но суть не поменяет.
Для примеров создадим таблицу TestTable:
где
group_id – идентификатор группы (аналог окна аналитической функции);
order_id – уникальное поле, по которому будет производиться сортировка;
value – некоторое числовое значение.
Заполним нашу таблицу тестовыми данными:
Примеры замены некоторых аналитических функций.
1) ROW_NUMBER() OVER(ORDER BY order_id)
group_id order_id value RowNum
1 1 1 1
1 2 2 2
1 3 2 3
2 4 1 4
2 5 2 5
2 6 3 6
3 7 1 7
3 8 2 8
4 9 1 9
3 11 2 10
2) ROW_NUMBER() OVER(PARTITION BY group_id ORDER BY order_id)
group_id order_id value RowNum
1 1 1 1
1 2 2 2
1 3 2 3
2 4 1 1
2 5 2 2
2 6 3 3
3 7 1 1
3 8 2 2
3 11 2 3
4 9 1 1
3) SUM(value) OVER(PARTITION BY group_id ORDER BY order_id)
group_id order_id value RunningTotal
1 1 1 1
1 2 2 3
1 3 2 5
2 4 1 1
2 5 2 3
2 6 3 6
3 7 1 1
3 8 2 3
3 11 2 5
4 9 1 1
4) LAG(value) OVER(PARTITION BY group_id ORDER BY order_id)
group_id order_id value LAG
1 1 1 NULL
1 2 2 1
1 3 2 2
2 4 1 NULL
2 5 2 1
2 6 3 2
3 7 1 NULL
3 8 2 1
3 11 2 2
4 9 1 NULL
Для LEAD всё то же самое, только нужно сменить сортировку на ORDER BY group_id, order_id DESC
Для функций COUNT, MIN, MAX всё несколько сложнее, поскольку, пока мы не проанализируем все строчки в группе(окне), мы не сможем узнать значение функции. MS SQL, например, для этих целей «спулит» окно (временно помещает строки окна в скрытую буферную таблицу для повторного к ним обращения), в MySQL такой возможности нет. Но мы можем для каждого окна вычислить значение функции в последней строке при заданной сортировке (т.е. после анализа всего окна), а затем, отсортировав строки в окне в обратном порядке, проставить вычисленное значение по всему окну.
Таким образом, нам понадобится две сортировки. Чтобы итоговая сортировка осталась той же, что и в примерах выше, отсортируем сначала по полям group_id ASC, order_id DESC, затем по полям group_id ASC, order_id ASC.
5) COUNT(*) OVER(PARTITION BY group_id)
В первой сортировке мы просто нумеруем записи. Во второй всем строкам окна присваиваем максимальный номер, который и будет соответствовать количеству строк в окне.
group_id order_id value Cnt
1 1 1 3
1 2 2 3
1 3 2 3
2 4 1 3
2 5 2 3
2 6 3 3
3 7 1 3
3 8 2 3
3 11 2 3
4 9 1 1
Функции MAX и MIN вычисляются по аналогии. Приведу только пример для MAX:
6) MAX(value) OVER(PARTITION BY group_id)
group_id order_id value MaxVal
1 1 1 2
1 2 2 2
1 3 2 2
2 4 1 3
2 5 2 3
2 6 3 3
3 7 1 2
3 8 2 2
3 11 2 2
4 9 1 1
7) COUNT(DISTINCT value) OVER(PARTITION BY group_id)
Интересная вещь, которая отсутствует в MS SQL Server, но её можно вычислить с подзапросом, взяв MAX от RANK. Так же поступим и здесь. В первой сортировке вычислим RANK() OVER(PARTITION BY group_id ORDER BY value DESC), затем во второй сортировке проставим максимальное значение всем строкам в каждом окне:
group_id order_id value Cnt
1 1 1 2
1 2 2 2
1 3 2 2
2 4 1 3
2 5 2 3
2 6 3 3
3 7 1 2
3 8 2 2
3 11 2 2
4 9 1 1
Производительность
Для начала сравним по производительности нумерацию строк в запросе с помощью самосоединения и с помощью переменных.
1) Классический способ с самомоединением
Что на 10000 записей в таблице TestTable выдаёт:
Duration / Fetch
16.084 sec / 0.016 sec
2) С использованием переменных:
Duration / Fetch
0.016 sec / 0.015 sec
Результат говорит сам за себя. Однако надо понимать, что вычисленные с помощью переменных значения не оптимально использовать в условиях фильтрации. Сортировка и вычисление будут происходить для ВСЕХ строк, несмотря на то, что в итоге нам нужна только малая их часть.
Рассмотрим более подробно на примере такой задачи:
Вывести по 2 первые строки из таблицы TestTable для каждого значения group_id, отсортированных по order_id.
Вот как эта задача решалась бы в СУБД с поддержкой аналитических функций:
Однако оптимизатор MySQL ничего не знает о том, по каким правилам мы вычисляем поле RowNum. Ему придётся пронумеровать ВСЕ строки, и только потом отобрать нужные.
Теперь представьте, что у нас 1 миллион записей и 20 уникальных значений group_id. Т.е. чтобы выбрать 40 строк, MySQL будет вычислять значение RowNum для миллиона строк! Красивого решения этой задачи одним запросом в MySQL нет. Но можно сначала получить список уникальных значений group_id, например, так:
Затем средствами любого другого языка программирования сгенерировать запрос вида:
20 лёгких запросов отработают намного быстрее, чем вычисление RowNum для миллиона строк.