Как создать и выполнить SQL запрос к базе данных. Обзор основных инструментов
Приветствую Вас на сайте Info-Comp.ru! Сегодня я продолжаю рассказ о языке SQL, и в этом материале я немного расскажу о том, как создаются и выполняются SQL запросы к базе данных, а точнее какие инструменты (программы) для этого используются.
Как создать SQL запрос? Где писать SQL код?
В одной из прошлых статей я рассказал Вам, что такое SQL и какие СУБД бывают, но у начинающих, кто только начинает работать с базами данных, могут возникнуть определённые вопросы, например, как работать с этими базами данных, как подключиться к базе и как выполнить SQL запрос?
Обычный случай, когда человек только что установил себе какую-нибудь СУБД (например, для изучения SQL) и не знает, что делать дальше, где писать SQL код? какую программу запустить?
Или другой, еще более распространённый вариант, когда уже есть установленный SQL сервер, а начинающему программисту (IT-ку), которому сказали, что он будет еще сопровождать SQL сервер, нужно подключиться к этому серверу и выполнить какой-нибудь SQL запрос или инструкцию, а он, так как никогда не работал с серверами баз данных, конечно же, не знает, как это сделать. И все это на самом деле логично, ведь наличие установленного сервера баз данных не говорит о том, что на сервере также есть средства управления этим сервером и средства разработки SQL инструкций, так как это отдельные программы, которые устанавливаются на клиентском компьютере (но можно установить и на самом сервере).
Поэтому сегодня, специально для начинающих SQL программистов, я расскажу о том, какие инструменты нужны для того, чтобы создавать и выполнять SQL запросы к базе данных, иными словами, где писать SQL запросы. При этом я расскажу про инструменты для всех популярных СУБД: Microsoft SQL Server, Oracle Database, MySQL и PostgreSQL. Так как для каждой СУБД используются отдельные инструменты, но есть, конечно же, и универсальные инструменты, которые умеют работать одновременно практически со всеми из вышеперечисленных баз данных.
Если у Вас возникает вопрос, как послать SQL запрос к базе данных из приложения при его разработке (например, Вы начинающий программист Java, C# или других языков), то это делается непосредственно из самой IDE (среды программирования), используя специальные драйверы для подключения к БД. Устанавливать перечисленные в данной статье инструменты необязательно, они нужны для прямой работы с базой данных: разработка и отладка SQL инструкций, выполнение административных задач и так далее.
Инструменты для создания SQL запросов
Сейчас я перечислю и коротко расскажу про инструменты, которые можно использовать для написания SQL запросов и их выполнения на различных SQL серверах, при этом функционал этих инструментов не ограничивается редактором SQL запросов, на самом деле большинство современных программ для работы с базами данных являются многофункциональными, их могут использовать как разработчики, так и администраторы баз данных.
В этом материале я перечислю только некоторые инструменты, так как на самом деле их очень много. Кстати, если Вы знаете или уже пользуетесь каким-нибудь инструментом, но его в перечисленном ниже списке не обнаружили, то пишите об этом в комментариях, я думаю, всем читателям будет интересно узнать, какие еще существуют средства создания SQL запросов.
Также обязательно отмечу, что, так как здесь перечислены качественные и многофункциональные инструменты, большинство из них, конечно же, платные, но у них есть бесплатные версии или пробный период. Если Вы будете заниматься SQL разработкой на более-менее нормальном уровне, то возможно стоит и отдать деньги за понравившееся Вам решение.
Однако с другой стороны, для начинающих в целях обучения или для небольших проектов покупать отдельный, пусть и очень функциональный и удобный инструмент, я думаю, не стоит, так как достаточно будет использовать стандартные средства, которые обычно разработчики конкретной СУБД предоставляют бесплатно. Основные стандартные средства я буду отмечать, чтобы Вы понимали, от чего Вам нужно отталкиваться, если Вы начинающий.
Microsoft SQL Server
Начну я, конечно же, с Microsoft SQL Server, так как я уже достаточно долго работаю с данной СУБД. Microsoft SQL Server – это система управления базами данных от компании Microsoft. Она очень популярна в корпоративном секторе, особенно в крупных компаниях.
Инструментов для работы с Microsoft SQL Server много, однако самый распространённый и популярный вариант – это, конечно же, SQL Server Management Studio.
SQL Server Management Studio
SQL Server Management Studio (SSMS) — это бесплатная графическая среда для управления инфраструктурой SQL Server, разработанная компанией Microsoft. С помощью Management Studio Вы можете разрабатывать и выполнять инструкции T-SQL, а также администрировать Microsoft SQL Server.
Среда SQL Server Management Studio – это основной, стандартный инструмент для работы с Microsoft SQL Server.
Если стандартного функционала SSMS Вам недостаточно, то для этой среды разработано очень много различных плагинов и надстроек, которые расширяют функционал Management Studio.
Более подробно про SQL Server Management Studio, включая то, как установить данную среду, я рассказывал в статье – Обзор и установка SQL Server Management Studio.
- Страница продукта –https://docs.microsoft.com/ru-RU/sql/ssms/download-sql-server-management-studio-ssms;
- SQL код – книга для изучения языкаSQL.
SQL Server Data Tools
SQL Server Data Tools – это еще один инструмент для работы с Microsoft SQL Server, разработанный компанией Microsoft. Данный инструмент входит в состав Visual Studio, и устанавливается он как отдельная рабочая нагрузка. Предназначен SQL Server Data Tools в первую очередь для разработчиков приложений.
Если Вы разрабатываете программы с помощью Visual Studio, при этом у Вас возникла необходимость работы с Microsoft SQL Server, то SQL Server Data Tools будет для Вас очень удобным и привычным инструментом.
dbForge Studio for SQL Server
dbForge Studio for SQL Server – это мощная среда для разработки и администрирования баз данных в Microsoft SQL Server. Разработчиком данной среды является компания Devart, у которой, кстати, есть много инструментов для работы с Microsoft SQL Server, про один инструмент я уже рассказывал в статье – Как сравнить и синхронизировать две базы данных в Microsoft SQL Server? Кроме того, у Devart есть и инструменты для работы с другими СУБД, про некоторые я сегодня еще расскажу.
Red Gate SQL Prompt
Red Gate SQL Prompt – еще один мощнейший инструмент для работы с Microsoft SQL Server. С помощью него также можно разрабатывать SQL инструкции и администрировать SQL сервер. Данную среду разрабатывает компания Redgate Software, которая специализируется на работе с данными, у нее есть инструменты и для работы с другими СУБД, но основным направлением является Microsoft SQL Server.
Navicat for SQL Server
Navicat for SQL Server – это графический инструмент для разработки и администрирования баз данных в Microsoft SQL Server. С помощью него можно создавать, редактировать и удалять любые объекты базы данных, разрабатывать и выполнять SQL запросы и инструкции, а также просматривать данные в таблицах, включая двоичные и шестнадцатеричные данные.
EMS SQL Management Studio for SQL Server
EMS SQL Management Studio for SQL Server – это комплексное решение для разработки и администрирования баз данных в Microsoft SQL Server. Разработкой занимается компания EMS, которая специализируется на разработке инструментов администрирования баз данных и приложений для управления данными. У нее много инструментов для работы с разными СУБД.
DataGrip
DataGrip – это универсальный инструмент для работы с базами данных, он умеет работать с Microsoft SQL Server, PostgreSQL, MySQL, Oracle, Sybase, DB2 и другими. Разработчиком DataGrip выступает JetBrains.
SQL Enlight
SQL Enlight – еще одно приложение для разработки T-SQL кода. Разработкой занимается компания Ubitsoft.
SQLCMD
SQLCMD – это стандартный консольный инструмент для работы с Microsoft SQL Server от компании Microsoft. Его использовать как основное средство разработки и администрирования SQL Server не получится, он в основном предназначен для каких-то служебных задач, выполнения скриптов и так далее. Его я сюда включил, так как начинающим программистам и администраторам SQL сервера об этом инструменте знать нужно.
Oracle Database
Oracle Database – это система управления базами данных от компании Oracle. Это также очень популярная СУБД, и также среди крупных компаний.
Инструментов для работы с Oracle Database также много, вот некоторые из них.
Oracle SQL Developer
Oracle SQL Developer – это стандартный, бесплатный и основной инструмент для разработчика баз данных Oracle.
Разработкой занимается компания Oracle. С помощью Oracle SQL Developer можно разрабатывать инструкции на PL/SQL и выполнять SQL запросы.
SQL Navigator for Oracle
SQL Navigator for Oracle – это удобный и не менее популярный инструмент для работы с Oracle Database.
Navicat for Oracle
Navicat for Oracle – это инструмент для разработки и администрирования баз данных Oracle Database. Этот инструмент имеет широкий набор функций для облегчения управления данными, таких как инструмент моделирования данных, синхронизация данных, импорт и экспорт данных.
EMS SQL Management Studio for Oracle
EMS SQL Management Studio for Oracle – это комплексное решение для разработки и администрирования баз данных Oracle Database. Разработкой занимается компания EMS, продукты которой я уже упоминал сегодня.
dbForge Studio for Oracle
dbForge Studio for Oracle – еще один продукт компании Devart, который предназначен для разработки и обслуживания баз данных Oracle Database, он также имеет очень мощный функционал.
MySQL
MySQL – это система управления базами данных также от компании Oracle, но только она распространяется бесплатно. MySQL получила широкое применение в интернете как средство хранения данных сайтов.
Для работы с MySQL существует очень много инструментов, вот самые популярные и функциональные.
MySQLWorkbench
MySQL Workbench – это основной и стандартный инструмент для работы с MySQL.
Он позволяет осуществлять разработку на SQL и администрировать MySQL сервер.
PHPMyAdmin
PHPMyAdmin – это бесплатный веб-инструмент для работы с MySQL. Очень широкую популярность он приобрел в интернете, так как именно PHPMyAdmin используют для разработки баз данных на многих web-сайтах, а также на большинстве хостинг-провайдерах для управления базой MySQL используется именно PHPMyAdmin.
- Страница продукта – https://www.phpmyadmin.net/
- Пример установки PHPMyAdmin на Linux Mint
Navicat for MySQL
Navicat for MySQL – это инструмент для администрирования и разработки баз данных MySQL и MariaDB. Navicat for MySQL позволяет подключаться и работать с базами данных в MySQL и MariaDB одновременно.
dbForge Studio for MySQL
dbForge Studio for MySQL – это мощное решение для разработки и управления базами данных MySQL и MariaDB. Данный инструмент позволяет создавать и выполнять SQL запросы, разрабатывать и отлаживать процедуры и функции, а также управлять объектами баз данных MySQL с помощью удобного графического пользовательского интерфейса.
EMS SQL Management Studio for MySQL
EMS SQL Management Studio for MySQL – это еще одно комплексное и мощное решение от компании EMS, на этот раз для разработки и администрирования баз данных MySQL. Данный инструмент содержит все необходимые компоненты для работы с MySQL: редактор SQL запросов, средство импорта, экспорта и сравнения данных и много других, предназначенных не только для разработчиков, но и для администраторов и аналитиков данных.
SQL Maestro for MySQL
SQL Maestro for MySQL – это еще один инструмент разработки и администрирования баз данных MySQL и MariaDB.
PostgreSQL
PostgreSQL – эта бесплатная система управления базами данных, и она очень популярна и функциональна.
Для работы с PostgreSQL можно использовать следующие инструменты.
pgAdmin
pgAdmin – это основное, стандартное средство для разработки баз данных PostgreSQL, которое распространяется бесплатно.
pgAdmin достаточно удобный инструмент для разработчика, с помощью него можно разрабатывать SQL инструкции, выполнять SQL запросы, создавать объекты базы данных и многое другое.
- Страница продукта – https://www.pgadmin.org/
- Пример установки pgAdmin 4 на Windows 7
EMS SQL Management Studio for PostgreSQL
EMS SQL Management Studio for PostgreSQL – это комплексное решение для разработки и администрирования баз данных PostgreSQL. Данный инструмент так же, как все остальные продукты компании EMS, имеет очень широкий функционал от простого редактора SQL запросов до инструмента сравнения данных.
Navicat for PostgreSQL
Navicat for PostgreSQL – это простой графический инструмент для разработки баз данных PostgreSQL. Он позволяет писать и выполнять SQL запросы любой сложности.
dbForge Studio for PostgreSQL
dbForge Studio for PostgreSQL – это еще один мощный инструмент от компании Devart, на этот раз для работы с PostgreSQL. Он позволяет разрабатывать и выполнять запросы, редактировать код в удобном интерфейсе, формировать отчеты, модифицировать данные, а также осуществлять импорт и экспорт данных.
psql
psql – это стандартная консольная утилита для работы с PostgreSQL. Используется в основном для автоматизации различных служебных задач, хотя вести SQL разработку в ней также можно.
DataGrip
Также осуществлять разработку баз данных PostgreSQL можно и с помощью уже упомянутого в этой статье универсального инструмента DataGrip от компании JetBrains.
Выводы
Как видите, существует очень много инструментов для работы с базами данных, при этом многие компании специализируется на выпуске программ для баз данных, и у них есть версии для каждой популярной СУБД. Такие инструменты очень функциональны, и они, конечно же, платные. Но, как я уже отмечал, функционала стандартных средств, которые предоставляются бесплатно, для создания и выполнения SQL запросов будет вполне достаточно.
Работа с запросами в MySQL
Базы данных являются ключевым компонентом многих веб-сайтов и приложений и лежат в основе хранения и обмена данными в Интернете. Одним из наиболее важных аспектов управления базой данных является практика извлечения данных из базы данных, будь то на разовой основе или частью процесса, который был закодирован в приложении. Существует несколько способов получения информации из базы данных, но один из наиболее часто используемых методов выполняется путем отправки запросов через командную строку.
В системах управления реляционными базами данных запрос — это любая команда, используемая для извлечения данных из таблицы. В языке структурированных запросов (SQL) запросы почти всегда выполняются с помощью оператора SELECT.
В этом руководстве мы обсудим основной синтаксис SQL-запросов, а также некоторые из наиболее часто используемых функций и операторов. Мы также будем практиковаться в создании запросов SQL с использованием некоторых примеров данных в базе данных MySQL.
MySQL — это система управления реляционными базами данных с открытым исходным кодом. MySQL, одна из наиболее распространенных баз данных SQL, отдает приоритет скорости, надежности и удобству использования. Как правило, она соответствует стандарту ANSI SQL, хотя в некоторых случаях MySQL выполняет операции не так, как признанный стандарт.
Подготовка окружения
В целом, команды и концепции, представленные в этом руководстве, могут использоваться в любой операционной системе на базе Linux, на которой работает любое программное обеспечение базы данных SQL. Тем не менее, он был написан специально для сервера Ubuntu 18.04. Для настройки вам понадобится следующее:
- Сервер с Ubuntu 18.04
- Установленный на сервере MySQL
Если сервер создается в NetAngels, то при создании сервера мы рекомендуем выбрать Ubuntu 18.04 Bionic LAMP
Создание образца базы данных
Прежде чем мы сможем начать делать запросы в SQL, мы сначала создадим базу данных и пару таблиц, а затем заполним эти таблицы некоторыми примерами данных. Это позволит вам получить практический опыт, когда вы начнете делать запросы позже.
Для примера базы данных, которую мы будем использовать в этом руководстве, представьте следующий сценарий:
Вы и несколько ваших друзей празднуете свои дни рождения друг с другом. В каждом случае члены группы направляются в местный боулинг, участвуют в дружеском турнире, а затем все направляются к вам, где вы готовите любимое блюдо для именинника.
Теперь, что эта традиция продолжается некоторое время, вы решили начать отслеживать записи с этих турниров. Кроме того, чтобы упростить планирование обедов, вы решаете создать запись о днях рождения ваших друзей и их любимых блюдах, сторонах и десертах. Вместо того чтобы хранить эту информацию в физической книге, вы решаете использовать свои навыки работы с базами данных, записав ее в базу данных MySQL.
Если вы создали сервер в NetAngels на основе образа Ubuntu 18.04 Bionic LAMP, то откройте приглашение MySQL выполнив от пользователя root команду:
Примечание: Если зайти в MySQL таким образом не удается, то для аутентификации с использованием пароля используйте команду:
Затем создайте базу данных, запустив:
Затем выберите эту базу данных, набрав:
Затем создайте две таблицы в этой базе данных. Мы будем использовать первую таблицу, чтобы отслеживать записи ваших друзей в боулинге. Следующая команда создаст таблицу под названием «tourneys» со столбцами для «name» каждого из ваших друзей, количества турниров, которые они выиграли («wins»), их лучший результат за все время и каков размер обувь для боулинга, которую они носят ( размер ):
Как только вы запустите команду CREATE TABLE и заполните ее заголовками столбцов, вы получите следующий вывод:
Заполните таблицу ‘tourneys’ некоторыми примерами данных:
Вы получите такой вывод:
После этого создайте еще одну таблицу в той же базе данных, которую мы будем использовать для хранения информации о любимых блюдах ваших друзей на день рождения. Следующая команда создает таблицу с именем dinners и столбцами для«имя» каждого из ваших друзей, их «дата рождения», их любимое «блюдо», их любимое «гарнир» и их любимый «десерт»:
Аналогично для этой таблицы вы получите отзыв, подтверждающий успешное выполнение команды:
Заполните эту таблицу также некоторыми примерами данных:
Как только эта команда завершится успешно, вы закончили настройку базы данных. Далее мы рассмотрим основную структуру команд запросов SELECT.
Понимание операторов SELECT
Как упоминалось во введении, SQL-запросы почти всегда начинаются с оператора SELECT . SELECT используется в запросах, чтобы указать, какие столбцы из таблицы должны быть возвращены в наборе результатов. Запросы также почти всегда включают FROM , который используется для указания таблицы, к которой будет обращаться оператор.
Как правило, SQL-запросы следуют этому синтаксису:
Например, следующий оператор вернет весь столбец name из таблицы dinners :
Вы можете выбрать несколько столбцов из одной таблицы, разделяя их имена запятыми, например:
Вместо того, чтобы называть конкретный столбец или набор столбцов, вы можете следовать за оператором SELECT со звездочкой ( * ), которая служит заполнителем, представляющим все столбцы в таблице. Следующая команда возвращает каждый столбец из таблицы tourneys :
WHERE используется в запросах для фильтрации записей, которые удовлетворяют указанному условию, и любые строки, которые не удовлетворяют этому условию, исключаются из результата. Предложение WHERE обычно соответствует следующему синтаксису:
Оператор сравнения в предложении WHERE определяет способ сравнения указанного столбца со значением. Вот некоторые распространенные операторы сравнения SQL:
| Оператор | Что он делает |
|---|---|
| = | тесты для равенства |
| != | тесты для неравенства |
| тесты для больше | |
| = | тесты для больше чем или равный к |
| BETWEEN | проверяет лежит ли в заданном диапазоне |
| IN | проверяет содержатся ли строки в наборе значений |
| EXISTS | тесты на соответствие строки существует при заданных условиях |
| LIKE | проверяет совпадает ли значение с указанной строкой |
| IS NULL | тесты для `NULL` значения |
| IS NOT NULL | тесты для всех других значений, чем `NULL` |
Например, если вы хотите найти размер обуви Ирмы, вы можете использовать следующий запрос:
SQL допускает использование подстановочных знаков, и это особенно удобно при использовании в предложениях WHERE. Знаки процента ( % ) представляют ноль или более неизвестных символов, а подчеркивания ( _ ) представляют один неизвестный символ. Они полезны, если вы пытаетесь найти конкретную запись в таблице, но не уверены, что эта запись. Чтобы проиллюстрировать это, скажем, что вы забыли любимое блюдо нескольких своих друзей, но вы уверены, что это конкретное блюдо начинается с буквы “t”. Вы можете найти его имя, выполнив следующий запрос:
Основываясь на вышеприведенном выводе, мы видим, что блюдо — это тофу.
Могут быть случаи, когда вы работаете с базами данных, в которых есть столбцы или таблицы с относительно длинными или трудно читаемыми именами. В этих случаях вы можете сделать эти имена более читабельными, создав псевдоним с ключевым словом AS . Псевдонимы, созданные с помощью AS , являются временными и существуют только на время запроса, для которого они созданы:
Здесь мы сказали SQL отображать столбец name как n , столбец birthdate как b , а столбец sert как d .
Примеры, которые мы рассмотрели до этого момента, включают в себя некоторые из наиболее часто используемых ключевых слов и предложений в запросах SQL. Они полезны для базовых запросов, но они бесполезны, если вы пытаетесь выполнить вычисление или получить скалярное значение (одно значение, а не набор из нескольких различных значений) на основе ваших данных. Это где агрегатные функции вступают в игру.
Агрегатные функции
Часто при работе с данными необязательно просматривать сами данные. Скорее, вам нужна информация о данных. Синтаксис SQL включает в себя ряд функций, которые позволяют интерпретировать или выполнять вычисления для ваших данных, просто выполнив запрос «SELECT». Они известны как aggregate functions.
Функция COUNT считает и возвращает количество строк, соответствующих определенным критериям. Например, если вы хотите узнать, сколько ваших друзей предпочитают тофу для своего дня рождения, вы можете выполнить этот запрос:
Функция AVG возвращает среднее (среднее) значение столбца. Используя наш пример таблицы, вы можете найти средний лучший результат среди ваших друзей с помощью этого запроса:
SUM используется для поиска общей суммы данного столбца. Например, если вы хотите посмотреть, сколько игр вы и ваши друзья играли в боулинг за эти годы, вы можете выполнить этот запрос:
Обратите внимание, что функции AVG и SUM будут работать правильно только при использовании с числовыми данными. Если вы попытаетесь использовать их для нечисловых данных, это приведет к ошибке или просто к «0», в зависимости от того, какую СУБД вы используете:
MIN используется для поиска наименьшего значения в указанном столбце. Вы можете использовать этот запрос, чтобы увидеть, какой худший общий рекорд в боулинге (с точки зрения количества побед):
Аналогично, MAX используется для поиска наибольшего числового значения в данном столбце. Следующий запрос покажет лучший общий результат в боулинге:
В отличие от SUM и AVG , функции MIN и MAX могут использоваться как для числовых, так и для буквенных типов данных. При запуске в столбце, содержащем строковые значения, функция MIN будет отображать первое значение в алфавитном порядке:
Аналогично, при запуске в столбце, содержащем строковые значения, функция MAX покажет последнее значение в алфавитном порядке:
Агрегатные функции умеют больше того, что было описано в этом разделе. Они особенно полезны при использовании с предложением GROUP BY , которое рассматривается в следующем разделе, а также с несколькими другими предложениями запроса, которые влияют на сортировку наборов результатов.
Управление запросами
В дополнение к предложениям FROM и WHERE , есть несколько других предложений, которые используются для манипулирования результатами запроса SELECT . В этом разделе мы объясним и предоставим примеры для некоторых из наиболее часто используемых предложений запросов.
Одним из наиболее часто используемых предложений запроса, помимо FROM и WHERE , является предложение GROUP BY . Обычно он используется, когда вы выполняете статистическую функцию для одного столбца, но в отношении сопоставления значений в другом.
Например, скажем, вы хотели знать, сколько ваших друзей предпочитают каждый из трех блюд, которые вы делаете. Вы можете найти эту информацию с помощью следующего запроса:
Предложение ORDER BY используется для сортировки результатов запроса. По умолчанию числовые значения сортируются в порядке возрастания, а текстовые значения сортируются в алфавитном порядке. Чтобы проиллюстрировать это, следующий запрос перечисляет столбцы name и birthdate , но сортирует результаты по дате рождения:
Обратите внимание, что поведение по умолчанию ORDER BY состоит в сортировке набора результатов в порядке возрастания. Чтобы изменить это и отсортировать набор результатов в порядке убывания, закройте запрос с помощью DESC :
Как уже упоминалось ранее, предложение WHERE используется для фильтрации результатов на основе определенных условий. Однако, если вы используете предложение WHERE с агрегатной функцией, оно вернет ошибку, как в случае со следующей попыткой выяснить, какие стороны являются фаворитами по крайней мере трех ваших друзей:
Предложение HAVING было добавлено в SQL для обеспечения функциональности, аналогичной функциональности предложения WHERE, а также совместимости с агрегатными функциями. Полезно думать о разнице между этими двумя пунктами как о том, что WHERE применяется к отдельным записям, в то время как HAVING применяется к групповым записям. С этой целью каждый раз, когда вы вводите предложение HAVING , также должно присутствовать предложение GROUP BY .
Следующий пример — еще одна попытка найти, какие гарниры являются фаворитами как минимум трех ваших друзей, хотя этот вернет результат без ошибок:
Агрегатные функции полезны для суммирования результатов определенного столбца в данной таблице. Однако во многих случаях необходимо запросить содержимое более чем одной таблицы. Мы рассмотрим несколько способов сделать это в следующем разделе.
Запрос нескольких таблиц
Чаще всего база данных содержит несколько таблиц, каждая из которых содержит разные наборы данных. SQL предоставляет несколько разных способов выполнения одного запроса для нескольких таблиц.
Предложение JOIN может использоваться для объединения строк из двух или более таблиц в результате запроса. Это достигается путем нахождения связанного столбца между таблицами и соответствующей сортировки результатов в выходных данных.
Операторы SELECT , которые включают предложение JOIN , обычно следуют этому синтаксису:
Обратите внимание, что поскольку предложения JOIN сравнивают содержимое нескольких таблиц, в предыдущем примере указывается, из какой таблицы выбрать каждый столбец, предшествуя имени столбца с именем таблицы и точкой. Вы можете указать, из какой таблицы должен быть выбран столбец, например, для любого запроса, хотя это не обязательно при выборе из одной таблицы, как мы делали в предыдущих разделах. Давайте рассмотрим пример, используя наш образец Dата.
Представьте, что вы хотите купить каждому из ваших друзей пару ботинок для боулинга в качестве подарка на день рождения. Поскольку информация о датах рождения и размерах обуви ваших друзей хранится в отдельных таблицах, вы можете запросить обе таблицы по отдельности, а затем сравнить результаты для каждой из них. Тем не менее, с помощью предложения JOIN вы можете найти всю необходимую информацию с помощью одного запроса:
Предложение JOIN , используемое в этом примере, без каких-либо других аргументов, является предложением inner JOIN . Это означает, что он выбирает все записи, которые имеют совпадающие значения в обеих таблицах, и печатает их в наборе результатов, в то время как все несоответствующие записи исключаются. Чтобы проиллюстрировать эту идею, давайте добавим новую строку в каждую таблицу, у которой нет соответствующей записи в другой:
Затем повторно запустите предыдущий оператор SELECT с предложением JOIN:
Обратите внимание, что, поскольку в таблице «tourneys» нет записи для Лесли, а в таблице «dinners» нет записи для Бетти, эти записи отсутствуют в этих выходных данных.
Тем не менее, можно вернуть все записи из одной из таблиц, используя предложение outer JOIN . В MySQL предложения JOIN записываются как LEFT JOIN или RIGHT JOIN .
Предложение LEFT JOIN возвращает все записи из« левой »таблицы и только совпадающие записи из правой таблицы. В контексте внешних объединений левая таблица — это таблица, на которую ссылается условие FROM , а правая таблица — любая другая таблица, на которую ссылается после оператора JOIN .
Выполните предыдущий запрос еще раз, но на этот раз используйте предложение LEFT JOIN :
Эта команда будет возвращать каждую запись из левой таблицы (в данном случае, «турниры»), даже если в правой таблице нет соответствующей записи. Каждый раз, когда в правой таблице нет подходящей записи, она возвращается как NULL или просто пустое значение, в зависимости от вашей RDBMS:
Теперь выполните запрос еще раз, на этот раз с предложением RIGHT JOIN :
Это вернет все записи из правой таблицы ( dinners ). Поскольку дата рождения Лесли записана в правой таблице, но для нее нет соответствующей строки в левой таблице, столбцы name и size вернутся как значения NULL в этой строке:
Обратите внимание, что левые и правые объединения могут быть записаны как LEFT OUTER JOIN или RIGHT OUTER JOIN , хотя подразумевается часть «OUTER» в предложении. Аналогично, указание INNER JOIN даст тот же результат, что и простое написание JOIN .
В качестве альтернативы использованию JOIN для запроса записей из нескольких таблиц, вы можете использовать предложение UNION .
Оператор UNION работает немного иначе, чем предложение JOIN : вместо того, чтобы печатать результаты из нескольких таблиц в виде уникальных столбцов с использованием одного оператора SELECT , UNION объединяет результаты двух операторов SELECT в один столбец.
Чтобы проиллюстрировать, запустите следующий запрос:
Этот запрос удалит все повторяющиеся записи, что является поведением по умолчанию оператора UNION :
Чтобы вернуть все записи (включая дубликаты), используйте оператор UNION ALL :
Имена и количество столбцов в таблице результатов отражают имя и количество столбцов, запрошенных первым оператором SELECT. Обратите внимание, что при использовании UNION для запроса нескольких столбцов из более чем одной таблицы каждый оператор SELECT должен запрашивать одинаковое количество столбцов, соответствующие столбцы должны иметь одинаковые типы данных, а столбцы в каждом операторе SELECT должны быть в том же порядке. В следующем примере показано, что может произойти, если вы используете предложение UNION для двух операторов SELECT , которые запрашивают разное количество столбцов:
Другой способ запроса нескольких таблиц — использование subqueries. Подзапросы (также известные как inner или nested query) — это запросы, заключенные в другой запрос. Это полезно в тех случаях, когда вы пытаетесь отфильтровать результаты запроса по сравнению с результатами отдельной агрегатной функции.
Чтобы проиллюстрировать эту идею, скажем, вы хотите знать, кто из ваших друзей выиграл больше матчей, чем Барбара. Вместо того, чтобы узнать, сколько матчей выиграла Барбара, а затем выполнить другой запрос, чтобы узнать, кто выиграл больше игр, вы можете рассчитать обе с помощью одного запроса:
Подзапрос в этом операторе был выполнен только один раз; нужно было только найти значение из столбца wins в той же строке, что и Barbara в столбце name , а данные, возвращаемые подзапросом и внешним запросом, не зависят друг от друга. Однако существуют случаи, когда внешний запрос должен сначала прочитать каждую строку в таблице и сравнить эти значения с данными, возвращенными подзапросом, чтобы получить требуемые данные. В этом случае подзапрос называется коррелированным подзапросом.
Следующее утверждение является примером коррелированного подзапроса. Этот запрос пытается выяснить, кто из ваших друзей выиграл больше игр, чем в среднем для тех, у кого одинаковый размер обуви:
Чтобы запрос завершился, он должен сначала собрать столбцы name и size из внешнего запроса. Затем он сравнивает каждую строку из этого набора результатов с результатами внутреннего запроса, который определяет среднее количество побед для людей с одинаковыми размерами обуви. Поскольку у вас есть только два друга с одинаковым размером обуви, в наборе результатов может быть только одна строка:
Как упоминалось ранее, подзапросы могут использоваться для запроса результатов из нескольких таблиц. Чтобы проиллюстрировать это одним последним примером, скажем, вы хотели устроить неожиданный ужин для лучшего боулера группы. Вы можете узнать, кто из ваших друзей имеет лучший рекорд в боулинге, и вернуть любимое блюдо по следующему запросу:
Обратите внимание, что этот оператор не только включает подзапрос, но также содержит подзапрос в этом подзапросе.
Заключение
Выдача запросов является одной из наиболее часто выполняемых задач в области управления базами данных. Существует ряд инструментов администрирования баз данных, таких как phpMyAdmin или pgAdmin, которые позволяют выполнять запросы и визуализировать результаты, но с помощью операторов SELECT это все еще широко распространенный рабочий процесс, который также может предоставить вам больший контроль.
SQL-запросы: базовые команды и примеры
Чтобы создать таблицу, используют команду CREATE TABLE, новую запись — INSERT.

Содержание
SQL — язык структурированных запросов. Его создали в 1974 году, чтобы хранить и обрабатывать данные. Все реляционные СУБД — системы управления базами данных — используют его в качестве препроцессора для обработки команд. Сами же базы данных представляют наборы таблиц, где запись — это строка.
SQL в работе используют разработчики и тестировщики, чтобы улучшать сайт или приложение через грамотную работу с базами данных. Тестировщики таким образом помогают бизнесу принимать эффективные решения на основе данных. Маркетологи — глубже анализировать поведение пользователей.
Виды SQL-запросов
Ключевые слова этого языка делят на четыре логические группы.
1️⃣ DDL
Data Definition Language — язык определения данных. В него входят ключевые слова CREATE, DROP, RENAME и другие, которые относят к определению и манипулированию структурой базы данных. Их используют, чтобы создавать базы данных и описывать структуру, устанавливать, как размещать данные.
2️⃣ DML
Data Manipulation Language — язык манипулирования данными. В этой группе — запросы SELECT, INSERT, UPDATE, DELETE и другие. Их используют, чтобы изменять, получать, обновлять и удалять данные из базы.
3️⃣ DCL
Data Control Language — язык управления данными. К этой группе относят запросы разрешений, прав и различных ограничивающих доступ настроек. Например, GRANT или DENY.
4️⃣ TCL
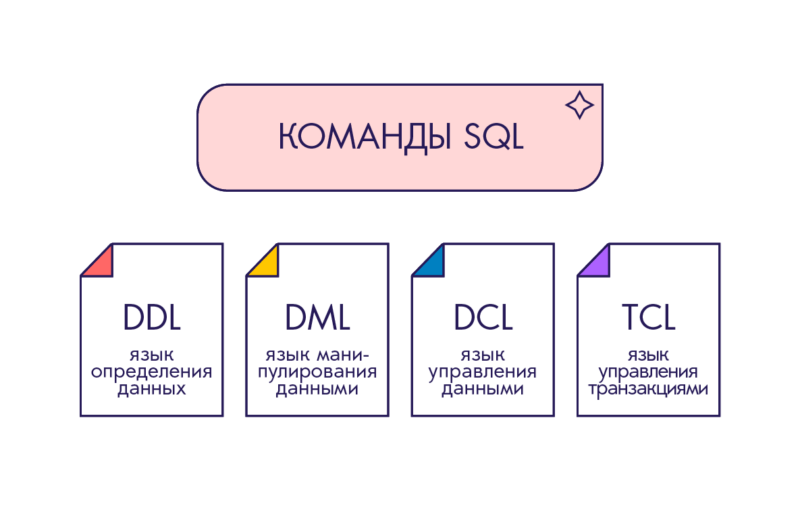
Transaction Control Language — язык управления транзакциями. В эту группу входят все запросы, которые относят к управлению транзакциями и их жизненными циклами. Например, BEGIN TRANSACTION, ROLLBACK TRANSACTION, COMMIT TRANSACTION.
Структура SQL-запросов
Запросы на языке SQL последовательны: логика их составления почти не отличается от обычного предложения. Например, вы хотите отфильтровать записи, чтобы получить только те, где в первом столбце значение равно единице. А после получить значения второго и третьего столбцов в выборке. Предложение на такую команду будет следующее:
На SQL это выглядит похоже:
Простые запросы SQL
Ключевые слова
Их используют, чтобы составить запросы:
Это ключевое слово отфильтровывает записи. Мы использовали его в абстрактном примере:
Группирует записи выборки по значениям указанных столбцов. Это ключевое слово должно следовать после WHERE.
✔️ AND, OR и BETWEEN
AND или OR расширяют выборку, создаваемую с помощью WHERE. Либо сужают ее, если указать дополнительные значения. Ключевое слово BETWEEN позволяет указать диапазон значений, чтобы создать выборку.
Лимитирует количество значений выборки. Например, по указанным фильтрам получено 100 значений, а нужны только первые 10. Тогда применяют синтаксис LIMIT 10.
Команды
С них начинаются запросы.
Предположим, нам необходимо создать базу данных, чтобы хранить информацию о прочитанных книгах, извлекать и изменять данные. В примерах мы будем использовать самую простую СУБД — sqlite3 в среде Linux. Создайте базу данных командой sqlite3 demo.db — и сразу попадете в командную строку программы:
�� CREATE TABLE
Чтобы создать таблицу, используют команду CREATE TABLE. Если создаете таблицу с прочитанными книгами, вероятно, понадобятся три столбца: id, название и автор.
Команда .tables отображает список таблиц.
�� INSERT
Команда создает новые записи. Добавим три книги в нашу таблицу:
Указываем, в какие столбцы нужно вставить данные, игнорируя столбец id: он помечен как первичный ключ. Будет автоматически инкрементироваться, генерируя уникальные значения. В примере вставляем несколько записей за один запрос.
�� SELECT
Извлекает записи из таблицы:
Каждая запись будет на новой строке, а значения столбцов — разделены вертикальной линией. Если, например, нужны не все, а определенные столбцы, то звездочку замените на названия столбцов через запятую:
�� UPDATE
Изменяет существующие записи. Чтобы использовать эту команду, укажите уникальный идентификатор изменяемой записи. Либо характеристику, по которой можно получить одну запись или группу из нескольких записей. Обновим авторов у первой и последней записи:
�� DELETE
Удаляет записи из таблицы по поисковому запросу. Удалим книгу с id, равным двум:
�� DROP TABLE
Удаляет таблицы из базы данных. Создадим и удалим демонстрационную таблицу:
�� ALTER TABLE
Команда в сочетании с другими ключевыми словами изменяет названия таблиц или добавляет новые столбцы. Изменим название нашей таблицы Books:
Добавим в нее новый столбец is_finished с булевым значением:
Агрегатные функции
Их используют, чтобы проводить дополнительные вычисления внутри полученной выборки:
✔️ COUNT(название_столбца) — возвращает количество строк выборки, где значение столбца не NULL.
✔️ SUM(название_столбца) — вычисляет и возвращает сумму значений в указанном столбце.
✔️ AVG(название_столбца) — вычисляет и возвращает среднее значение по столбцу.
✔️ MIN(название_столбца) — возвращает наименьшее значение для указанного столбца.
✔️ MAX(название_столбца) — возвращает наибольшее значение указанного столбца.
Вложенные подзапросы
Это SQL-запрос внутри другого SQL-запроса. Подзапросы помогают, если выборку фильтруют по значениям, которые тоже можно отфильтровать. Например, получим названия футбольных команд — участников соревнований с 2010 по 2020 годы:
Ключевое слово DISTINCT убирает из выборки дублирующиеся результаты.
Примеры SQL-запросов в MariaDB (MySQL)
В инструкции мы рассмотрим пример запросов MySQL/MariaDB, которые будут интересны новичкам или опытным пользователям в качестве шпаргалки.
Все запросы, за исключением выборки, несут потенциальную опасность для данных, которые хранятся в базе. Перед началом работы с рабочей базой, сделайте резервную копию.
Простые примеры использования SELECT
> SELECT <fields1> FROM <table> [JOIN <table2>] [ WHERE <conditions> ORDER BY <fields2> LIMIT <count> ]
* где fields1 — поля для выборки через запятую, также можно указать все поля знаком *; table — имя таблицы, из которой вытаскиваем данные; conditions — условия выборки; fields2 — поле или поля через запятую, по которым выполнить сортировку; count — количество строк для выгрузки.
* запрос в квадратных скобках не является обязательным для выборки данных.
1. Обычная выборка данных
> SELECT * FROM users
* в данном примере мы получаем список всех записей из таблицы users.
2. Выборка данных с объединением двух таблиц (JOIN)
SELECT u.name, r.* FROM users u JOIN users_rights r ON r.user_id=u.id
* в данном примере идет выборка данных с объединением таблиц users и users_rights. Объединяются они по полям user_id (в таблице users_rights) и id (users). Извлекается поле name из первой таблицы и все поля из второй.
3. Выборка с интервалом по времени и/или дате
Варианты запросов и примеров могут быть самые разные. Мы рассмотрим те, с которыми чаще всего приходилось иметь дело автору.
а) известна точка начала и определенный временной интервал:
> SELECT * FROM users WHERE date >= DATE_SUB(NOW(), INTERVAL 1 HOUR)
* будут выбраны данные за последний час (поле date).
б) известны дата начала и дата окончания:
> SELECT * FROM users WHERE date >= '2017-10-25' AND date <= '2017-11-25'
* выбираем данные в промежутке между 25.10.2017 и 25.11.2017.
в) известны даты начала и окончания + время:
> SELECT * FROM users WHERE DATE(date) BETWEEN '2018-03-25 00:15:00' AND '2018-04-25 15:33:09';
* выбираем данные в промежутке между 25.03.2018 0 часов 15 минут и 25.04.2018 15 часов 33 минуты и 9 секунд.
г) вытаскиваем данные за определенные месяц и год:
> SELECT * FROM study WHERE MONTH(date) = 4 AND YEAR(date) = 2018
* извлечем данные, где в поле date присутствуют значения для апреля 2018 года.
д) текущая дата минут год:
> SELECT * FROM study WHERE date < (CURDATE() — INTERVAL 1 YEAR)
* мы получим данные, которые имеют в колонке date дату, старше одного года.
4. Выборка максимального, минимального и среднего значения
> SELECT max(area), min(area), avg(area) FROM country
* max — максимальное значение; min — минимальное; avg — среднее.
5. Использование длины строки
> SELECT * FROM users WHERE CHAR_LENGTH(name) = 5;
* данный запрос должен показать всех пользователей, имя которых состоит из 5 символов.
6. Использование лимитов (LIMIT)
Применяется для ограничения количества выводимых результатов. Синтаксис:
<основной запрос> LIMIT [<число2>,] <число1>
* где число1 — сколько результатов вернуть; число2 — сколько результатов пропустить, необязательный параметр — если его не писать, то отсчет начнется с первой строки.
а) извлечь максимум 15 строк:
> SELECT * FROM users LIMIT 15;
б) выбрать строки с 16 по 25 (запрос со смещением):
> SELECT * FROM users LIMIT 15, 10;
* 15 строк пропускаем, 10 извлекаем.
Примеры более сложных запросов или используемых редко
1. Объединение с группировкой выбранных данных в одну строку (GROUP_CONCAT)
> SELECT GROUP_CONCAT(DISTINCT CONVERT(id USING 'utf8') SEPARATOR ', ') as ids FROM users
* из таблицы users извлекаются данные по полю id, все они помещаются в одну строку, значения разделяются запятыми.
2. Группировка данных по двум и более полям
> SELECT * FROM users GROUP BY CONCAT(title, '::', birth)
* итого, в данном примере мы сделаем выгрузку данных из таблицы users и сгруппируем их по полям title и birth. Перед группировкой мы делаем объединение полей в одну строку с разделителем ::.
3. Объединение результатов из двух и более таблиц (UNION)
а) простой вариант использования UNION:
> (SELECT id, fio, address, 'Пользователи' as type FROM users)
UNION
(SELECT id, fio, address, 'Покупатели' as type FROM customers)
* в данном примере идет выборка данных из таблиц users и customers.
б) если нам нужно использовать WHERE после UNION, запрос будет сложнее:
> SELECT * FROM (
(SELECT id, fio, address, 'Пользователи' as type FROM users)
UNION
(SELECT id, fio, address, 'Покупатели' as type FROM customers)
) as U
WHERE U.address LIKE "Садовая%"
4. Выборка средних значений, сгруппированных за каждый час
SELECT avg(temperature), DATE_FORMAT(datetimeupdate, '%Y-%m-%d %H') as hour_datetime FROM archive GROUP BY DATE_FORMAT(datetimeupdate, '%Y-%m-%d %H')
* здесь мы извлекаем среднее значение поля temperature из таблицы archive и группируем по полю datetimeupdate (с разделением времени за каждый час).
5. Использование операторов IF и CASE
Данные операторы позволяют определять исход запроса исходя из условия.
а) выбрать пол мужской или женский:
SELECT IF(sex = 'm', 'мужчина', 'женщина') as sex FROM people
* в данном примере мы возвращаем слово «мужчина», если поле sex равно 'm', иначе — «женщина».
б) заменяем идентификатор времени года более понятным человеку значением:
SELECT CASE season_id WHEN 1 THEN 'зима' WHEN 2 THEN 'весна' WHEN 3 THEN 'лето' WHEN 4 THEN 'осень' ELSE 'неправильный идентификатор времени года' END as season FROM ` seasons
* в данном примере мы используем оператор CASE. Если 1, то вернем слово «зима», если 2 — «весна» и так далее.
Вставка (INSERT)
> INSERT INTO <table> (<fields>) VALUES (<values>)
> INSERT INTO <table> VALUES (<values>)
* где table — имя таблицы, в которую заносим данные; fields — перечисление полей через запятую; values — перечисление значений через запятую.
* первый вариант позволит сделать вставку только по перечисленным полям — остальные получат значения по умолчанию. Второй вариант потребует вставки для всех полей.
1. Вставка нескольких строк одним запросом:
> INSERT INTO cities (`name`, `country`) VALUES ('Москва', 'Россия'), ('Париж', 'Франция'), ('Фунафути' ,'Тувалу');
* в данном примере мы одним SQL-запросом добавим 3 записи.
2. Вставка из другой таблицы (копирование строк, INSERT + SELECT):
Синтаксис при копировании строк из одной таблицы в другую выглядит так:
> INSERT INTO <table1> SELECT * FROM <table2> WHERE <условие для select>;
* где table1 — куда копируем; table2 — откуда копируем.
а) скопировать все без разбора:
> INSERT INTO cities-new SELECT * FROM cities;
* в данном примере мы скопируем все строки из таблицы cities в таблицу cities-new.
б) скопировать определенные столбцы строк с условием:
> INSERT INTO cities-new (`name`, `country`) SELECT `name`, `country` FROM cities WHERE name LIKE 'М%';
* извлекаем все записи из таблицы cities, названия которых начинаются на «М» и заносим в таблицу cities-new.
в) копирование с обновлением повторяющихся ключей.
Если копировать таблицы несколько раз, то может возникнуть проблема повторения первичного ключа. В базах данных значения таких ключей должны быть уникальными и при попытке вставить повтор мы получим ошибку «Duplicate entry 'xxx' for key 'PRIMARY'». Чтобы новые строки вставить, а повторяющиеся обновить (если есть изменения), используем «ON DUPLICATE KEY UPDATE»:
> INSERT INTO cities-new SELECT * FROM cities ON DUPLICATE KEY UPDATE `name`=VALUES(`name`), `country`=VALUES(`country`);
* в данном примере, как и в предыдущих, мы копируем данные из таблицы cities в таблицу cities-new. Но при совпадении значений первичного ключа мы будем обновлять поля name и country.
Обновление (UPDATE)
* где table — имя таблицы; field — поле, для которого будем менять значение; value — новое значение; conditions — условие (без него делать update опасно — можно заменить все данные во всей таблице).
Обновление с использованием замены (REPLACE):
UPDATE cities SET name = REPLACE(name, 'Масква', 'Москва');
UPDATE cities SET name = REPLACE(name, 'Масква', 'Москва') WHERE country = 'Россия';
UPDATE cities SET name = REPLACE(name, 'Ма', 'Мо') WHERE name = 'Масква';
Если мы хотим перестраховаться, результат замены можно сначала проверить с помощью SELECT:
SELECT REPLACE(name, 'Ма', 'Мо') FROM cities WHERE name = 'Масква';
Удаление (DELETE)
> DELETE FROM <table> WHERE <conditions>
* где table — имя таблицы; conditions — условие (как и в случае с UPDATE, использовать DELETE без условия опасно — СУБД не запросит подтверждения, а просто удалит все данные).
Более сложный вариант — удаление данных с объединением таблиц. Запрос будет такого вида:
> DELETE u FROM users u JOIN users_rights r ON r.user_id=u.id WHERE r.admin='1'
* в данном примере мы удалим записи только из таблицы users (u), которые при объединении с таблицей users_rights будут соответствовать условию r.admin='1'.
Создание таблицы
> CREATE TABLE <table> (<field1> <options1>, <field2> <options2>) <table options>
> CREATE TABLE IF NOT EXISTS `users_rights` (
`id` int(10) unsigned NOT NULL,
`user_id` int(10) unsigned NOT NULL,
`rights` int(10) unsigned NOT NULL
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
* где table — имя таблицы (в примере users_rights); field1, field2 — имя полей (в примере создается 3 поля — id, user_id, rights); options1, options2 — параметры поля (в примере int(10) unsigned NOT NULL); table options — общие параметры таблицы (в примере ENGINE=InnoDB DEFAULT CHARSET=utf8).
Использование запросов в PHP
Подключаемся к базе данных:
mysql_connect ('localhost', 'login', 'password') or die ("MySQL connect error");
mysql_select_db ('db_name');
mysql_query("SET NAMES 'utf8'");
* где подключение выполняется к базе на локальном сервере (localhost); учетные данные для подключения — login и password (соответственно, логин и пароль); в качестве базы используется db_name; используемая кодировка UTF-8.
Также можно создать постоянное подключение:
mysql_pconnect ('localhost', 'login', 'password') or die ("MySQL connect error");
* однако есть вероятность достигнуть максимально разрешенного лимита хостинга. Данным способом стоит пользоваться на собственных серверах, где мы сами можем контролировать ситуацию.
* в PHP выполняется автоматически, кроме постоянных подключений (mysql_pconnect).
Запрос к MySQL (Mariadb) в PHP делается функцией mysql_query(), а извлечение данных из запроса — mysql_fetch_array():
$result = mysql_query("SELECT * FROM users");
while ($mass = mysql_fetch_array($result)) <
echo $mass[name] . '<br>';
>
* в данном примере выполнен запрос к таблице users. Результат запроса помещен в переменную $result. Далее используется цикл while, каждая итерация которого извлекает массив данных и помещает его в переменную $mass — в каждой итерации мы работаем с одной строкой базы данных.
Используемая функция mysql_fetch_array() возвращает ассоциативный массив, с которым удобно работать, но есть еще альтернатива — mysql_fetch_row(), которая возвращает обычный нумерованный массив.
Экранирование
При необходимости включения в строку запроса спецсимвола, например, %, необходимо использовать экранирование с помощью символа обратного слэша — \
> SELECT * FROM producrions WHERE kpd = '100\%'
* если выполнить такой запрос без экранирования, знак %, будет восприниматься как любое количество символов после 100.
Использование переменных
Пременные задаются с помощью знака собаки, например:
> SET @number = 101;
* мы создали переменную number со значением 101.
Теперь можно применить переменную в запросе, например:
> INSERT INTO users (`user_number`, `user_name`) VALUES (@number, CONCAT('Пользователь ', @number));