Анализ данных с использованием Python
Язык программирования Python в последнее время все чаще используется для анализа данных, как в науке, так и коммерческой сфере. Этому способствует простота языка, а также большое разнообразие открытых библиотек.
В этой статье разберем простой пример исследования и классификации данных с использованием некоторых библиотек на Python. Для исследования, нам понадобится выбрать интересующий нас набор данных (DataSet). Разнообразные наборы Dataset’ы можно скачать с сайта. DataSet обычно представляет собой файл с таблицей в формате JSON или CSV. Для демонстрации возможностей исследуем простой набор данных с информацией о наблюдениях НЛО. Наша цель будет не получить исчерпывающие ответы на главный вопрос жизни, вселенной и всего такого, а показать простоту обработки достаточно большого объема данных средствами Python. Собственно, на месте НЛО могла быть любая таблица.
И так, таблица с наблюдениями имеет следующие столбцы:
- datetime — дата появления объекта
- city — город в котором появился объект
- state — штат
- country — страна
- duration (seconds) — время на которое появился объект в секундах
- duration (hours/min) — время на которое появился объект в часах/минутах
- shape — форма объекта
- comments — коментарий
- date posted — дата публикации
- latitude — широта
- longitude — долгота
Для тех, кто хочет пробовать нуля, подготовим рабочее место. У меня на домашнем ПК стоит Ubuntu, поэтому покажу для нее. Для начала нужно установить сам интерпретатор Python3 с библиотеками. В убунту подобном дистрибутиве это будет:
pip — это система управления пакетами, которая используется для установки и управления программными пакетами, написанными на Python. С её помощью устанавливаем библиотеки, которые будем использовать:
sklearn — библиотека, алгоритмов машинного обучения, она понадобится нам в дальнейшем для классификации исследуемых данных,
matplotlib — библиотека для построения графиков,
pandas — библиотека для обработки и анализа данных. Будем использовать для первичной обработки данных,
numpy — математическая библиотека с поддержкой многомерных массивов,
yandex-translate — библиотека для перевода текста, через yandex API (для использования нужно получить API ключ в яндексе),
pycountry — библиотека, которую будем использовать для преобразования кода страны в полное название страны,
Используя pip пакеты ставятся просто:
Файл DataSet — scrubbed.csv должен лежать в рабочей директории, где создается файл программы.
Итак приступим. Подключаем модули, которые используются нашей программой. Модуль подключается с помощью инструкции:
Если название модуля слишком длинное, и/или не нравится по соображениям удобства или политическим убеждениямм, то с помощью ключевого слова as для него можно создать псевдоним:
Тогда, чтобы обратиться к определенному атрибуту, который определен в модуле
Для подключения определенных атрибутов модуля используется инструкция from. Для удобства, чтобы не писать названия модуля, при обращении к атрибуту, можно подключить нужный атрибут отдельно.
Подключение нужных нам модулей:
Для того, что бы улучшить наглядность графиков, напишем вспомогательную функцию для генерации цветовой схемы. На входе функция принимает количество цветов, которое необходимо сгенерировать. Функция возвращает связный список с цветами.
Для перевода некоторых названий с англиского на русский язык создадим функцию translate. И да, нам понадобится интернет, чтобы воспользоваться API переводчика от Яндекс.
Функция принимает на вход аргументы:
- string — строка, которую нужно перевести,
- translator_obj — объект в котором реализован переводчик, если равен None, то строка не переводится.
и возвращает переведенную на русский язык строку.
Инициализация объекта переводчика должна быть в начале кода.
YANDEX_API_KEY — это ключ доступа к API Yandex, его следует получить в Яндексе. Если он пустой, то объект translate_obj инициализируется значением None и перевод будет игнорироваться.
Напишем еще одну вспомогательную функцию для сортировки объектов dict.
dict — представляет собой встроенный тип Python, где данные хранятся в виде пары ключ-значения. Функция сортирует словарь по значениям в убывающем порядке и возвращает отсортированные список ключей и соответсвуюущий ему по порядку следования элементов список значений. Эта функция будет полезна при построении гистограмм.
Мы добрались до непосредственно данных. Для чтения файла с таблицей используем метод read_csv модуля pd. На вход функции подаем имя csv файла, и чтобы подавить предупреждения при чтении файла, задаем параметры escapechar и low_memory.
- escapechar — символы, которые следует игнорировать
- low_memory — настройка обработки файла. Задаем False для считывание файла целиком, а не частями.
В некоторых полях таблицы есть поля со значением None. Этот встроенный тип, обозначающий неопределенность, поэтому некоторые алгоритмы анализа могут работать некорректно с этим значением, поэтому произведем замену None на строку ‘unknown’ в полях таблицы. Эта процедура называется импутацией.
Поменяем коды стран на названия на русском языке с помощью библиотеки pycountry и yandex-translate.
Переведем все названия видов объектов на небе на русский язык.
Первичную обработку данных на этом завершаем.
Постороим график наблюдений по странам. Для построения графиков используется библиотека pyplot. Примеры построения простого графика можно найти на официальном сайте https://matplotlib.org/users/pyplot_tutorial.html. Для построения гистограммы можно использовать метод bar.
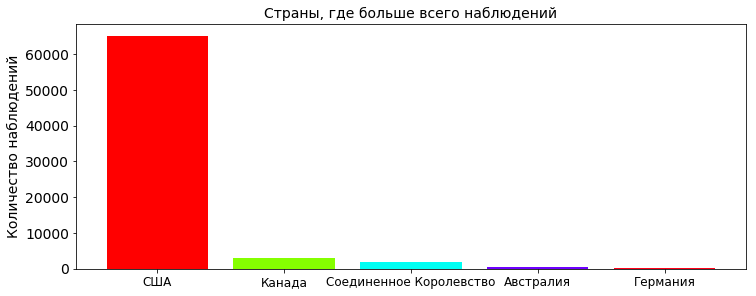
Больше всего наблюдений естественно в США. Тут ведь оно как, все гики, которые следят за НЛО живут в США (о версии, что таблица составлялась гражданами США, лукаво умолчим). Судя по количеству американских фильмов скорее всего второе. От Кэпа: если инопланетяне действительно посещали землю в открытую, то вряд ли бы их заинтересовала одна страна, сообщение об НЛО появлялись бы из разных стран.
Интересно еще посмотреть в какое время года наблюдали больше всего объектов. Есть резонное предположение, что больше всего наблюдений в весеннее время.

Ожидалось весеннее обострение, но предположение не подтвердилось. Кажется теплые летние ночи и период отпусков дают о себе знать сильнее.
Посмотрим какие формы объектов на небе видели и сколько раз.
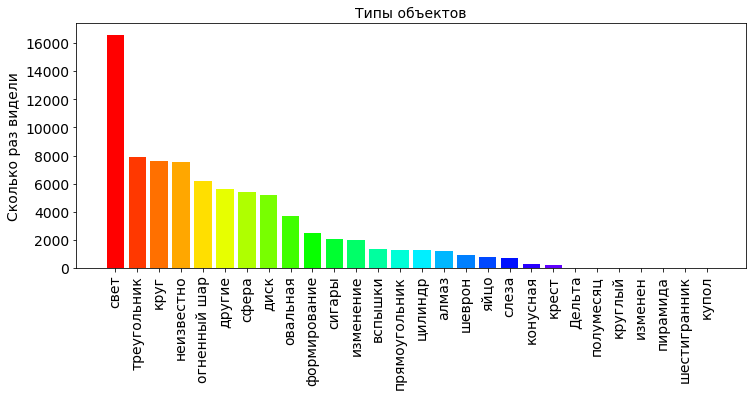
Из графика мы видим, что больше всего на небе видели просто свет, который в принципе необязательно является НЛО. Этому явлению существует внятное объяснение, например, ночное небо отражает свет от прожекторов, как в фильмах про Бэтмена. Также это вполне может быть северным сиянием, которое появляется не только в полярной зоне, но и в средних широтах, а изредка даже и в близи эвкватора. Вообще атмосфера земли пронизана множеством излучений различной природы, электрическими и магнитными полями.
Вообще, атмосфера Земли пронизана множеством излучений различной природы, электрическими и магнитными полями.
Интересно еще посмотреть среднее время, на которое в небе появлялся каждый из объектов.
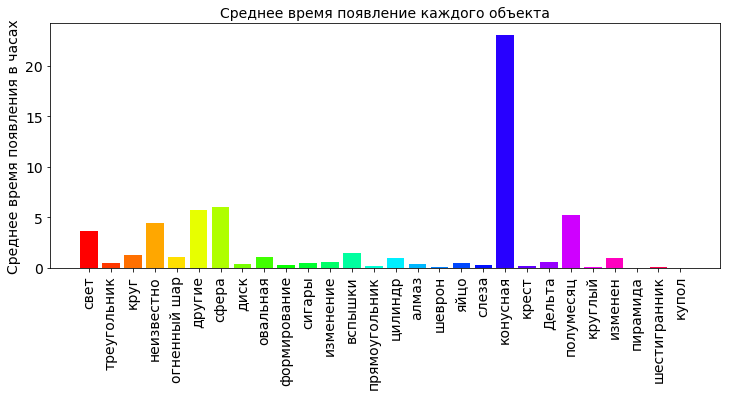
Из диаграммы видими, что больше всего в небе в среднем висел конус (более 20 часов). Если покопаться в интернетах, то ясно, что конусы в небе, это тоже свечение, только в виде конуса (неожиданно, да?). Вероятнее всего это свет от падающих комет. Среднее время больше 20 часов — это какая-то нереальная величина. В исследуемых данных большой разброс, и вполне могла вкраться ошибка. Несколько очень больших, неверных значений времени появления могут существенно исказить расчет среднего значения. Поэтому при больших отклонениях, считают не среднее значение, а медиану.
Медиана — это некоторое число, характеризующее выборку, одна половина в выборке меньше этого числа, другая больше. Для расчета медианы используем функцию median.
Заменим в коде выше:
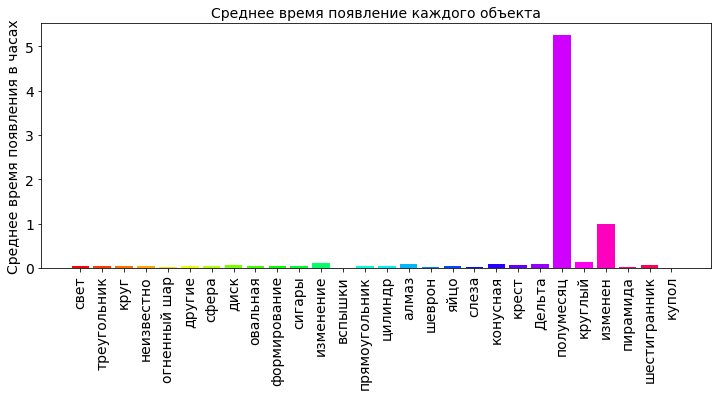
Полумесяц видели в небе чуть больше 5-ти часов. Другие объекты не надолго промелькнули в небе. Это уже наиболее достоверно.
Для первого знакомства с методологией обработки данных на Python, думаю, достаточно. В следующих публикациях займемся статистическим анализом, и постараемся выбрать другой не менее актуальный пример.
Data Collection

To analyze data using Python, your data needs to be organized into matrix of samples and features:
Whenever you collect data, any given feature will fall into one of two types:
Continuous Features
In the case of continuous features, there exist a measurable difference between possible feature values. Feature values usually are also a subset of all real numbers:
- Quantity
- Time
- Price
- Temperature
Categorical Features
With categorical features, there is a specified number of discrete, possible feature values. These values may or may not have ordering to them. If they do have a natural ordering, they are called ordinal categorical features. Otherwise if there is no intrinsic ordering, they are called nominal categorical features.
- Gender
- Colors
- Movies
- Small-Medium-Large
- 1–10 Years Old, 11–20 Years Old, 30–40 Years Old
- Happy, Neutral, Sad
Data Loading
Once you’ve collected your data, the next step is learning how to manipulate it efficiently.
Pandas is one of the most vital and actively developed high-performance data analysis libraries for Python, and you’ll be using it for all your data input, output, and manipulation needs. Pandas is built on top of another library NumPy. There are two data structures in Pandas you need to know how to work with. The first is the series object, a one-dimensional labeled array that represents a single column in your dataset.
Having all elements share the same units and data type make give you the ability to apply series-wide operations. Because of this, Pandas series must be homogeneous. They’re capable of storing any Python data type (integers, strings, floating point numbers, objects, etc.), but all the elements in a series must be of the same data type. The second structure you need to work with is a collection of series called a dataframe.
To manipulate a dataset, you first need to load it into a dataframe. Different people prefer alternative methods of storing their data, so Pandas tries to make loading data easy no matter how it’s stored. Here are some methods for loading data:
Note the return type of .read_html(), it is a Python list of dataframes, one per HTML table found on the webpage.
Also make sure you understand fully what the following parameters do:
- sep
- delimiter
- header
- names
- index_col
- skipinitialspace
- skiprows
- na_values
- thousands
- decimal
Many students new to data science run into problems because they rush through the mundane, data analysis portion of their work in their eagerness to get to the more exciting machine learning portion. But if they make mistakes here, for example by not knowing how to use index_col to strip out id’s while reading their datasets with the .read_csv() method, once they apply machine learning to their data, all of their findings are wrong.
Data Summary
To see a descriptive statistical summary of your dataframe’s numeric columns using .describe():
To get a quick peek at your data by selecting its top or bottom few rows using .head() and .tail(). By default, it will show 5 records. Also, to get a quick peak at number of rows and columns for a dataframe, use .shape() method.
When you load up a dataframe, it’s always a good idea to see what data type Pandas assigned each column and how many entries are there. This is can be done using info() method. This is also very useful to check if there is any null value in any column.
Slicin’ and Dicin’
A dataframe is essentially one or more series which have been ‘stitched’ together into a new data type. Pandas exposes many equivalent methods for slicing out those underlying series. You can slice by location, the way you would normally index into a regular Python list. You can slice by label, the way you would normally index into a Python dictionary. And like NumPy arrays, you can also index by boolean masks. Below are the different slicing methods to see the content of first column.
By using the column name in the code, it’s very easy to discern what is being pulled, and you don’t have to worry about the order of the columns. Doing this lookup of first matching the column name before slicing the column index is marginally slower than directly accessing the column by index. The .loc[] method selects by column label, .iloc[] selects by column index. Method .ix[] can be used as well whenever you want to use a hybrid approach of either, however, it is being deprecated.
Please be aware that if you use double brackets in syntax, even if you only specify a single column, the data type that you’ll get back is a dataframe as opposed to a series. So, the advantage of this list is that you can access more than one column.
You can use any of the .loc[], .iloc[] methods to do selection by row, noting that the expected order is [row_indexer, column_indexer]:
The last important difference is that .loc[] and .ix[] are inclusive of the range of values selected, where .iloc[] is non-inclusive. In that sense, df.loc[0:1, :] would select the first two rows, but only the first row would be returned using df.iloc[0:1, :].
Your dataframes and series can also be indexed with a boolean operation — a dataframe or series with the same dimensions as the one you are selecting from, but with every value either being set to True or False. You can create a new boolean series either by manually specifying the values, or by using a conditional. To index with your boolean series, simply feed it back into your regular series with using the [] bracket-selection syntax. You can further combine multiple boolean indexing conditionals together using the bit-wise logical operators | and &.
This is a bit counter-intuitive, as most people initially assume Pandas would support the regular, Python boolean operators or and and. The reason regular Python boolean operators cannot be used to combine Pandas boolean conditionals is because doing so causes ambiguity. There are two ways the following incorrect statement can be interpreted:
- If the evaluation the statement (df1.TotalAssets < 10000) or the evaluation the statement (df1.TotalAssets > 9000) results in anything besides the False, then select all records in the dataset.
- Select all columns belonging to rows in the dataset where either of the following statements are true: (df1.TotalAssets < 10000) or (df1.TotalAssets > 9000).
Option 2 is the desired functionality, but to avoid this ambiguity entirely, Pandas overloads bit-wise operators on its dataframe and series objects. Be sure to encapsulate each conditional in parenthesis to make this work.
Writing to a Slice
Something handy that you can do with a dataframe or series is write into a slice:
Take precaution while doing this, as you may encounter issues with non-homogeneous dataframes. It is far safer, and generally makes more sense, to do this sort of operation on a per column basis rather than across your entire dataframe.
In the next post, I would like to talk about Features representation, Features extraction, Features selection and Features importance.
Особенности анализа данных с Python

Популярность языка программирования Python растет с каждым годом. Его используют как в науке, так и в коммерческих целях. А в последнее время он все чаще применяется в анализе данных. Это происходит из-за его простоты, большого выбора открытых библиотек. В статье находится ответ, почему аналитики для анализа выбирают Python, а также обзор курсов, на которых можно изучить особенности такого анализа.
Зачем нужен Python
Анализ данных применяется практически во всех областях экономики: от финансового и IT-сектора до предприятий тяжелой, нефтяной и газовой промышленности. Даже в сельском хозяйстве не обойтись без грамотного анализа данных.
Во всем мире постоянно растет объем информации. Все объекты хозяйствования, в том числе магазины, маркетплейсы, платежные системы, банки накапливают огромные массивы данных. Чтобы извлечь из них пользу, выявить тенденции, закономерности, составить прогнозы и выстроить бизнес- и финансовые модели, все эти данные необходимо собрать, систематизировать, проанализировать и интерпретировать. Все это является основной задачей анализа данных. Именно Python является не только универсальным, но и простым инструментом, который помогает решать практически любые аналитические задачи.
Как утверждает GitHub, среди современных языков программирования Python находится в тройке лидеров. Владение этим языком требуется на должности:
- аналитика – в 84% вакансиях. По данным российского подразделения группы компаний HeadHunter, ежемесячно предлагается более 1000 вакансий на должность аналитика, владеющего Python;
- связанные с Data Science – в 100% вакансий.
Популярность Python легко объяснима. Аналитики предпочитают использовать в работе этот язык, потому что он помогает:
- автоматизировать сбор данных;
- наладить обработку данных;
- увеличивать скорость анализа;
- воплощать в анализ абсолютно новые подходы.
Так, благодаря использованию Python стало возможным решение определенных задач, с применением обучения нейросетей.
Почему аналитики выбирают Python
Аналитикам или Data Science-специалистам для работы нужен функциональный и одновременно простой язык. Потому многие из них предпочитают работать именно с Python. Ведь наряду с простотой и высокой функциональностью, Python имеет много других преимуществ:
- изучение Python не вызывает трудностей и займет гораздо меньше времени, чем обучение языкам Java, C и т.д.;
- простой синтаксис позволяет быстро писать сам код. Это гораздо проще делать в Python, чем на Java либо C. Да код, написанный на Python, легко читается и интерпретируется;
- в Питон встроен интерпретатор, который позволяет писать код практически на ходу. Это значительно облегчает задачу аналитиков, проверяющих многочисленные гипотезы, т.к. позволяет это делать в интерактивном режиме. С другими языками подобного добиться очень сложно;
- специалистам, работающим с Big Data, также пригодится встроенный интерпретатор. Он позволяет преобразовывать исходный код в машинную инструкцию и генерировать идеи по оптимизации;
- высокая скорость развития языка. Практически каждый разработчик может предложить собственные идеи и чуть позже они могут оказаться добавленными в вышедших обновлениях. Это способствует постоянному усовершенствованию языка, т.к. с выходом каждой новой версии, его производительность растет, а синтаксис становится еще совершеннее.
Аналитики предпочитают осваивать этот ключевой современный инструмент и осуществлять анализ данных, используя его, потому что он позволяет:
- автоматизировать выполнение рутинной работы;
- работать с огромными объемами информации, не прибегая к администрированию и базам данных.
Финансовая сторона вопроса
Говоря о преимуществах работы аналитика данных, работающего с Python, не стоит забывать и о финансовой стороне. Как сказано выше, аналитики, владеющие им, достаточно востребованы в крупном и среднем бизнесе. Особый спрос на них – в отраслях и проектах, имеющих непосредственное отношение к IT и Digital. Такие специалисты востребованы в банках, консалтинговых и диджитал-агентствах, компаниях, налаживающих систему онлайн-продаж и т.д.
Средняя зарплата аналитиков в разных городах России составляет:
- от 60 тыс. рублей – для стажеров и Junior-специалистов;
- от 130 тыс. рублей – для специалистов с опытом.
Для кого-то такие финансовые возможности становятся решающим фактором перехода на работу с Python.
Где пройти обучение
Стать аналитиком данных с использованием языка программирования Python сможет каждый желающий, т.к. многие онлайн-школы проводят соответствующие курсы. Предлагаем список компаний, предлагающих подобные образовательные курсы. Выбирайте те проекты, которые вам больше нравятся.
SkillFactory
Онлайн-школа SkillFactory (Mail.ru Group) предлагает образовательный проект «Python для анализа данных». Как утверждают создатели курса, его выпускники научатся:
- обрабатывать огромные массивы данных, создавать необходимую отчетность за считанные минуты;
- автоматизировать сбор данных из всемирной паутины;
- работать с API;
- осуществлять парсинг.
Курс идеально подходит:
- аналитикам;
- менеджерам;
- маркетологам.
Обучение проходит в формате онлайн в течение 2 месяцев. Курс сострит из 20 модулей, разделенных на два уровня: вводный и продвинутый. Слушателям становятся доступны:
- теоретические материалы;
- более 500 упражнений и задач по 20 темам от основ базового синтаксиса до особенностей отладки кода, от изучения Pandas и NumPy до тонкостей работы с API аналитических систем;
- различные кейсы,
- вебинары, на которых можно задавать вопросы, а для лучшего усвоения материала – просмотреть их в записи;
- система поддержки в Slack, которая по сути является живым сообществом студентов и команды поддержки SkillFactory. Здесь можно делиться бизнес-задачами и кодами, оказывать и получать помощь в нахождении ошибок, задавать вопросы.
Все выпускники школы получают:
- сертификаты об окончании школы на русском или английском языке;
- помощь в трудоустройстве (предлагаются подборки вакансий);
- проекты в портфолио;
- полезные связи, знакомства со специалистами из разных сфер, общение в специальном сообществе экспертов.
Нетология
Компания Нетология, специализирующаяся на онлайн-образовании, предлагает пройти курс обучения «Python для анализа данных». Продолжительность курса – 4 месяца. Оно проходит в формате видеолекций, вебинаров, выполнения практических заданий и экспертной поддержки специалистов компании.
Образовательная программа от Нетологии основана на лучших кейсах, с применением передовой практики и включает:
- 30 теоретических занятий в формате видеолекций;
- вебинары, предполагающие живое общение с практикующими специалистами, экспертами в различных отраслях и работающими в крупных компаниях;
- изучение 10 библиотек Python для использования в работе;
- более 20 практических занятий, основная цель которых – отработка навыков и полученных знаний. Практика осуществляется на реальных кейсах с применением тех рабочих инструментов, с которыми работают аналитики. Включает 2 лабораторные работы и обратную связь от экспертов. На лабораторных работах и при подготовке диплома – решение больших, комплексных задач;
- экспертную поддержку специалистов;
- получение диплома установленного образца;
Кроме целенаправленного прохождения курса, его можно пройти в рамках обучения профессиям:
- аналитика данных;
- маркетолога-аналитика;
- Data Scientist;
- Data инженер с нуля до PRO.
Прохождение курса поможет:
- стать более автономным и в работе с данными перестать зависеть от разработчиков, научиться понимать специалистов, пишущих программы;
- научиться автоматизировать рутинные процессы и задачи, ощутить прелесть оптимизации процессов, использовать освободившееся время для решения новых задач;
- получить доступ к огромному пласту данных, научившись парсить сайты. Это поможет замечать и получать информацию там, где раньше ее просто не замечали;
- с легкостью перейти в Data Science и начать строить там карьеру;
- научиться подготавливать данные для алгоритмов и использовать готовые решения, придавая смысл сырой информации;
- находить в данных новые инсайты, взаимосвязи, тенденции, а затем их интерпретировать, чтобы улучшить показатели бизнеса.
Прохождение программы будет полезным:
- аналитикам;
- продакт-менеджерам;
- разработчикам.
Организаторы курса утверждают, что он будет жестким и непростым. Однако обещают, что в ходе его прохождения слушатели:
- овладеют супервозможностями Python, получат инструменты, а также отработают их при выполнении поставленных задач. Благодаря персональной поддержки, каждый слушатель получит максимам от прохождения столь интенсивного процесса обучения;
- прокачают важные навыки.
Тем, кто еще сомневается, организаторы дают гарантию возврата денег в течение трех первых занятий.
CodeForMySelf
Кроме вышеперечисленных курсов, можно найти ряд других предложений, заслуживающих внимания. Так, на CodeForMySelf, предлагается образовательную программу «Обработка и анализ данных на Python. Библиотека Pandas».
Она разбита на четыре основные части и бонус:
- Окружение и основы Jupyter Notebook – 6 уроков.
- Структура данных Series – 6 уроков.
- Структура данных DataFrame – 27 уроков.
- Практика работы с Pandas – 15 уроков.
- Бонус – Изучение Python. Новичкам и начинающим разбираться с этим языком, изучение курса рекомендуется начинать именно с бонусной части.
В основную часть входит 54 урока, представленных в более 17 часов видео. В бонусе собрано 48 уроков.
Прохождение курса не привязано к временным рамкам. Каждый, кто приобретет его, сможет изучать материал, когда ему будет удобно.
ProductStar
Компания ProductStar предлагает годовой онлайн-курс «Профессия: Аналитик (с 0 до PRO)» с постоянным доступом к материалам. Слушатели освоят профессию аналитик продуктов с нуля. На курсе разбирается специфика профессии, инструменты от Google Analytics, Python и BI-инструментов до Machine Learning и DataScience.
Слушателей курсов ожидают:
- 60 уроков, разбитых на 12 блоков, представленных в видеолекциях, которые можно прослушать в удобное время;
- выполнение практических занятий после каждого урока, которые построены на кейсах ведущих компаний;
- менторская поддержка, позволяющая проходить обучение на удобной скорости;
- помощь в трудоустройстве, подготовка к собеседованиям (в течение 6 месяцев обучения);
- полезные связи и общение с одногруппниками, проходящими также этот курс;
- цифровой сертификат о прохождении курса.
Каждый выпускник школы получает:
- навыки, необходимые для работы на должности аналитик;
- проекты для наполнения портфолио, к примеру – выполненный для защиты диплома;
- интересую работу с достойной оплатой в привлекательной для него компании.
При прохождении курса «Профессия: Аналитик (с 0 до PRO)», слушатели научатся:
- Анализировать сайты и трафик, используя данные. На их основе рекомендовать действия, которые помогут изменить стратегию и рекламные кампании.
- Пользоваться Google Analytics и Яндекс.Метрика на уровне продвинутого пользователя. В их компетенции будет настройка в Google Analytics и Яндекс.Метрика счетчиков и целей. Создавать собственные отчеты и разбираться в стандартных в Google Analytics и Яндекс.Метрика.
- Создавать проекты систем сквозной аналитики, которые позволят отслеживать полный цикл клиента с момента его перехода на веб-ресурс и до совершения покупки, а также выяснять эффективность инвестиций в проекты.
- Визуализации данных, что позволит более наглядно демонстрировать динамику их изменений.
Работа аналитика данных с использованием Python достаточно перспективная. Обучиться основам этой специальности, овладеть инструментами и отработать профессиональные навыки можно на специализированных курсах. Будем рады, если статья поможет сделать правильный выбор. Если возникли вопросы – задавайте. В комментариях указывайте, какие курсы проходили вы, их эффективность и надежность.
Python в аналитике — Введение в дата-аналитику
Python — это язык программирования №1 в мире анализа данных. Именно на нем, помимо SQL, работает типичный аналитик данных.
Помимо этого, Python очень популярен и во всем мире в целом. Согласно опросу Stack Overflow от 2022 года Python входит в пятерку самых популярных языков программирования.
Согласно PYPL Index, он вообще стоит на первом месте:
Сегодня мы разберем основы Python и освоим базовые навыки работы с ним, чтобы вы могли решать свои первые задачи на Python.
Как писать код на Python
В зависимости от того, готовы ли отдать немного места на своем компьютере программе для работы с Python, существует 2 основных варианта для приобретения навыков программирования на Python:
Существует несколько способов работы с Python:
Скачать дистрибутив Anaconda, чтобы использовать его со средой разработки PyCharm или блокнотом Jupyter Notebook
Скачать и установить программу Visual Studio Code
Зарегистрироваться на сайте Kaggle или Google Collab
Конечно, есть еще множество альтернативных сайтов, где вы также можете упражняться в базовых задачах по Python, однако они менее популярны. Также код на Python можно писать через виртуальное окружение папки, но эта тема подождет до более продвинутых уроков.
Среди всех способов мы выберем самый простой и подходящий для новичков — это дистрибутив Anaconda вместе с интерактивным блокнотом Jupyter Notebook.
Сам процесс установки достаточно простой. Скачав дистрибутив, вы увидите меню Anaconda Navigator и выберете Jupyter Notebook:
Сам Jupyter Notebook выглядит так:
Для начала работы достаточно выбрать в меню пункт New → Python 3:
Ввод и вывод данных
Для начала разберемся с ключевыми терминами.
Вывод данных — это отображение текста и чисел в окне программы. Например, если мы хотим написать фразу “Hello, world”, нам потребуется функция print() :
Ввод данных — это ситуация, при которой любой пользователь может запустить программу и вручную ввести некие данные. Например, чтобы создать поле для ввода имени, воспользуемся функцией input() :
Если ввести внутри скобок в кавычках любое сообщение, можно создать подсказку для пользователя. Так он сможет наверняка понять, что именно нужно ввести.
В примере выше обратите внимание на name . Это наша первая переменная — ячейка, куда мы сохраняем имя пользователя. В целом переменные — это именованные области памяти, в которых во время выполнения программы хранятся данные определенного типа. Переименование переменной или удаление ее названия не удаляет информацию из занимаемой ею ячейки памяти.
Есть два одобренных стиля, в которых называются переменные в Python:
CamelCase — каждое новое слово в составном названии переменной начинается с заглавной буквы
Underscore_notation — все слова в составных названиях разделяются нижним подчеркиванием
Название переменной в Python должно начинаться с алфавитного символа или со знака подчеркивания. При этом оно может содержать алфавитно-цифровые символы и знак подчеркивания.
Кроме того, название переменной не должно совпадать с названием ключевых слов языка Python. Их нельзя использовать потому, что они уже зарезервированы для системных названий в среде Python. Ключевых слов не так много, их легко запомнить: