DIY Database Clones
Database DevOps techniques require an easy way to provision many copies of a database, even a large database, for development work and especially for testing work. Ideally, these databases should be disposable and easy to create; developers should be able to spin up a copy of a specific version of a database, complete with data, whenever they need it.
If this requirement sounds familiar, it’s because Redgate has already developed a solution that will make this database provisioning burden easier: SQL Clone! This tool uses ‘shadow copy’ (image capture) and disk virtualization services that are built into any 64-bit Windows (7 and higher) operating system to allow teams to create copies, or clones, of even a very large database, very quickly and with minimal local diskspace requirements.
Redgate have always been open about this fact; it is reassuring for anyone who is considering the use of SQL Clone that it requires no specialised trickery that might be reliant on specific versions of SQL Server or Windows. Everyone has access to these services. Of course, in theory, this means anyone could use them to build the basics of a database cloning service that would help them get to grips with the technology and understand how it can be used in copying large databases.
This was the challenge I set myself for this article: to build a basic proof-of-concept system that could give a team some initial experience in working with the clone technology and the benefits it can bring to their Database DevOps processes.
The cost of DIY Clone
As a quick way to familiarize a DevOps team with the technology of database clones, my solution is free. However, it will require time and expertise to build it into a robust and automated solution that the team can rely on during development and testing, and it will have significant ongoing development, support and maintenance costs. It also uses one component (hobocopy) that, while it works fine in my testing, is no longer officially supported by the author.
If you are a development manager reading this article, the ‘hidden costs’ of this DIY solution might set some alarm bells ringing. Your Development and Ops teams are likely to spend quite a lot of their time building, checking, testing and maintaining it, writing the PowerShell to automate it into a self-service database provisioning system, as well as building a centralized way of managing and tracking clone deployments, all of which is built into SQL Clone, once you’ve paid the entry fee.
The cost of SQL Clone
The Redgate SQL Clone product is charged per terabyte, starting around €8K for the first 3 TB, per year. Redgate has also recently introduced Redgate Deploy that includes SQL Clone capabilities with an unlimited cap on source data. It is, instead, a subscription-based solution per user.
All that said, if you are a one-man-team and super-skilled in PowerShell, Windows and on a tight budget; the DIY SQL Clone could be the solution. It might also be practical for DIY cloning of other Windows-based database systems with large data sizes, at least if the technical expertise exists in the team to make it happen and then maintain it. This might include databases like MongoDB or PostgreSQL that SQL Clone doesn’t (currently) support. However, for any enterprise-scale developments, it would likely end up taking longer to deliver, and cost more, due to the development resources and supervision it requires, and the need to rely on long-term specialist knowledge to maintain it.
Emulating SQL Clone
SQL Clone creates one point-in-time image of the original database, and from this image it can create many clones, exact replicas with the same data, very quickly. Each clone has shared access to the data in the image, which is read-only, and any changes made to a clone are stored locally. This means that even databases that are hundreds of GB in size can be copied very quickly, because each clone requires only tens of MB of local disk space.
I won’t explain all the details of how SQL Clone achieves this, as it is explained well enough in the documentation. However, I will draw the two basic stages involved in database cloning because these are the ones we need to mimic, as closely as possible, in our DIY Clone service.
The first step is to create the image, the Parent VHD (Virtual Hard Disk), which is a point-in-time, «virtualized» copy of the source database files.
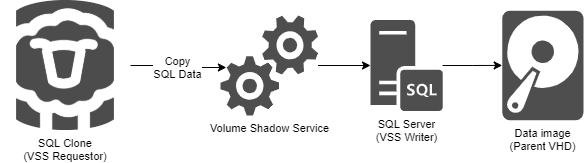
Figure 1. Create an image of your SQL Server database
The second step is to create clones from the image. For each clone, SQL Clone creates another VHD, called a differencing VHD (or Diff file), with a connection back to the parent (image) VHD.
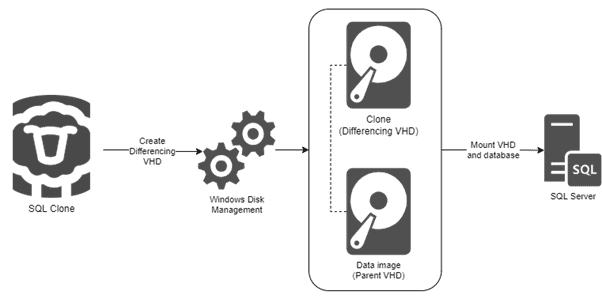
Figure 2. Create clones from the image
As I mentioned earlier, SQL Clone does all this using two Microsoft services and techniques that are built into Windows – the Volume Shadow Copy Service for copying ‘live’ database files, and the Windows Disk Management provider, for creating and mounting virtual hard disk (VHDx) files, to create the images and clones.
Building DIY SQL Clone
What we aim to do with our DIY Clone is to use these same services to achieve something similar. Our DIY clone service will copy the SQL Server data files from a live database and then mount them on a local SQL Server instance. Instead of just putting these files in a directory, it puts them in a parent VHD (the image) and from that creates a differencing disk that represents the data for a database. We mount the one or more differencing disks on the local SQL Server to host the clone(s).
Create an image of your SQL Server database
The Microsoft Volume Shadow Copy Service (VSS) allows you to back up application data without taking the application offline. These backups are called shadow copies. Well-known examples of making so-called shadow copies are Windows System Restore and Windows backup software (like Veaam).
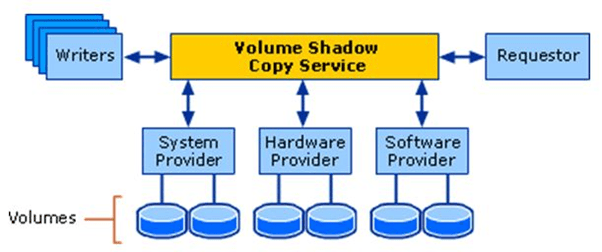
Figure 3: Architectural diagram of Volume Shadow Copy Service (copyright Microsoft)
VSS Requestor
If you try to copy files in windows Explorer or in PowerShell, it will give an error. Only a VSS Requestor can copy MDF files.
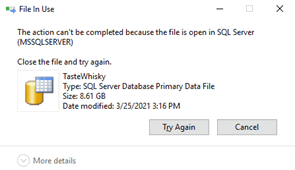
Figure 4: Files in use error when copying a MDF file
To make a copy of open files a VSS enabled Requestor must be used or written.
The Requestor can be any application that has the VSS API implemented. The VSS API is a set of COM and C++ APIs that third party developers can use to develop applications to create and manage shadow copies. If you are not so skilled with C++ there is also an open-source .NET library called AlphaVSS. To reveal a secret, that’s not only what Redgate is using, Redgate is also contributing to the project.
For the proof-of-concept we are not programming in C++ or .NET, but we keep it simple and use a CLI tool, created by Craig Andera, named Hobocopy. This is not a typo for robocopy. It is a tool inspired by both the name and functionality. The big difference is that hobocopy uses VSS to snapshot the disk before copying. And that is exactly what we want.
VSS Writers
Another important part of VSS are the Writers. The SQL VSS Writer does the magic for SQL Server related copies. This part guarantees that the MDF / LDF files, even though they are in use, can be copied if a Requestor, in our case Hobocopy, asks for it.
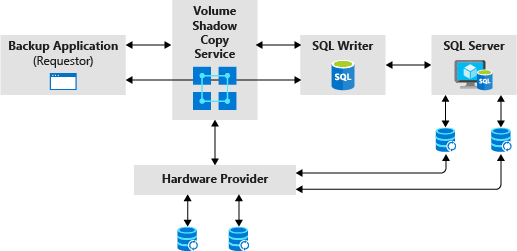
Figure 5: The role of the SQL writer in a VSS snapshot backup operation (copyright Microsoft)
The SQL VSS Writer does this by making a backup, with snapshot, in the background when the Requestor tries to copy the folder with MDF / LDF files. For the shadow copy, not the open MDF / LDF file is offered, but a snapshot of it.
Create a «snapshot» of the database files using Hobocopy
If you have your SQL Server data stored in F:\SQL\Data and want to copy the online database files to C:\Backup you can use this command:
This code looks disarmingly simple but what happens ‘behind the scenes’ is a bit more complicated, and is explained in the sequence diagram of the VSS snapshot workflow on the Microsoft SQL VSS Writer documentation page. Below I tried to simplify the VSS Workflow, using Hobocopy as the Requestor.
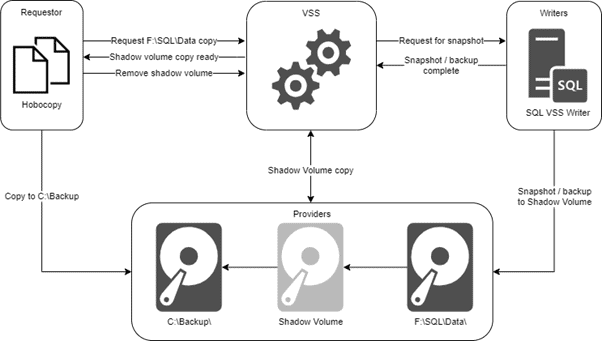
Figure 6: Simplified VSS Workflow for the hobocopy example
Virtual Hard Disks
We will not be copying the data files to a local disk but to a Virtual Hard Disk (VHD), which is just a file that acts like a disk.
To ensure that the VHD will always popup in the same location (drive letter), no matter what other drives are connected (such as removable USB), we need to mount the VHD as a NTFS folder. This Windows Disk Management feature can mount any partition as a folder, also physical drives.
For our DIY SQL Clone, we won’t be using the Windows Disk Management GUI but the PowerShell Storage Cmdlets¸ built into Windows. For creating VHDx disks, we also need the help of a set PowerShell Cmdlets that are part of the Hyper-V module. This module is available for Windows via Add a feature or can be installed and activated with PowerShell. Please see Nicolas Prigent’s article for more information on activating the Hyper-V Windows feature with PowerShell.
Create a parent VHD (the data image)
In the following example, we want to create a dynamically growing VHD that will be mounted to the folder, C:\mnt\parent\.
Listing 1: Create a VHD and mount it to a folder
Here is the result:
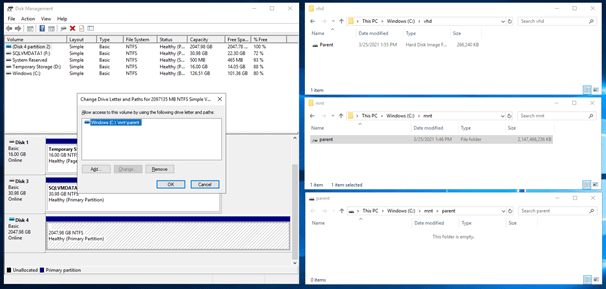
Figure 7: Result of the VHD creation and folder mounting
Now we will use hobocopy to copy all files that are in the folder F:\SQL\Data to C:\mnt\parent\, the folder mounted VHD we have just created.
Listing 2: Copy files with hobocopy to the VHD
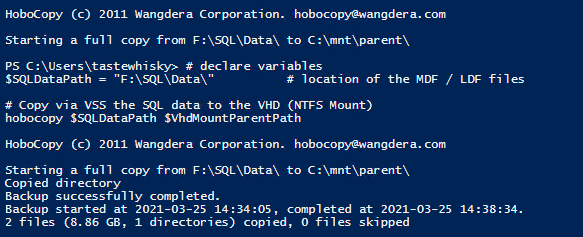
Figure 8: Terminal output of the hobocopy command
Create the clone from the image
With hobocopy as VSS requestor and the parent VHD, we emulated the first stage of database cloning, it is now time to mimic the rest.
Differencing VHDs
The data image is created as a parent VHD, but it does not stop there. With VHDs on Windows we can use a technique to make Parent and Differencing disks.
These differencing disks (also called child disks) are seen by Windows as copy of the original VHD but with a fraction of the size. To be more precise the Differencing VHD only contains the differences from the parent VHD, and the VHDs together are seen by Windows Disk Management as just one disk.
The parent VHD must be set to read-only when used in a differencing use case. This means that any database clones created from the parent VHD all see the same ‘immutable’ data in the parent image, plus local changes (stored in the differencing disk). This makes a clone very quick and easy to reset back to its original state.
Storing all our SQL Server data on a parent disk and creating a differencing disk from it sounds a bit SQL Clonish, doesn’t it? Spot on, this is exactly what SQL Clone does.
Create a differencing disk
It is now time to create the clone, which is a child VHD or in other words, a differencing disk for the parent VHD, which contains all the SQL data.
Before we create the child VHD, we first dismount the parent VHD and make it read only. We then create the new VHD and mount it to the folder, C:\mnt\clone<copy>\. The copy part can be used to make more than one clone copy, with the same script.
After creating and mounting the child VHD, we ensure that the disk will come online in Windows Disk Management. This extra step is needed to ensure that Windows changes the GUID of the drive. Repeatedly creating child VHDs causes duplicate GUIDs.
Listing 3: Create a differencing VHD and mount it to a folder
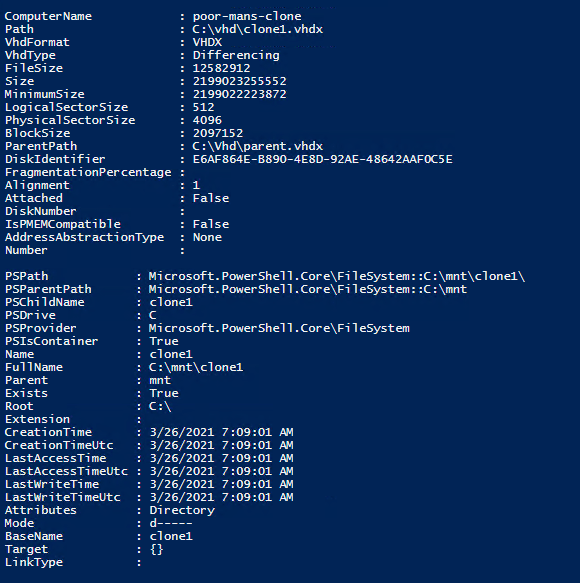
Figure 9: Terminal output when creating a differencing VHD and mounting it to a folder
Mount the database
At this point we have created a clone of the original VHD, the only thing left to do is attach the SQL Data files as a SQL ‘clone’ database.
The script can be used for both attaching and detaching the database. It also contains @Copy for more than one clone copy, with the same script.
Listing 4: Attach or detach the cloned database
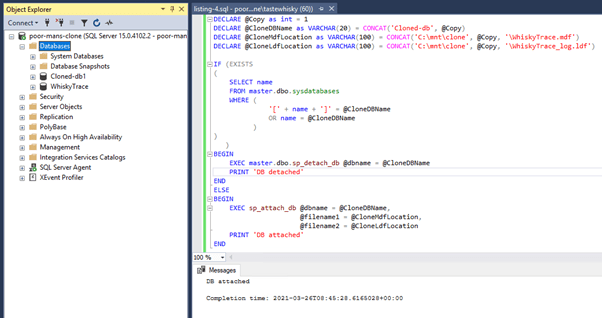
Figure 10: SQL Server Management Studio with database clone (Cloned-db1)
Cleaning up and other options
There are a few other parts to this process, such as removing a clone, making multiple clones, and changing the location for storage.
Remove the clone
After detaching the cloned database(s) we need to tidy up and remove the child VHD and folder mount.
Listing 5: Dismount Child VHD and remove NTFS folder mount
From this point on we can start again with Listing 3, to create one or more clones.
Cloning more than one database
The scripts provided in the listings are used with one database to prove the concept. They can easily be used to clone several databases, if the data files reside in the same folder.
VSS will automatically snapshots all the files in the source folder. This way the parent and child VHD will contain all the database files. The only thing to adjust is the attach / detach TSQL script. This way you could clone a whole instance of a database server.
Storing the image on a Network share
In this proof of concept, the parent VHD (the image) was copied to the local disk. If the parent VHD is copied to a Windows network share, more users can make use of the DIY SQL Clone.
The clones can be used if the Windows network share is available. This is exactly how Redgate SQL Clone works and the same limitations apply here.
Conclusions
So, as we can see, the technology behind SQL Clone is no secret and you can certainly look at creating a solution yourself which may seem very appealing in the short term, especially in terms of costs, but working like this creates more issues down the line, as the following table comparing Redgate SQL Clone to our DIY SQL Clone:
License costs are a barrier for some organizations
Redgate SQL Clone has had a full development team working on it from 2016, and since the launch in 2017 the product has been successfully implemented in hundreds of customer environments. The feedback Redgate received from their customers is based on many development scenarios in multiple environment configurations and has resulted in a robust and performant product far exceeding the capabilities of our DIY version.
Redgate will continuously fix bugs and make improvements, provides a rich PowerShell library, an extension for Azure DevOps and TFS and a number of integrations with Redgate SQL Change Automation and Redgate Data Masker. All fully supported by the Redgate engineering team.
And that is exactly where the shoe pinches. The DIY SQL Clone looks like a cost-effective solution initially, but who supports, maintains and develops it in the end?
This is an article by Tonie Huizer, Tonie is a Solutions Architect at Promicro, the independent & collaborative Microsoft professionals.
Related Content
To learn a bit more about SQL Clone, and its uses during database development, see:
VSS для самых маленьких
Снятие снапшота — именно с этого начинается любой бекап. До тех пор, пока мы не знаем, как сбросить все буфера на диск и привести файлы с данными в консистентное состояние, мы не бекапы делаем, а занимаемся копированием файлов с непредсказуемым содержимым внутри. Понимая важность снапшотов, все вендоры стараются дать нам если не полностью готовую функцию (типа Time Mashine в MacOS), то хотя бы набор ручек, за которые можно подёргать (вроде модуля dm-snap в ядре Linux).
Но сегодня речь пойдёт про самую распространённую ОС — Microsoft Windows, где эта задача решается с помощью Volume Shadow Copy сервиса, известного в народе под аббревиатурой VSS (Volume Snapshot Service). А нашего внимания он удостоился из-за того, что, несмотря на всю популярность своего материнского корабля, сам он окутан вуалью из тайн и мистических слухов. Давайте уже как-то разберёмся с этой штукой.
А, собственно, что с ним за проблема? Вот есть документация, где вполне адекватно и красиво описано, как всё работает. Есть утилита vssadmin, позволяющая вполне годно создавать и удалять снапшоты. Что не так-то, и где сложности?
Но проблема в том, что более лучшая документация, намного правильнее отражающая происходящие процессы, несколько сложна для понимания. Microsoft вообще написал по этой теме какое-то неслыханное количество документов. Но даже когда вам как-то удаётся выстроить в голове работу этого алгоритма, вы сразу сталкиваетесь с тем, что на практике многие вещи работают совершенно не так, как описаны. Или вообще не работают. А что-то не описано совсем, хотя этому мы уже давно не удивляемся. Но не хвататься же сразу за дебагер и дизассемблер, да?
Хотя упомянутый выше vssadmin как-то вроде и работает, и снапшоты даже делает, и вообще молодец. Но это всё до того момента, пока ты не начинаешь вникать в тонкости, где может выясниться, что репорт об успешно созданном снапшоте — это репорт о чём угодно, только не об успешно созданном снапшоте.
Вот поэтому и захотелось немного поговорить о том, как же на самом деле работает VSS. И да, строго говоря, результатом работы VSS является созданная shadow copy. Но дабы не ломать язык и не мучить вас транслитом, давайте просто писать снапшот.
Какова роль VSS
Не сомневаюсь, что 90% читающих прекрасно понимают, зачем нужны снапшоты, но ради оставшихся 10% потерпите несколько предложений. Или сразу идите в следующий раздел.
Итак, все кто остался, давайте представим, что есть у нас некий диск, на котором находятся файлы, с которыми кто-то работает и как-то их изменяет. Изменения эти накапливаются, а иногда очень хочется иметь возможность взять и вернуться во времени назад. И желательно откатывать изменения не для всего диска, а только для выбранных папок и файлов. Для этого и был придуман механизм теневых копий.
Сами снапшоты ничего не знают про ваши файлы и папки. Они работают на уровень ниже файловой системы — с блочными устройствами и блоками данных. Если придерживаться терминологи Microsoft, то снапшот — это место, именуемое Shadow Storage, куда записываются изменённые блоки данных и откуда их можно извлекать с целью переписать данные на оригинальном диске. Тут можно запомнить для себя два нюанса. Первый — только что сделанный спапшот занимает ровно ноль байт. Это просто пре-алоцированное место, куда файловая система может копировать измененные блоки (или наоборот, новые блоки, но не суть). И второй — теневая копия суть есть дифференциальный бекап. Все данные, которые вы изменили, не удаляются, а отправляются на хранение в этой зоне.
Где найти VSS
Обнаружить следы VSS можно двумя классическими способами: через GUI или в консоли. В зависимости от конкретной версии системы пути могут немного отличаться, но суть будет одинакова. Итак, есть у меня в лабе Windows Server 2019, и если сделать ПКМ на любом диске в проводнике, мы увидим два пункта: Configure Shadow Copies и Restore previous versions.

Если зайти в мастер настроек, то можно включить создание теневых копий для любого диска, задать расписание, по которому они будут создаваться и, что самое интересное, указать место хранения этих копий. Строго говоря, даже не самих копий, а так называемой diff area — места, куда сбрасываются перезаписанные на оригинальном томе сектора. То есть мы запускаем создание снапшота одного диска, а его данные физически храним на другом. Функция архиполезная и позволяет не просто снижать нагрузку на конкретном диске, но и делать фокусы а-ля снимаем снапшот одной ноды в кластере и цепляем его к другой.

После того, как вы всё настроите на свой вкус, появляется смысл в пункте Restore previous versions. Чисто технически туда и до этого можно было зайти, однако внутри, скорее всего, будет только гнетущая пустота.
Но всё это баловство с графическим интерфейсом, и как мы знаем, до добра это не доводит, поэтому открываем powershell (или даже cmd, почему нет) — и там у нас имеется два варианта из коробки: vssadmin и diskshadow. Первая утилита есть практически на любой системе, начиная с WinXP/Win2003. Нет её только на Windows 8. По какой-то таинственной причине из “восьмёрки” вырезали инструменты управления теневыми копиями, но потом осознали свою неправоту и вернули всё на место. А вот diskshadow доступен только на серверных вариантах Windows. Это уже более продвинутый вариант vssadmin, позволяющий работать не только в интерактивном режиме, но и выполнять целые скрипты, написанные на понятном этому интерпретатору языке. Да и просто это более адекватный и поддающийся контролю инструмент.
И запоминаем самое важное: это две разные утилиты, существующие в разных контекстах. Теневая копия, сделанная в одной утилите, будет видна другой, однако статус у неё будет неоперабельный.
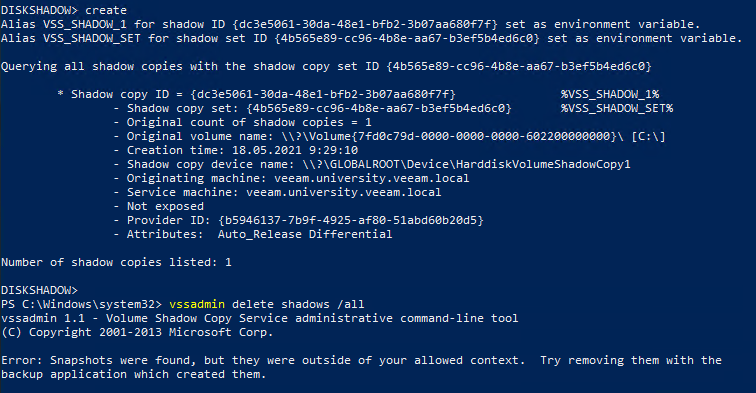
Вот отличный пример: мы создали снимок в diskshadow и пытаемся удалить его с помощью vssadmin. Сам снимок мы видим, но он не в нашем контексте, поэтому сорян, у нас нет здесь власти.
Технически ничего не мешает одновременно делать снимки с помощью vssadmin и diskshadow. Хотя есть вероятность, что получите сообщение типа Another shadow copy is in progress. Но это так, к слову пришлось. Не надо пытаться одновременно делать несколько снапшотов разными программами.
Как появился VSS
Итак, судя по написанному выше, всё просто: нам надо просто брать появляющиеся блоки и сохранять их куда-то в сторонку, чтобы при необходимости вынимать обратно. Сразу возникает первый вопрос: а что именно надо сохранять в нашем теневом хранилище? Ведь действительно, можно просто писать в него все приходящие новые блоки и сохранять в метаданные, на какое место они (блоки) должны были быть записаны. А можно поступить чуть сложнее и записывать новые блоки сразу на полагающееся им место, а в хранилище отправлять содержимое перезаписываемых блоков. Что лучше и как выбрать? На самом деле право на жизнь имеют оба варианта, и какой выбрать — зависит исключительно от воли вендора. Первый подход (redirect-on-write, RoW, если оперировать грамотными терминами) быстро пишется, но долго читается. Зато если надо откатиться на первоначальное состояние, это делается моментально — мы просто удаляем наше теневое хранилище. Второй подход (copy-on-write, CoW) пишется медленней, читается быстрее и моментально удаляет копии предыдущих состояний. VSS, к слову, придерживается парадигмы CoW, а в снапшотах VMware реализован RoW.
Но на самом деле этот вопрос не самый важный из тех, которые стоит себе задать перед тем, как начать перехватывать появляющиеся блоки и складывать их в сторонке. Главный вопрос — в какой именно момент надо осуществлять перехват?
Давайте рассмотрим хрестоматийную ситуацию с файлом базы данных. (И если у вас уже заскрипел песок на зубах, смело пропускайте следующие два абзаца.) Итак: у нас есть банальная SQL Server база данных в виде mdf файла, и тут к нам прилетает какой-то запрос. SQL, как порядочное приложение, начинает старательно вносить изменения в файл, а мы старательно перехватываем каждый новый блок данных падающих на диск и пишем в нашу теневую копию. Всё хорошо и здорово, но тут выключили свет. Потом свет включили, сервер запустили и мы даже базу восстановили из нашей теневой копии, но тут оказывается, что SQL не запускается. Говорит — база в не консистентном состоянии. Это значит следующее: во время нормальной работы завершение каждой транзакции помечается специальным флагом. Сервер его видит и знает, что всё хорошо. А тут сервер загружается, видит, что из его базы торчит какой-то кусок данных, флага нет и, следовательно, что с этим всем делать — он понятия не имеет. То ли удалить, то ли дописать, то ли ещё что-то. Но у нас тут не угадайка, а всё должно быть однозначно и консистентно. Поэтому он принимает решение выключиться, дабы не поломать базу ещё сильнее.
Хорошо, но как избежать подобных приключений? Отличным вариантом будет подождать, пока SQL сервер допишет свою транзакцию, пометит её как завершённую, и потом мы быстренько заберём все появившиеся новые блоки. Отличный вариант, который надо срочно реализовывать! Вот только есть небольшая проблема: до этого мы говорили про одно приложение и один файл, с которым оно работает. Научиться общаться с условным SQL Server много ума не надо, но что делать с остальными миллиардами существующих приложений? А что делать, в конце концов, с самой ОС, у которой внутри огромное количество своих процессов и открытых файлов? Вот примерно с такими проблемами и столкнулись учёные мужи из Microsoft, когда пришли к выводу, что надо реализовать некий общий интерфейс, через который можно будет сразу всем прокричать нечто вроде: “Сейчас мы будем делать снапшот, так что быстренько сворачиваемся и сбрасываем буфера на диск! Приостанавливайте свою кипучую деятельность и приводите данные в консистентный вид!”. Ну а назвать эту штуку они решили, как вы уже догадались, Volume Snapshot Service. Или просто VSS.
И тут можно воскликнуть — но ведь в Windows 2008 был представлен Kernel Transaction Manager! Это разве не то же самое? Он же как раз занимается тем, что приводит файлы на диске в консистентное состояние. А вот и нет! То есть да, KTM приводит, но отвечает только за дисковые операции, а что там происходит с приложениями — его мало волнует. А ведь многим из этих приложений важна не просто целостность файлов, но и что в них записано. Классический пример — это Exchange и Active Directory. И тут мы подошли к важной теме:
Как устроен VSS
Чтобы не прыгать с места в карьер громады страшных терминов и процессов, начнём с высокоуровневого описания. Поэтому ограничимся таким списком компонентов:
VSS Writer. В кириллическом простонародье известен как просто райтер, поэтому так и будем его называть в дальнейшем, вызывая праведный гнев ненавистников англицизмов.
Райтер занимается тем, что выстраивает мостик взаимодействия между VSS подсистемой и конкретным приложением. Поэтому а) в любой системе их будет достаточно много (проверьте у себя с помощью vssadmin list writers) б) райтер всегда пишется поставщиком приложения, ибо кроме него никто не знает, что там и как должно происходить во время создания снапшота.
Соответственно, райтер по своей сути выполняет роль “регулировщика”: сначала он говорит приложению подготовиться к снапшоту, затем даёт отмашку VSS сервису делать снапшот. Или не даёт, если приложение не смогло за установленный промежуток времени подготовить свои файлы.
Также хочется отметить, что райтеры — это какие-то невероятно нежные ребята, которые зачастую ломаются без каких-либо внешних признаков. Поэтому если в выводе vssadmin list writers в поле State вы увидите что-то, отличающееся от Stable, это надо чинить, ибо сделать консистентный бекап, увы, не получится.
VSS Provider. Тот самый парень, который занимается созданием и управлением снапшотами. Известен тем, что бывает софтовый или хардовый. Список установленных в системе провайдеров можно посмотреть с помощью команды vssadmin list providers. По дефолту, с системой идет Microsoft Software Shadow Copy provider. Он даже отлично и замечательно работает, но до тех пор, пока вы не подключите к системе брендовую СХД. Хорошие вендоры всегда снабжают свои железки управляющим софтом, в составе которого находится и родной провайдер к этой железяке. Благодаря этому можно уже делать всякие хитрые трюки, которые реализованы в вашем оборудовании, и именно поэтому мы в Veeam так гордимся списком интеграций с железом.
VSS Requestor. Участник процесса, который инициирует создание VSS снапшота или восстановление данных. Можно сказать, что реквестор — это бекапное приложение, которое общается с райтерами и провайдерами. Может показаться, что его роль незначительна, однако от грамотности реализации реквестора зависит качество получаемого результата. То есть VSS не будет за вас думать, что и в каком виде надо сделать. Чем более чёткие инструкции выдаст реквестор, тем более предсказуемым будет результат.
Как в итоге всё выглядит на самом высоком уровне: реквестор стучится в Volume Shadow Copy сервис, тот отдаёт команду райтерам предупредить приложения о надвигающемся снапшоте, райтеры рапортуют об успехе, а сервис отдаёт команду провайдерам делать снапшоты. О результатах докладывается реквестору.
Но на деле, очевидно, всё несколько сложнее. На первом шаге реквестор проверяет, что вообще есть в наличии и с кем предстоит общаться. Затем после составления списка райтеров он обращается к провайдеру, объясняя, что он хочет заснапшотить и где должен располагаться снапшот. Это называется SnapshotSet. В большинстве случаев он будет располагаться на том же вольюме, что и оригинальный диск. А меньшинство случаев — это те самые хардварные провайдеры, которые поставляются вместе с СХД. Для них нормой считается создавать отдельный вольюм для снапшота, который называется storage snapshot. А в определённых случаях можно так и вообще перемещать снапшот на другое физическое устройство, чтобы выкачивать данные уже оттуда, а не с прода. Без хардварных провайдеров сделать такое не выйдет.
Следом начинается стадия, именуемая Prepare for backup. На этом этапе мы должны уже не просто изучить метаданные райтеров, а запросить их реальные статусы и приготовиться к самой жаркой поре: все райтеры должы будут отработать один за другим. Причём каждый должен уложиться в отведённое ему время, которое по умолчанию равно 60 секундам. Так решили в Microsoft, забыв уточнить причины. Но есть ещё приложения-чемпионы, например, Exchange. Его авторы посчитали, что 20 секунд более чем достаточно, и остановились на таком лимите. А чем чревато невыполнение этого этапа, который в документации называется OnFreeze? Тем, что райтер вернёт сообщение об ошибке, и снапшот не будет сделан. После чего в интерфейсе Veeam появится одна из каноничных ошибок вроде “VSSControl: Failed to freeze guest, wait timeout». Тут радует одно: в логах VSS всегда будет написано, какой именно райтер завалил задание. А по самим ошибкам уже столько KB написано, что вспоминать страшно. Но если вы вдруг сомневаетесь, то точно вам говорю — написанному в них можно смело верить. И если после всего получается, что у вас слишком медленное хранилище, и за отведённое время не получается сбросить все кэши на диск, ну, значит, так оно и есть. Физику не обманешь, а вот железо надо хоть иногда обновлять.
Но это был пессимистичный вариант (прошу понять меня правильно, но беды с VSS — это очень частная причина обращений в сапорт), а в оптимистичном можно начинать самый важный этап. Как только райтеры рапортуют, что всё, вся деятельность в системе заморожена, а кеши сброшены на диск, у нас есть десять(. ) секунд на создание снапшота, после чего райтеры будут принудительно разморожены, и всё закрутится вновь. И можно сказать, что на этом процесс бекапа заканчивается, и всё что нужно — это просто импортировать наш снапшот и скачать его куда-то к себе, чтобы сохранить под семью замками. Однако есть одно важное Но — log truncate. Фундаментально это вообще не связанные операции и транкейт зависит только от бекапа логов, но как все мы понимаем — на пользовательском уровне эти вещи связаны в единый процесс. То есть, прежде чем выкачивать снапшот, надо не забыть выдать команду backup log, которая запустит операцию транкейта. И после этого совесть наша чиста.
Но что дальше происходит с данными? Если мы действительно используем какое-то приложение для бекапов, которое запустило весь этот процесс, дождалось его завершения и скачало данные в своё хранилище, то снимок можно просто удалить одной командой. Поскольку VSS пропагандирует CoW подход, то речь здесь действительно о банальном удалении нашей аллоцированной зоны, ведь все новые данные сразу пишутся на оригинальный диск. Это называется non-persistent shadow copy, и она не имеет никакого смысла без оригинального диска.
Чтобы пройти этот путь вручную, достаточно открыть консоль и набрать:
Здесь мы видим, что успешно создался снапшот со своим Shadow copy ID, и для удобства ему сразу присвоили алиас VSS_SHADOW_1. Этими данными вполне можно оперировать, если возникает такое желание. Однако не будем уходить в сторону и попробуем прочитать содержимое этого снимка. Для чего подмонтируем его в качестве диска.
Однако на такое, казалось бы, простое и законное желание мы получили не менее законный отлуп, ибо сделали non-persistent снимок, а, значит, единственное, на что он годится — это записать его поверх родного, удалив на нём всю информацию, которая появилась после создания этого снимка. Но такая история нас не устраивает, поэтому стираем всё безжалостно.
И начинаем всё заново, только теперь укажем, что нам нужна персистентная копия, чтобы мы могли использовать её как полноценный диск.
Как мы видим: Attributes: No_Auto_Release Persistent Differential. Поэтому если теперь вы сделаете expose, то снапшот примаунтится как полноценный диск, по которому можно перемещаться и копировать с него файлы. Диск, само собой, виртуальный и состоит из блоков оригинального диска, плюс блоки изменившихся данных, читая которые, мы можем видеть состояние оригинального диска на момент снапшота. Всё просто.
Только учтите, пожалуйста, такой момент, если вдруг решите, что нашли святой грааль: в таком режиме нельзя занимать данными больше 50% места на диске. Один блок свыше — и всё, диск переполнился.
Что тут хочется ещё сказать, а вернее, спросить: если всё так просто, то почему же я говорю, что всё так сложно? Проблема в том, что, отдавая на боевом сервере команду vssadmin create shadow, мы, конечно, создаём какой-то снимок, но как себя будут чувствовать приложения после отката на этот снимок, мы предсказать не можем. Это не шутка: команда create признаёт наличие ошибок при выполнении как вариант нормы. Райтер не вернул вовремя Ок от приложения? Да кому это надо, го делать снапшот, я создал.
Поэтому когда за дело берётся настоящее бекапное приложение вроде Veeam Backup & Replication, то речь идёт не об одной команде, а о целой россыпи предварительных запросов, в результате которых формируется огромнейшая команда (это не метафора для красного словца, а реальность), в которой учитываются состояния райтеров и приложений на целевой системе, с жестким требованием соответствия всех статусов необходимым. Словом, количество мест, где что-то может пойти не так, вырастает на порядок. Ведь нам главное — не снапшот создать, закрыв глаза на сопутствующие потери, а гарантировать консистентность данных внутри него.
Как лечить VSS
Сразу, не отходя от кассы, открою вам тайну самого лучшего метода лечения большинства проблем с VSS — перезагрузка. Понимаю, что это кощунство и кошмар наяву для всех свидетелей аптайма, но суровая правда жизни такова, то можно сколь угодно долго биться с пациентом, чтобы потом всё починилось само от перезагрузки. Да, именно так. Это тот случай, когда само сломалось и само починилось.
Другая проблема — это железо. Помните про временные рамки для райтеров? Про десять секунд на снапшот? Для многих это ограничение становится проблемой из-за того, что СХД физически не успевает сделать требуемые действия за отведённое время. Как это лечится? А вот никак. Или покупаем более мощное железо, или ищем пути снижения нагрузки, чтобы операция была проведена за выделенный промежуток времени.
Если посмотрите одно из самых популярных KB1680: VSS Timeout when backing up Exchange VM, то легко обнаружите, что первые три шага для решения всех проблем с VSS — сделайте снапшот вручную и посмотрите чтобы это заняло менее 20 секунд, перезагрузитесь и попробуйте снизить нагрузку. Вот так и живём, да.
И что же делать, если VSS падает, в ивентах ничего нет, а понять, что происходит надо? Тут я могу порекомендовать три хороших статьи:
КВ от Veeam, посвящённое анализу поведения VSS с помощью diskshadow.
Другое KB от Veeam, посвящённое сбору информации с помощью vsstrace из Windows SDK. Но скажу сразу, это уже не для слабых духом.
И видео от моего коллеги, где он наглядно показывает, как работать с информацией из первых двух пунктов =) Рассказывает он действительно хорошо, но с непривычки голова у вас от объёма информации заболит, это я вам обещаю.
Также в гугле можно найти массу толковых советов по поводу приведения VSS в чувства, только рекомендую не бросаться на первый попавшийся случай, а постараться найти наиболее похожий именно на вашу проблему. По коду ошибки, например. Потому что слишком много возможных комбинаций ошибок, приложений и причин их возникновения.
А на сегодня всё. Я и так хотел кратенько, но получилось больше десяти страниц текста. Поэтому самое время закругляться. Если хочется раскрытия какой-то другой темы или углубиться в детали VSS, то обязательно пишите об этом в комментариях.
Differential Base and VSS Backups
VSS backups are a common way of taking SQL Server database backups using various backup utilities that are available today. However, one of the not commonly known facts is the differential backups that can be performed using VSS APIs. The SQL Server VSS Writer service is the one which facilitates the backups of SQL Server databases through VSS APIs.
The SQL writer supports differential Backup/Restore through two VSS differential mechanisms: Partial File and Differenced File by Last Modify Time.
Partial File . The SQL writer uses the VSS Partial File mechanism for reporting changed byte ranges within its database files.
Differenced File by Last Modify Time . The SQL writer uses the VSS Differenced File by Last Modify Time mechanism for reporting changed files in full-text catalogs.
For more information, read the technical reference document on VSS backups and SQL Writer.
Once of the first points that you need to remember with VSS backups of your SQL Server databases is that a non-copy only VSS backup can break the differential chain. For more information on VSS Copy Only backups, read the blog post on the same topic.
Let me show that with an example. I will start with three full backups of my Adventureworks database in the following order:
1. Database Full backup using VSS backup
2. Database Full backup using native SQL backup
3. Database Full backup using VSS backup
When I look into the system catalogs, I find that the Differential Base LSN changes with each backup done. The differential base time is reported in GMT which is (+5:30 for my server’s time zone). The data shown below was retrieved from the sys.master_files output after each backup.
| Differential Base LSN | Differential Base Time |
| 58000000764000000 | 5:09:54 PM |
| 58000000767800000 | 5:11:55 PM |
| 58000000770500000 | 5:12:21 PM |
I validated the above entries with my SQL Server Errorlog as well:
2013-01-05 22:39:54.310 spid55 I/O is frozen on database AdventureWorks. No user action is required. However, if I/O is not resumed promptly, you could cancel the backup.
2013-01-05 22:39:54.330 spid55 I/O was resumed on database Adventureworks. No user action is required.
2013-01-05 22:39:54.340 Backup Database backed up. Database: AdventureWorks, creation date(time): 2012/09/21(20:50:44), pages dumped: 21978, first LSN: 58:7640:65, last LSN: 58:7668:1 , number of dump devices: 1, device information: (FILE=1, TYPE=VIRTUAL_DEVICE: <‘<24635C74-D8AD-475C-88AE-831D0F31AD79>’>). This is an informational message only. No user action is required.
2013-01-05 22:42:04.650 Backup Database backed up. Database: adventureworks, creation date(time): 2012/09/21(20:50:44), pages dumped: 22027, first LSN: 58:7678:37, last LSN: 58:7695:1 , number of dump devices: 1, device information: (FILE=1, TYPE=DISK: <‘<directory>\adw.bak’>). This is an informational message only. No user action is required.
2013-01-05 22:42:21.300 spid55 I/O is frozen on database AdventureWorks. No user action is required. However, if I/O is not resumed promptly, you could cancel the backup.
2013-01-05 22:42:21.310 spid55 I/O was resumed on database Adventureworks. No user action is required.
2013-01-05 22:42:21.310 Backup Database backed up. Database: AdventureWorks, creation date(time): 2012/09/21(20:50:44), pages dumped: 21978, first LSN: 58:7705:37, last LSN: 58:7722:1 , number of dump devices: 1, device information: (FILE=1, TYPE=VIRTUAL_DEVICE: <‘<17FAEB54-A411-4E16-BD96-FF5DE627CEDB>’>). This is an informational message only. No user action is required.
Now when I take a differential backup of the AdventureWorks database, the differential base guid is reported as 9EAAC560-B5AB-4DE6-A44B-A52E8D5BD82B and the differential base lsn is reported as 58000000770500037. This matches with the differential base guid that is reported by sys.master_files. However, this differential backup cannot be restored as the VSS backup taken was not a valid VSS backup.
The screenshot below shows the sequence of backups.

To summarize, if you have an application which takes VSS backups of volumes which contain SQL Server database files, then it could inadvertently invalidate your differential backups of your SQL Server databases even if you are not backing up SQL Server database files. If your VSS backup application does not use the COPY ONLY option, then the full backup of the database files taken by the snapshot backup of the volume will become your new differential base.