MySQL Как быстро посчитать все строки в таблице
Существует несколько способов получить количество строк в таблице MySQL. Некоторые продукты управления базами данных предоставляют статистику базы данных, например, размеры таблиц, но это можно сделать и с помощью прямого SQL.
Считать кол-во строк в PHP почти всегда непроизводительно.
- information_schema.TABLES
- SHOW TABLE STATUS
- SQL_CALC_FOUND_ROWS
- Функция COUNT()
- Подсчет всех строк в таблице
- Подсчет не-NULL строк — разница между COUNT() и COUNT(*)
- Подсчет только NULL строк
- Подсчет уникальных значений
- Условные подсчеты с использованием выражений
information_schema.TABLES
Это способ позволяет получить данные о колличестве строк во всей таблице (без учета WHERE). Такие данные храняться в служебной таблице information_schema.TABLES :
Этот метод очень быстрый, но не точный, поскольку данные в information_schema о количестве строк и фактическое количество строк в таблицах не всегда синхронизированы. Чтобы этого избежать, необходимо выполнить оператор ANALYZE TABLE перед запросом к таблице information_schema.
SHOW TABLE STATUS
Мы также можем получить данные таблицы следующим запросом:
В колонке Rows находится кол-во строк в таблице.
SQL_CALC_FOUND_ROWS
Этот способ не самый быстрый, но есть случай, когда COUNT(*) не подходит, например когда результаты группируются, можно столкнуться с проблемой, что COUNT на самом деле не считает все строки.
Решением является SQL_CALC_FOUND_ROWS — этот маркер нужно добавить сразу после SELECT :
После запроса кол-во всех строк нужно получить еще одним запросом — он должен быть сделан сразу после запроса на выборку данных:
Функция COUNT()
При COUNT(*) учитываются индексы столбцов, поэтому результат будет хорошим по производительности. Также, стоит отметить, что таблица MySQL с движком MyISAM хранит количество строк как впомогательные данные к таблице и он не считает все строки каждый раз при запросе если это возможно.
Если COUNT(*) работает медленно, нужно добавить в начало запроса маркер EXPLAIN и проверить, какие индексы используются, и где их следует добавить.
Функция COUNT() считает количество строк в таблице. Она подходит для подсчета как всех строк таблицы, так и строк подходящих под условие WHERE. Есть несколько сигнатур:
COUNT(*) — получит всё не-NULL и NULL строки (одинаковые значения считаются по отдельности).
COUNT(expr) — возвращает набор результатов, не содержащих NULL строк.
COUNT(DISTINCT expr) — возвращает количество уникальных строк, не содержащих значений NULL.
В каждом случае COUNT() возвращает BIGINT — количество совпавших строк. Или ноль, если не было найдено ни одной.
Подсчет всех строк в таблице
Чтобы подсчитать все строки в таблице, независимо от того, содержат они значения NULL или нет, используйте COUNT(*). Такая запись в основном возвращает количество строк в наборе результатов, возвращенных оператором SELECT.
Вызов COUNT(*) без WHERE или дополнительных столбцов, будет работать очень быстро в таблицах MyISAM, поскольку количество строк хранится в столбце table_rows в таблице tables базы данных information_schema .
Для транзакционных систем хранения данных, таких как InnoDB, хранение точного количества строк проблематично, поскольку InnoDB не ведет внутренний подсчет строк в таблице. Если бы он велся, то одновременные транзакции могли бы «видеть» разное количество строк в одно и то же время. Следовательно, операторы SELECT COUNT() подсчитывают только строки, видимые текущей транзакции. Это означает, что выполнение запроса с COUNT() при большой нагрузке может привести к неточным числам.
Подсчет не-NULL строк — разница между COUNT() и COUNT(*)
Если в COUNT() ничего не передавать, то выполняется версия функции COUNT(expr) , но без параметров. Вызов COUNT() таким образом возвращает только строки, где нет NULL. Например, у нас есть таблица code_values:
Запрос COUNT() вернет 2, хотя в таблице 4 строки:
Обратите внимание, что эта версия функции COUNT() используется редко, потому что NULL-строки не должны быть проблемой в базах данных. Они могут создать проблемы только в том случае, если таблица не имеет первичного ключа. В большинстве случаев COUNT(*) будет работать просто отлично.
COUNT(expr) может принимать правильные выражения. Еще один запрос, который одинаково извлекает NULL и не NULL строки:
Подсчет только NULL строк
Версия функции COUNT(expr) также принимает имена отдельных столбцов, в результате чего COUNT(имя_столбца) возвращает количество записей, в которых имя_столбца не является NULL. Следовательно, следующий запрос SELECT получит количество строк, в которых столбец description содержит не NULL-значения:
Подсчет уникальных значений
Функция COUNT(DISTINCT) возвращает количество строк с уникальными не-NULL значениями. Следовательно, включение ключевого слова DISTINCT исключает дубликаты строк из подсчета. Синтаксис функции следующий:
Как и в обычной функции COUNT(), параметры expr выше могут быть любыми выражениями, включая конкретные столбцы, все столбцы (*), возвращаемые значения функций или выражения, такие как операторы IF/CASE.
Пример. Допустим, у нас есть следующая таблица клиентов:
Вызов COUNT(*) вернет количество всех строк (4), а COUNT DISTINCT по last_name каждую строку где дублирующие last_name будут считаться за одну строку, так что в итоге мы получим 3:
Условные подсчеты с использованием выражений
Параметры функции COUNT() не ограничиваются именами столбцов; возвращаемые значения функций и выражения, такие как операторы IF/CASE, также будут работать.
Вот таблица, содержащая номера телефонов и пол нескольких пользователей:
Предположим, что мы хотим создать запрос, который сообщает нам, сколько разных женщин и мужчин содержится в таблице. Человек идентифицируется по номеру телефона («tel»). Один и тот же номер может встречаться несколько раз, но пол этого номера должен учитываться только один раз.
Вот один из вариантов использования отдельного COUNT DISTINCT для каждого столбца:
SQL COUNT()
In this tutorial, you will learn about the SQL COUNT() function with the help of examples.
The SQL COUNT() function returns the number of rows in the result set.
Example
Here, the above SQL command counts and returns the number of rows in the Orders table.
Count() Syntax
The syntax of the SQL COUNT() function is:
- COUNT is the function to count the number of rows in a table
- table is the name of the table whose number of rows is to be counted
Here, the above SQL command counts and returns the number of rows in the Customers table.
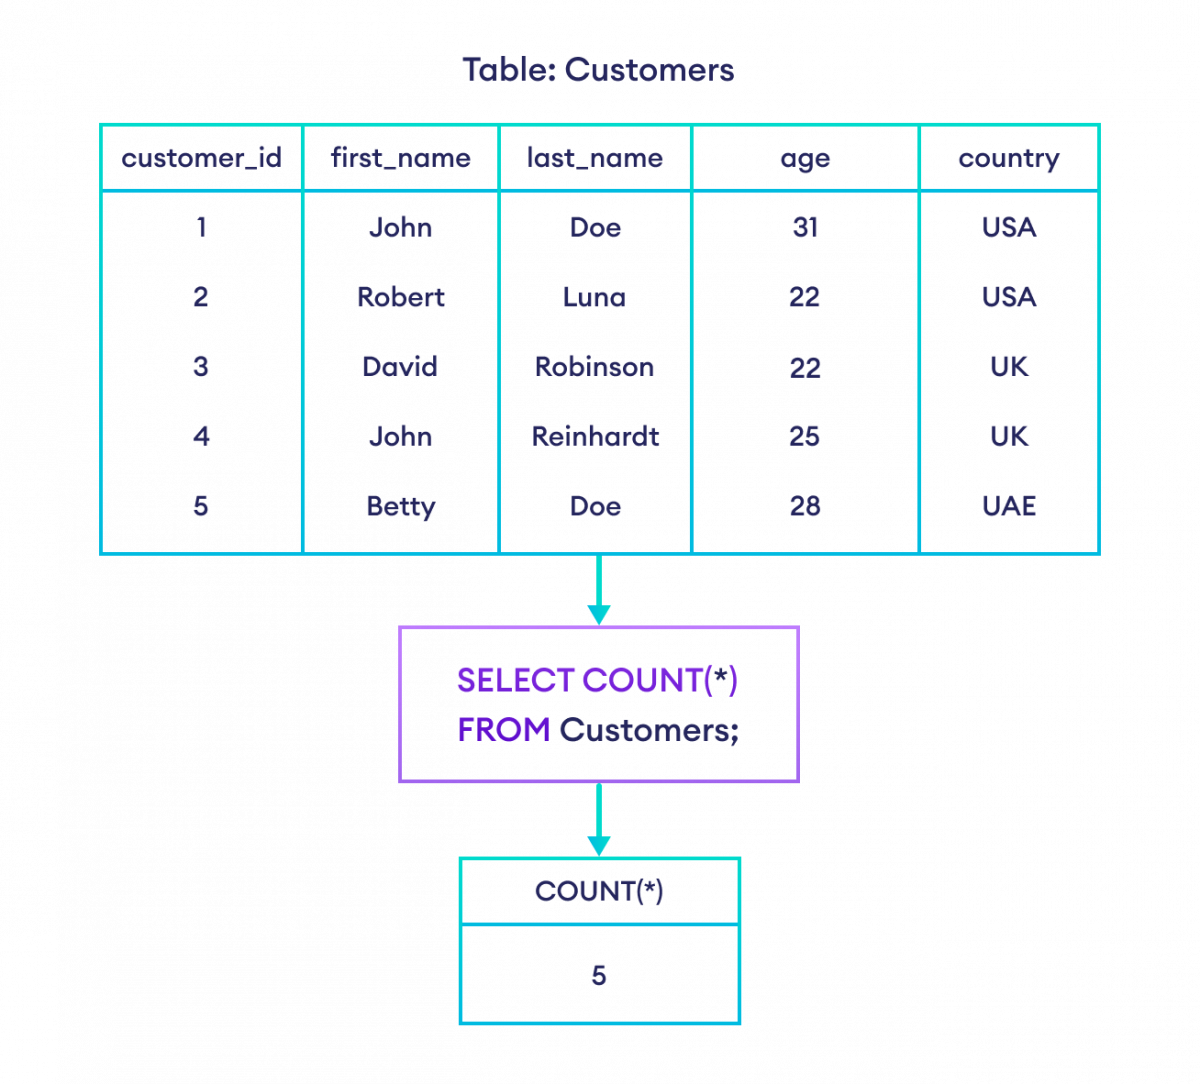
Example: SQL COUNT() Function
Aliases With COUNT()
In the above example, the field name in the result set is COUNT(*) .
It is also possible to give custom names to these fields using the AS keyword. For example,
Here, the field name COUNT(*) is replaced by total_customers in the result set.
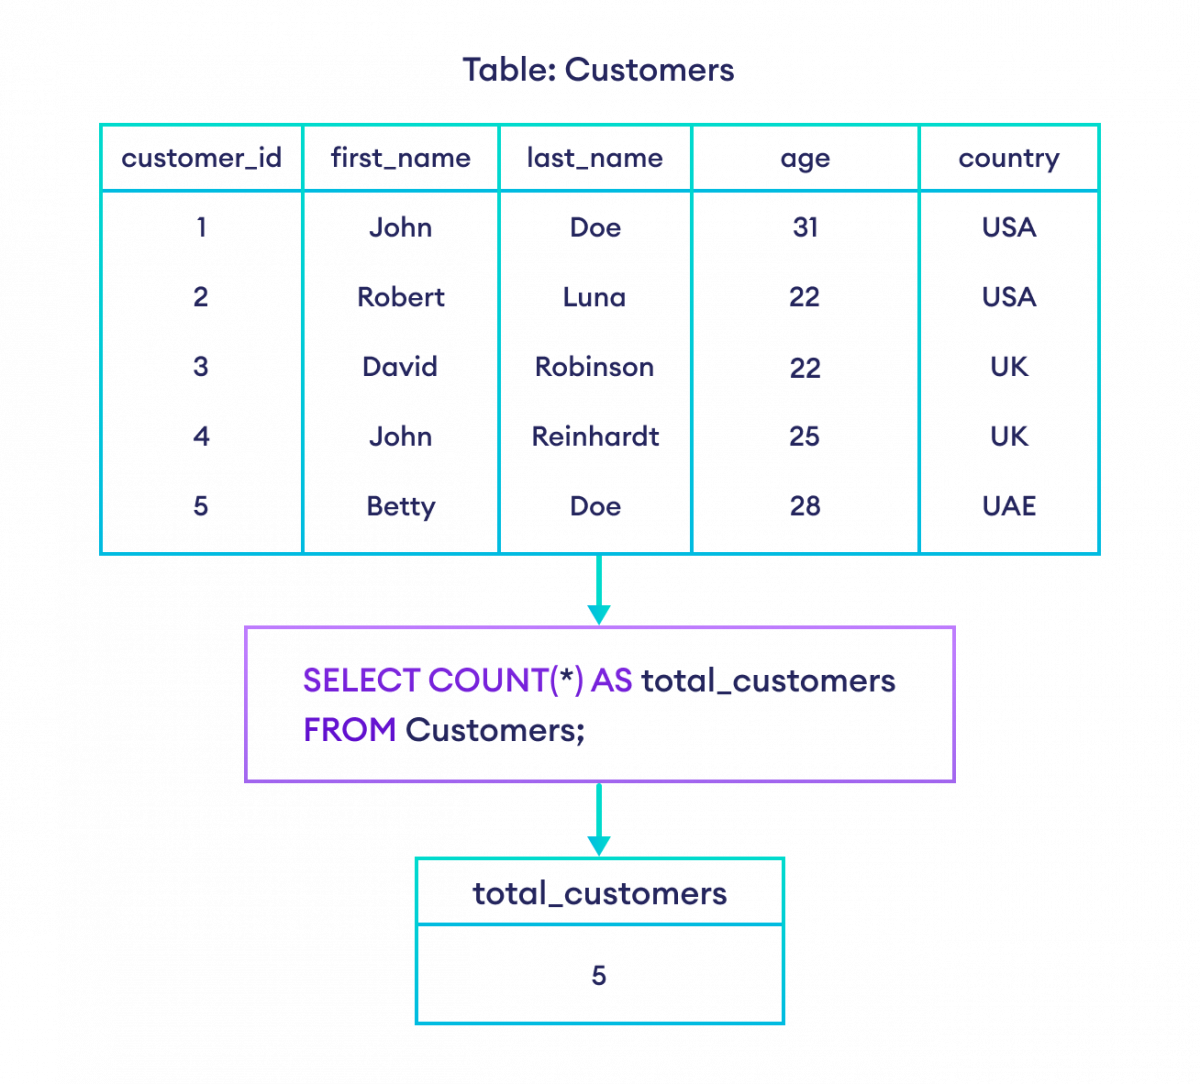
Example: COUNT() in SQL with Alias
COUNT() With WHERE
We can use COUNT() with WHERE to count rows that have certain column values:
Here, the SQL command returns the count of customers whose country is UK.
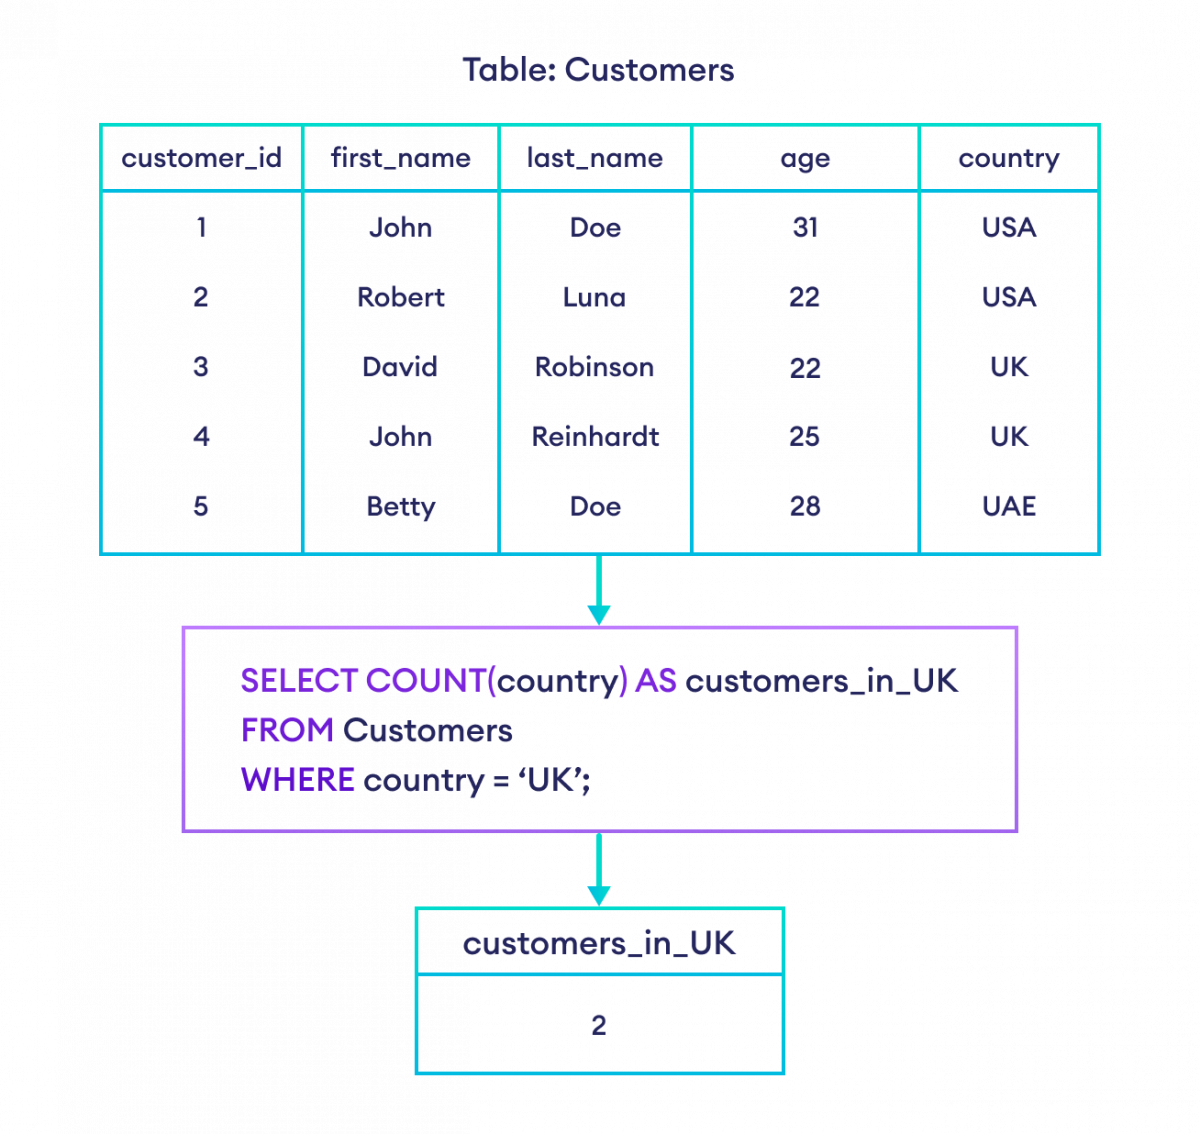
Example: SQL COUNT() Function with WHERE
COUNT() With DISTINCT
If we need to count the number of unique rows, we can use the COUNT() function with the DISTINCT clause. For example,
Here, the SQL command returns the count of unique countries.
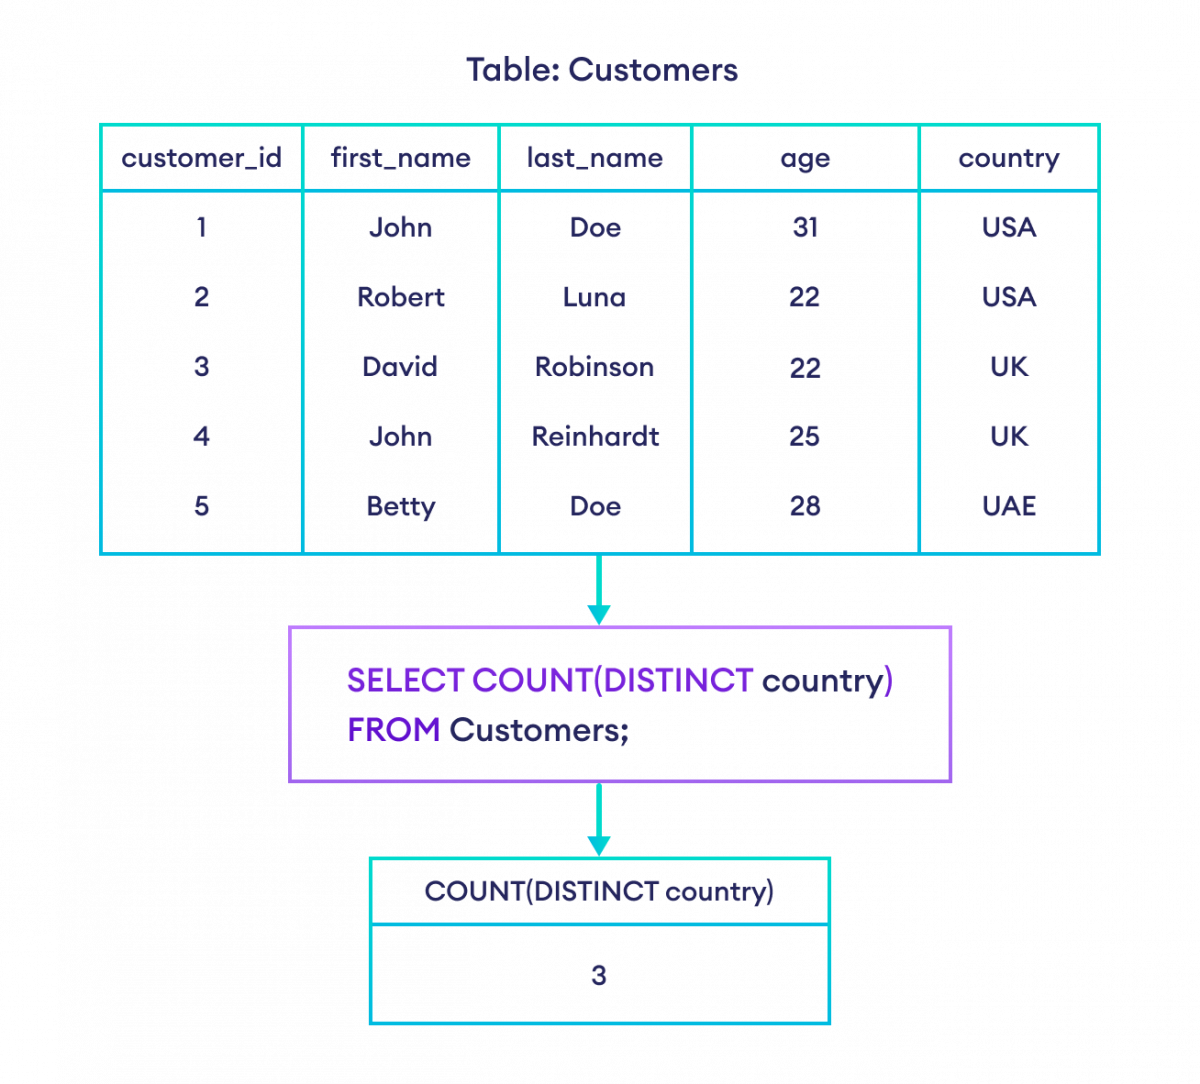
Example: Counting unique countries
COUNT() With GROUP BY
The COUNT() function can be used with the GROUP BY clause to count the rows with similar values. For example,
Here, the SQL command returns the number of customers in each country.
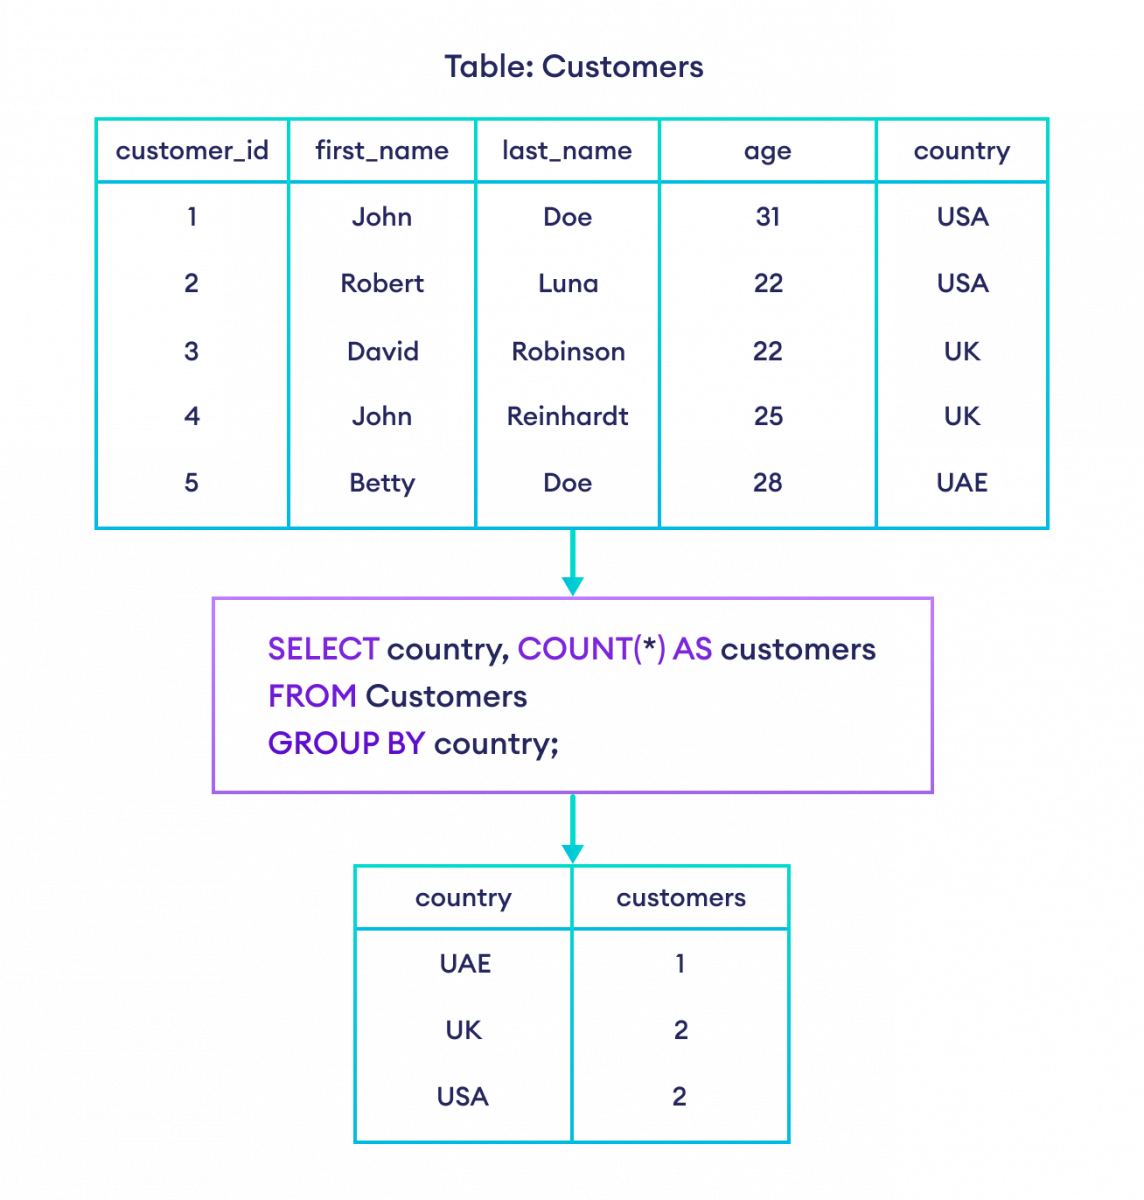
Example: SQL COUNT() Function with GROUP BY
Sql как узнать количество строк в таблице
Базы данных часто используются для получения ответа на вопросы типа: «как часто данные определенного типа встречаются в таблице?» Вам, например, может понадобиться узнать общее количество животных, или то, сколько животных имеется у каждого из владельцев, или провести статистические исследования на базе хранящейся информации.
Процедура подсчета количества животных в сущности идентична подсчету количества строк в таблице, так как на каждое животное приходится по одной записи. Функция COUNT() подсчитает количество непустых результатов, и с ее помощью можно составить следующий запрос для определения числа животных:
Ранее мы уже извлекали из таблицы имена владельцев животных. При помощи функции COUNT() можно узнать, сколько животных принадлежит каждому из владельцев:
Обратите внимание на использование команды GROUP BY для объединения всех записей по каждому из владельцев. Без этой команды запрос выдал бы только сообщение об ошибке:
Команды COUNT() и GROUP BY очень помогают характеризовать данные различными способами. В примерах, приведенных ниже, вы увидите и другие способы проведения статистических подсчетов.
Количество животных каждого вида:
Количество животных каждого пола:
(в этой таблице результатов NULL обозначает, что пол животного неизвестен)
Количество животных каждого вида с учетом пола:
При использовании функции COUNT() вовсе не обязательно загружать всю таблицу. Например, предыдущий запрос, в котором учитываются только кошки и собаки, выглядит следующим образом:
Можно узнать и количество животных каждого пола с учетом только тех экземпляров, пол которых известен:
How to count the number of rows in a table in SQL Server
It seems like such an innocent request. It isn’t too hard to get this information out of SQL Server. But before you open SSMS and whip out a quick query, understand that there are multiple methods to get this information out of SQL Server – and none of them are perfect!
COUNT(*) or COUNT(1)
The seemingly obvious way to get the count of rows from the table is to use the COUNT function. There are two common ways to do this – COUNT(*) and COUNT(1). Let’s look at COUNT(*) first.
The STATISTICS IO output of this query shows that SQL Server is doing a lot of work! Over 100,000 logical reads, physical reads, and even read-ahead reads need to be done to satisfy this query.
Looking at the execution plan, we can see an Index Scan returning over 31 million rows. This means that SQL Server is reading every row in the index, then aggregating and counting the value – finally ending up with our result set. The cost of this query? 123.910000.

The query results: 31,263,601 rows.

Now, let’s look at the behavior of COUNT(1).
We can see from STATISTICS IO that we have a large number of logical reads – over 100,000.
The execution plan again shows an index scan returning over 31 million rows for processing. The query cost is the same, 123.910000.

The results here are the same – 31,263,601 rows.

The benefit of using COUNT is that it is an accurate indicator of exactly how many rows exist in the table at the time query processing begins. However, as the table is scanned, locks are being held. This means that other queries that need to access this table have to wait in line. This might be acceptable on an occasional basis, but I frequently see applications issuing these types of queries hundreds or thousands of times per minute.
sys.tables + sys.indexes + sys.partitions
We can join several SQL Server catalog views to count the rows in a table or index, also. sys.tables will return objects that are user-defined tables; sys.indexes returns a row for each index of the table; and sys.partitions returns a row for each partition in the table or index. I am going to query for the table ID, name, and count of rows in all partitions.
The output of STATISTICS IO here shows far fewer reads – 15 logical reads total.
The execution plan is more complex, but much less work – the query cost here is 0.0341384.

The results of the query are also the same – 31,263,301.

The benefits of using this method are that the query is much more efficient, and it doesn’t lock the table you need the count of rows for.
However, you need to be cautious when counting the rows on a table that is frequently inserted into or deleted from. The TechNet documentation for sys.partitions.rows says it indicates the “approximate number of rows for this partition”. How approximate? That information isn’t documented. Understand, though, that if you use this method, you potentially sacrifice up-to-the-moment accuracy for performance.
sys.dm_db_partition_stats
A third option is to use the dynamic management view sys.dm_db_partition_stats. This returns one row per partition for an index.
The STATISTICS IO output of this query is even lower – this time, only two logical reads are performed.
The execution plan is less complex than our second example involving the three system views. This query also has a lower cost – 0.0146517.

The query results are the same as the previous examples – 31,263,301 rows.

Using this DMV has the same benefits as the system views – fewer logical reads and no locking of the target table. The query is also simpler to write, involving only one object.
But again, the TechNet documentation for sys.dm_db_partition_stats.row_count says it is “the approximate number of rows in the partition”, and when this information is updated is not documented. Here, you are also potentially sacrificing accuracy for performance.
Time to do some digging
The questions that you need to work with the business to answer are, “How up-to-date must the row count be? What is the business purpose? How often do you insert into or delete from that table, and how often do you count the rows?” If the accuracy of the row count is crucial, work to reduce the amount of updates done to the table. If performance is more important, and the row count could be approximate, use one of the system views.
Wanna learn more tricks for free?
Check out our free T-SQL Level Up online class – we guarantee it’s the best T-SQL training trailer you’ve ever seen: