Перевод: Как MS SQL Server выполняет запросы. Часть 3
Завершающая часть перевода – здесь будут разобраны блокировки, процесс записи изменённых данных, а также дополнительные команды SQL Server.
Предыдущие части перевода:
«латчи» (Latches): защита конкурентного доступа к страницам.
Перед тем, как разбираться с механизмом записи данных, важно изучить механизм, призванный гарантировать, что с диска всегда будут считаны корректные данные. В многопоточной среде всегда важно следить за тем, чтобы «читатели» не могли увидеть данные из незавершённой транзакции записи. Всем программистам знакомы примитивы, реализующие такие проверки: мютексы, семафоры, критические секции. В терминах баз данных устоялся термин «латч» («защёлка», latch). Латчи – это структуры, которые контролируют конкурентный доступ к ресурсам. Например, каждая страница в Buffer pool должна иметь латч для контроля доступа и поддержания консистентности данных.
Латчи поддерживают несколько видов доступа: разделённый (shared), эксклюзивный (exclusive), доступ для обновления (update), удерживающий доступ (keep) и доступ для удаления (destroy). Ниже приведена таблица совместимости видов доступа.
KP
SH
UP
EX
DT
KP
SH
UP
EX
DT
Когда оператору доступа к данным требуется получить доступ к странице (например, чтобы сравнить значения ключей или чтобы прочитать строку), он должен получить латч в SH-режиме. Несколько операторов могут прочитать одну и ту же страницу одновременно, поскольку все они могут обратиться к странице в SH-режиме, не блокируя друг друга.
Любой оператор, которому потребуется изменить содержимое страницы, должен получить EX-латч. В каждый момент времени только один оператор может менять содержимое страницы – и ни один оператор не может прочитать её содержимое, пока изменение не будет завершено.
Эти два типа латчей будут отражены в статистике ожиданий как PAGELATCH_SH и PAGELATCH_EX. В статье Diagnosing and Resolving Latch Contention on SQL Server разобрано больше деталей этого механизма, в том числе:
как латчи защищают обращения ввода-вывода (в результате страница считывается с диска только один раз, даже не смотря на то, что нескольким потокам может потребоваться считать её с диска одновременно)
а также как в многопроцессорных системах суперлатчи (superlatches) используются для защиты от порчи процессорного кэша.
Важно не путать защиту физических ресурсов, которой занимаются латчи, с логической защитой, которой занимаются блокировки (locks). Клиент может управлять блокировками (например, с помощью выбора уровня изоляции транзакций), в то время, как латчи будут накладываться в любом случае.
Блокировки.
В то время, как латчи реализуют физическую защиту конкурентного доступа между потоками, блокировки отвечают за логическую защиту доступа между транзакциями:
Логическая и физическая защита:
Блокировки описывают заблокированную сущность, но сами они не являются сущностью. Это всего лишь 6-байтовая строка, которая описывает, что именно было заблокировано. Латчи – это самые настоящие объекты в памяти, которые могут быть заблокированы. Для того, чтобы получить, «захватить», латч, выполняемый код должен каким-то образом получить ссылку (указатель, адрес) на нужный объект латча. А для того, чтобы выполнить блокировку, коду достаточно сконструировать 6-байтовую строку, описывающую блокируемый объект, и затем запросить блокировку у менеджера блокировок.
Потоки и транзакции:
Латчи захватываются и освобождаются потоками (thread), существующими в рамках процесса. Блокировки захватываются и освобождаются транзакциями. Это важное отличие, поскольку транзакция может состоять из нескольких запросов, кроме того, транзакция может выполняться в контексте разных потоков (thread): либо одновременных, если мы говорим о параллельном выполнении, либо последовательных, если каждый из последовательных запросов транзакции был «подхвачен» разными рабочими потоками (workers)
Блокировки организованы более сложно, чем латчи. Не в последнюю очередь потому, что существует 22 типа блокировок, описанных в статье на Microsoft Docs. Добавьте сюда загадочные названия, наподобие SCH-S, SIX или RX-U – и станет понятно, почему тема блокировок кажется такой сложной. Попробуем немного прояснить, что именно означают эти множества видов блокировок.
Стабильность схемы (Schema Stability)
Во время выполнения плана запроса СУБД ожидает, что объекты, на которые ссылается план (т.е. таблицы, представления и т.п.) не будут менять свою структуру и не будут удалены кем-нибудь. Для того, чтобы гарантировать, что такие изменения не случатся, каждый запрос ещё до начала выполнения накладывает упреждающие блокировки «стабильности схемы» на все объекты, упоминаемые в плане. Это и есть SCH-S— блокировки.
DDL-команды (то есть, команды, изменяющие метаданные) будут накладывать блокировку модификации схемы: SCH-M. Это самая мощная блокировка (т.е. с максимальными ограничениями и с минимальной совместимостью). Эта блокировка гарантирует, что ни одна другая сессия не сможет даже ссылаться на изменяемый объект.
На практике большинство запросов не накладывает SCH-S блокировку, вместо этого используются аналоги – блокировки намерения (см. ниже, например *_IS)
Разделяемые блокировки, блокировки обновления и эксклюзивные блокировки (Shared, Update, Exclusive)
Это базовые режимы блокировок: S (shared, разделяемая), U (update, обновления) и X (eXclusive, исключительная). S- и X-блокировки самоочевидны. U-блокировка накладывается на данные, которые могут быть позже изменены или удалены (соответственно, при этом блокировка будет обновлена до X).
Наложение U-блокировки не блокирует другие чтения (S-блокировки), но не позволяет наложить U-блокировку из другой сессии. Если бы U-блокировок не было, две сессии могли бы попасть в дедлок в тот момент, когда пробовали бы одновременно обновить S-блокировку до X-блокировки. С другой стороны, если бы оператор UPDATE сразу накладывал X-блокировку на все считываемые записи, даже на те, которые потом не придётся изменять – мы бы получили избыточные блокировки других читающих сессий.
Иерархия блокировок и блокировки намерения.
Все блокировки, в названии которых есть буква I – это блокировки намерения (intent). Для того, чтобы понять их назначение, необходимо разобраться в иерархии блокировок.
Предположим, у нас есть запрос, который собирается просканировать всю таблицу, содержащую несколько миллионов строк. Если бы этот запрос накладывал блокировки на каждую из считываемых строк, пришлось бы выполнить несколько миллионов обращений за блокировками – а это довольно расточительно с точки зрения потребляемых ресурсов. Да, наложение блокировки – это быстро, но даже «быстро» суммируется в заметное время, если повторить это миллион раз. Поэтому запрос решает «сэкономить» и вместо блокировки отдельных строк накладывает всего одну S-блокировку, но сразу на объект таблицы.
Другой запрос, работающий параллельно, хочет удалить одну строку из таблицы – поэтому он запрашивает X-блокировку на эту строку. И вот тут возникает проблема: каким образом менеджер блокировок должен понять, что нельзя предоставлять X-блокировку на строку, т.к. другая сессия уже запросила S-блокировку на всю таблицу? Мы ведь помним, что блокировки – это просто строки, которые описывают, что было заблокировано. И по содержимому этих строк менеджер блокировок никак не может узнать, что строка, запрашиваемая для X-блокировки принадлежит таблице, на которую наложена S-блокировка. Строки, описывающие эти блокировки, описывают объекты на разных уровнях иерархии.
Тут и пригождаются блокировки намерения. Начнём с того, что операторы доступа к данным, которые запрашивают блокировки, знают иерархию блокируемых элементов. Тот же оператор изменения знает, что изменяемая строка принадлежит определённой таблице. Поэтому в обязанности оператора доступа к данным входит запрос блокировки намерения к родительскому объекту (или объектам) в иерархии. Получается, оператор изменения сначала запросит IX-блокировку на объект таблицы. Такая блокировка будет означать буквально следующее: «я не буду блокировать всю таблицу, но где-то внутри неё могут быть строки, на которые я наложу X-блокировку». IX-блокировка несовместима с S-блокировкой, которую наложила первая сессия. Проблема решена: «скрытый» конфликт блокировок становится явным, соответственно, одна сессия блокирует другую, пока не выполнит все свои действия. И теперь когда вы увидите, например, «SIX-блокировку», вы поймёте, что это означает: «Я выполнил S-блокировку на объект таблицы, но вместе с тем я могу заблокировать какие-то отдельные строки в X-режиме»
Блокировки диапазонов ключей (Key-range locks)
Режимы блокировок, содержащие в названии R – это блокировки диапазонов (range). Такие блокировки защищают строки, которые ещё не существуют. SQL Server использует блокировки диапазонов чтобы реализовать последовательный (SERIALIZABLE) уровень изоляции транзакций. Дело в том, что уровень SERIALIZABLE требует, чтобы два вызова одного и того же запроса в транзакции возвращали одинаковый результат: никаких новых или потерянных строк. Получается, нужно контролировать не только считанные строки, но и интервалы между ними – чтобы никакой INSERT не смог «протащить» новые строки в диапазон, уже считанный в нашей транзакции. Именно для этого и применяются блокировки диапазона. Больше подробностей о таких блокировках — в статье Key-Range Locking
Запись данных
Операторы изменения данных на самом деле во многом схожи с операторами чтения, разобранными нами ранее. Каждый раз, когда у такого оператора вызывают метод next(), он должен найти нужную строку (или, для INSERT, найти позицию для вставки новой строки) – и затем выполнить необходимые изменения. Когда next() вызовут в следующий раз – выполнить модификацию следующей строки. И так далее.
Операторы удаления (delete) и изменения (update) обычно управляются другими операторами чтения, которые находят нужные строки и передают оператору изменения указатели на конкретную строку.
Сами по себе операции вставки, удаления или изменения строк несколько более сложны, чем операции чтения. Это связано с тем, что SQL Server использует упреждающее логирование изменений (Write Ahead Logging). Любая операция модификации данных должна быть в первую очередь записана в лог транзакций.
Грубо говоря, все изменения происходят в следующей последовательности:
Оператор изменения «позиционируется» на странице, которую он должен изменить (то есть, строка должна быть добавлена, удалена или изменена именно на этой странице). Для этого нужная страница должна оказаться в Buffer pool.
Оператор изменения получает эксклюзивный латч на изменяемую страницу. Это означает, что ни один другой оператор не сможет считать изменяемую страницу.
Оператор изменения добавляет в лог транзакций запись, в точности описывающую, что и как оператор собирается изменить на странице.
После этого оператор может изменить страницу в памяти (Buffer pool). Страница на диске в этот момент не меняется!
В момент создания записи в логе транзакций оператор получает LSN (Log sequence number) – номер операции внутри лога транзакций. Этот LSN записывается в заголовок изменяемой страницы в поле «LSN последнего изменения» (last modified LSN)
В момент создания записи в логе транзакций оператор получает LSN (Log sequence number) – номер операции внутри лога транзакций. Этот LSN записывается в заголовок изменяемой страницы в поле «LSN последнего изменения» (last modified LSN)
Снимается эксклюзивный латч на страницу. Теперь страница может быть прочитана другими транзакциями (например, в режиме Read Uncommitted). Важно понимать, что до сих пор ни одного байта не было записано на диск – все изменения происходили в памяти.
Перед тем, как изменяющая транзакция будет завершена, она должна создать новую запись лога, фиксирующую факт, что транзакция зафиксирована (committed). Эта запись добавляется в лог транзакций и после этого она и все предшествующие записи лога (в рамках транзакции) должны быть записаны на диск – в файл лога транзакций. Изменяемая страница в этот момент всё еще не записана на диск, её изменения остаются только в памяти. Но сама транзакция с этого момента становится надёжной (durable): даже если служба SQL Server упадёт, информация об изменениях на странице хранятся в логе транзакций, процесс запуска БД прочитает её и повторит нужные действия
Периодически (но не сразу по окончании транзакции) изменения в страницах записываются на диск, в файл данных. Эта операция называется CHECKPOINT.
Кроме того, есть отдельный вид операции записи, который работает по другому алгоритму: операции с минимальным логированием. Так могут работать только операции, вставляющие новые данные: INSERT или синтаксис .WRITE(@value, NULL) оператора UPDATE (и то, только в случае добавления BLOB-полей). Для того, чтобы транзакция могла использовать минимальное логирование, она должна отвечать дополнительным условиям, см. «Operations that can be minimally logged» и «Data loading performance guide».
Последовательность операций при записи с минимальным логированием будет примерно следующей:
Оператор, выполняющий операцию вставки, выделяет место под новую страницу. Для понимания процесса выделения места под страницы можно изучить статью Managing Extent Allocations and Free Space
Оператор помещает страницу в Buffer pool и получает эксклюзивный латч на неё.
Создаётся запись лога транзакций, фиксирующая, что новая страница используется для операции вставки с минимальным логированием. Эта запись добавляется в лог (в памяти), а LSN записи помещается в заголовок новой страницы как LSN последнего изменения.
Страница добавляется в список страниц с минимальным логированием, связанных с текущей транзакцией.
Теперь оператор может добавить на страницу столько строк, сколько поместится. Ему не требуется создавать записи лога для каждой добавляемой записи. В этот момент изменяется только образ новой страницы в памяти, на диск пока ничего не пишется.
Когда страница заполняется, выделяется новая страница – и описанные выше шаги повторяются.
Перед тем как транзакция с минимальным логированием будет зафиксирована, все страницы, изменённые с минимальным логированием, должны быть записаны на диск. Только после того, как все эти страницы будут записаны, создаётся новая запись лога, подтверждающая, что транзакция зафиксирована. И после этого все записи лога, описывающие транзакцию, должны быть записаны на диск, в файл лога.
Для того, чтобы массовая запись страниц на диск не положила дисковую подсистему специальный фоновый процесс «жадной записи» переносит их на диск ещё до завершения транзакции.
Операции с минимальным легированием остаются полностью транзакционными, целостными и надёжными. В любой момент выполнения такая операция может быть отменена (откачена, rolled back). Сервер СУБД может даже завершиться крэшем во время выполнения такой операции – и всё равно база останется в целостном состоянии (после завершения recovery, восстановления во время запуска)
Точно так же, как и обычные операции, операции с минимальным логированием детально описаны в статье SQL Server 2000 I/O Basics.
Не все T-SQL-выражения выполняются как последовательный перебор операторов из плана выполнения. Типичный пример такого исключения – DDL-команды (например, CREATE TABLE).
Для понимания того, как работают DDL-команды важно знать, что SQL Server сохраняет все метаданные о существующих объектах в специальных служебных таблицах. Получается, что вставка новой строки в, скажем, таблицу, хранящую список пользовательских таблиц, приведёт к тому, что SQL Server узнает о существовании новой таблицы. Вставка строки в таблицу, хранящую сведения о колонках таблиц, приведёт к появлению новой колонки у нашей новой таблицы. Выполнение команды DROP приведёт к удалению строк из соответствующих системных таблиц. Все объекты, с которыми работает SQL Server, описаны в таких системных таблицах. Более 80 таких таблиц содержат сведения о таблицах, колонках, индексах, схемах, процедурах, представлениях и т.д. – то есть, буквально, о каждом аспекте SQL Server. Получается, что всё, что требуется от DDL-команд – это поддерживать актуальность таких системных таблиц. CREATE TABLE нужно добавить строку в таблицу, описывающую пользовательские объекты (ведь таблица – это не единственный возможный вид объекта) и несколько строк в таблицы, описывающие колонки – вуаля, новая таблица готова! (Помните, что здесь я сильно упрощаю весь процесс).
Несмотря на то, что DDL-команды не используют операторы доступа или изменения данных, которые мы рассмотрели ранее, внутри DDL-команд используется точно такой же код, который находит и изменяет нужные строки в таблицах. Когда DDL-команда выполняется, она не будет вызывать метод next() у оператора поиска — вместо этого она использует точно такой же код, что и у оператора Seek, чтобы найти нужную строку в системной таблице.
Большинство DDL-команд выполняют свою полезную работу просто добавляя, удаляя или изменяя записи в системных таблицах. Но есть отдельные операторы, которые не только работают с системными таблицами, но и, например, обращаются к файловой системе, чтобы выделить место для новой базы данных. Или обращаются к API кластеризации Windows чтобы настроить группу доступности AlwaysOn. И отдельные команды могут обращаться к самим пользовательским таблицам чтобы установить значения по умолчанию или проверить, отвечают ли существующие значения новым ограничениям (check constraint)
BACKUP, RESTORE и DBCC
После того, как мы рассмотрели основные группы операторов – DDL и DML – осталось несколько специальных команд.
BACKUP и RESTORE в своей работе не учитывают практически ничего из того, что мы обсуждали в этой статье. Если смотреть с высоты птичьего полёта, всё, что они делают – просто копируют данные из одних файлов в другие. BACKUP читает данные из файлов данных и логов транзакций и записывает их в файл бэкапа, RESTORE – ровно наоборот. В своей работе эти команды обращаются и к некоторым системным таблицам, но большую часть времени они просто копируют данные из одного файла в другой. Важно, что это копирование происходит без участия Buffer Pool – то есть, бэкап не сможет выдавить из кэша накопленные данные.
(прим. переводчика: на самом деле RESTORE – это не только ценный мех копирование данных; RESTORE запускает процесс восстановления (recovery) базы данных, о котором тоже есть что рассказать. К счастью, всё уже подробно описано в Microsoft Docs – рекомендую изучить эту статью чтобы понимать, из чего складывается время запуска базы данных).
Что же до команд DBCC – каждая из них работает по-своему и выполняет разные задачи. Для примера можно изучить описание работы DBCC CHECKDB в цикле статей CHECKDB from every angle.
Как я могу использовать эту информацию?
У разработчиков, взаимодействующих с базами данных, обычно две главных проблемы: производительность запросов и сохранность данных в случае сбоя. Эта статья никак не поможет со второй проблемой – если у вас нет бэкапа, ничто вас не спасёт. Но, я надеюсь, что понимание того, как работает SQL Server прольёт свет на проблемы производительности.
Как только вы поймёте, что клиент отправляет запрос к СУБД и на каждый запрос создаётся своя задача, весь гордиев узел проблем производительности сильно упростится: в любой момент ваша задача либо выполняется (то есть, использует процессорное время), либо ждёт. И каждый раз, когда задача чего-то ждёт, информация об этом ожидании (чего именно ждали и как долго) попадает во внутреннюю статистику ожиданий, собираемую SQL Server. Есть отличная методичка о том, как использовать эту статистику ожиданий для расследования проблем производительности: Waits and Queries. Если из всех упомянутых ссылок из этой статьи вы откроете только одну – я бы хотел, чтобы это была ссылка на эту методичку.
All about Latches in SQL Server
SQL Server locks, discussed in the article All about locking in SQL Server, which is applied on data for the duration of the logical operation to preserve logical transaction consistency. SQL Server latches, however, are a special type of low-level system locks which are held as long as the physical operation lasts on the memory page in order to protect memory consistency
SQL Server latches are an internal SQL Server mechanism that serves to protect shared memory resources, like pages and memory data structures inside the buffer pool, in order to coordinate access to those resources and protect them from corruption. Designed as an internal SQL Server mechanism that is not exposed outside the SQL Server Operating System (SQLOS), latches can be managed only by SQL Server, itself, and not by users (unlike locks that can be managed via NO LOCK hints). Every time SQL Server has to read memory, it will impose latches to the page or internal memory structure that cannot be accessed in a proper multi-threaded way. In this way, SQL Server establishes latches as a resource for the coordination of multiple physical thread execution in a SQL Server database
In the same manner as locks, SQL Server latches can come in various modes:
- Destroy Latch (DT): the most restrictive latch mode, acquired when a latch is destroyed and a buffer is to be removed from the cache. DT latches block even the KP latch
- Exclusive Latch (EX): acquires exclusive control of a page being written. Prevents all other latches to be acquired on the page where EX latch exists
- Update Latch (UP): restrictive similar to an exclusive latch, with an exception that it allows read operation to access the page, but restricts, explicitly, any write operation
- Keep Latch (KP): it serves to preserve a latch order record but also to ensure that it stays in the buffer when a new latch is being placed on it
- Shared Latch (SH): acquired on a page when a read request issued to a page is granted
Similarly to locks, there is a compatibility or incompatibility component between the various latch modes. The table below gives an insight in compatibility between the various SQL Server latches
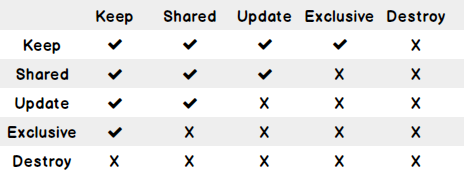
There are many different types of SQL Server latches, but essentially they can be split into three general categories: I/O latches, buffer latches, and non-buffer latches.
I/O latches
I/O Latches are acquired in situations when an outstanding I/O operation is executed over the pages stored in the buffer pool, or more precisely, when data has to be read from or written to physical storage. The SQL Server will use PAGEIOLATCH_XX wait types to report when a process is waiting for on a SQL Server I/O latch to be released
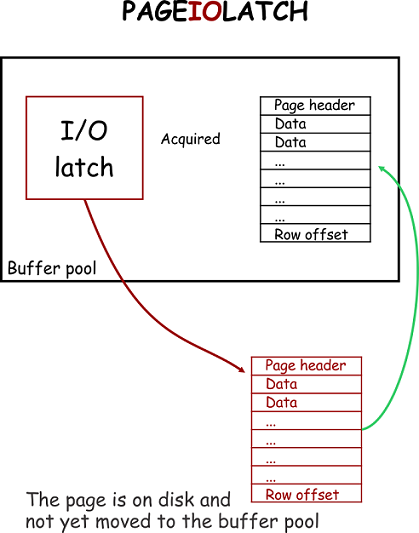
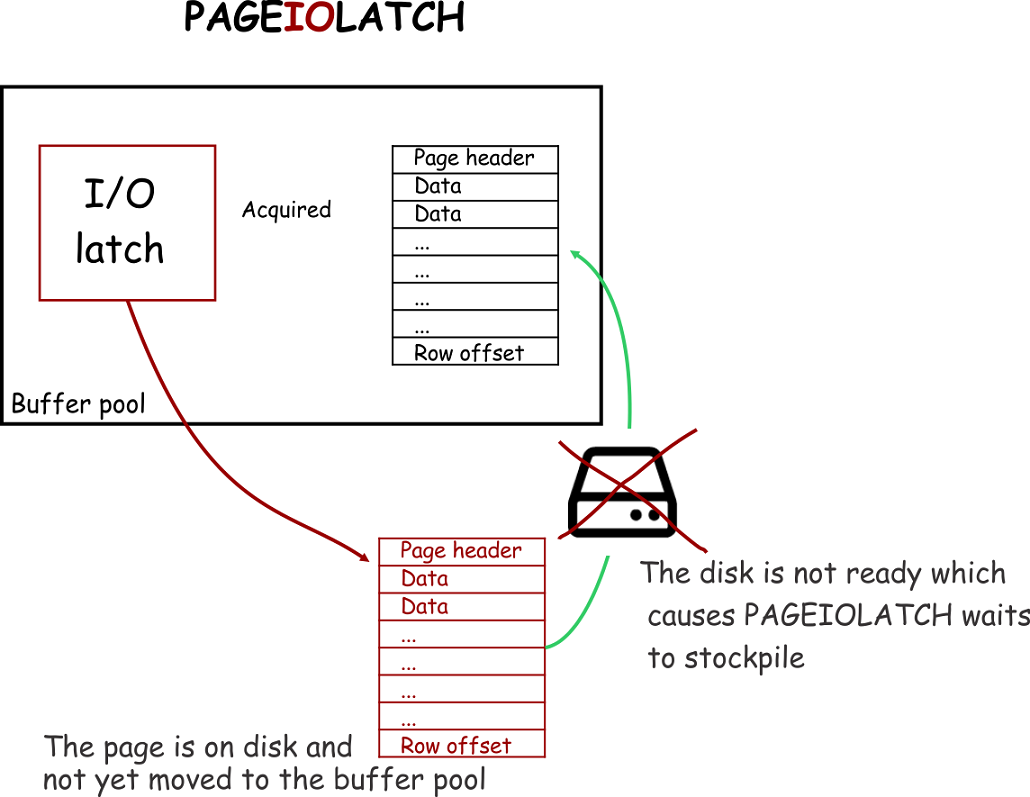
So, in situations when the page is requested to be brought from storage into a buffer pool, a PAGEIOLATCH will be acquired on that page, and if storage is not ready to be read the PAGEIOLATCH wait type count will increase
Buffer latches
In order to properly understand buffer latches, it is important to properly understand the idea behind the memory buffer pool, which is designed around the goal of maximizing SQL Server performance. The buffer pool is a physical memory range where data that is read from disk is stored in data pages. Data in SQL Server tables is stored in pages and each page has a fixed size of 8192 bytes (8 KB). Whenever a data page has to be read or written to, it will be first brought into a buffer pool. In that way, any further access to that page will be read directly from the memory buffer pool, thus improving SQL Server performance by minimizing disk IO.
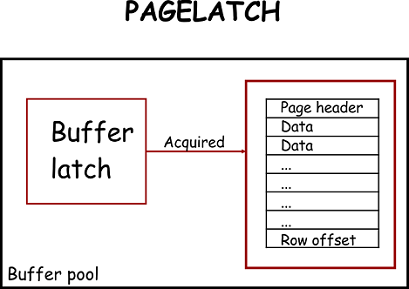
This implementation of the memory pool concept in SQL Server is what drives SQL Server physical memory usage can be high even in situations where there is no SQL Server activity. The loading of data in the buffer pool is based on the First-In First-Out (FIFO) principle.
SQL Server uses the buffer manager for managing the buffer pool and it is therefore in charge of any hash tables, the pool array that contain pages and for pages stored in the buffer. The SQLOS is accessing the data stored in the memory exclusively via the buffer manager
The pages that are modified in the buffer pool due to executed insert, delete or update command, are the so called “dirty” pages, while the unmodified pages are called “clean” pages. So when the page has to be accessed in memory, the SQL OS will acquire the buffer latch on that page. But unlike a lock, the SQL Server latch will not be held for the transaction duration but rather just during the critical period of a transaction, and it will be released as soon as it is no longer needed. SQL Server will use PAGELATCH_XX wait types to report when a process is waiting for on a SQL Server buffer latch to be released
Non-buffer latches
Non-buffer latches are designed to protect and guarantee any physical memory structure other than pages stored in the buffer pool. SQL Server will use LATCH_XX wait types to report when a process is waiting for on a SQL Server buffer latch to be released. Non-buffer latches are not often encountered during, and thus those are the least documented, but here are some use cases that can lead to SQL Server contention with non-buffer latches:
- Excessive parallelism – In a situation when a high level of parallelism is used on servers with 12+ logical processors, most if not all, queries can qualify to use parallel execution plans. In such a situation, non-buffered latches (LATCH_XX) will be acquired in memory to ensure the synchronization of internal memory structures used by parallel execution plans
- Too many auto-grow/auto-shrink operations – in systems with poor planning of database sizing or storage capacity (bad default database settings), auto-grow operations can be executed frequently. In addition, when auto-shrink is turned on, frequent database shrinking will occur. When growth and shrink operations are executed, SQL Server acquires FCB, FGCB_ADD_REMOVE and FGCB_ALLOC latches class to ensure the access to the file control block and to ensure synchronized access to information stored in the filegroup
- Very high frequency of DML operations on heap and BLOB data structures – In a situation where excessive DML operations are performed on heap and BLOB data, it is necessary to make sure to keep all internal memory structures in responsible for allocation and deallocation of pages to heap synchronized. In such situations, excessive LATCH_EX wait types can be encountered. When this occurs ALLOC_CREATE_FREESPACE_CACHE, ALLOC_FREESPACE_CACHE, ALLOC_EXTENT_CACHE wait types could be found as prevailing wait types via the sys.dm_os_latch_stats DMV
So, based on the previous, in situations when LATCH_XX wait type have excessive values or those are prevalent wait types, it is good to check which non-buffer latches are prevalent in the SQL Server using the following query
SuperLatches
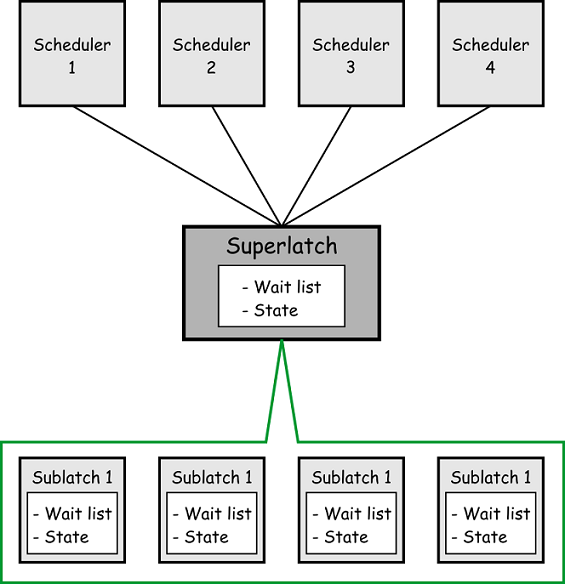
Starting with SQL Server 2005, superlatches (also called sublatches) were introduced to improve SQL Server efficiency in highly concurrent OLTP workloads for a certain pattern of usage (i.e. very high shared read only access to the page (SH) while write access is very low or not exists). Superlatches are used by SQL Server only in NUMA systems with 32+ logical processors. This mechanism is an efficient way of SQL Server to deal with a latch contention by dynamically promoting an array of latches to a Superlatch and thus allowing an SH mode request to the superlatch, while the containing sublatches can remain different modes. When this occurs, the superlatch becomes just a pointer to an array of SQL Server latches.
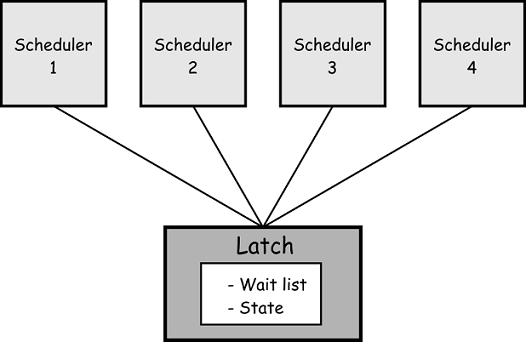
A Superlatch will behave as a single latch with sublatch structures and there can be one sublatch per partition per logical CPU core. So when a superlatch is created, the CPU worker thread will just have to acquire the shared (SH) sublatch that is assigned to the scheduler. This ensures that a shared (SH) superlatch uses less resources while at the same time access to pages is more efficient comparing to non-partitioned shared latches. The reason for this is that the superlatch do not require any synchronization of the global state as it will access only the local NUMA memory
Latch Contention
Latch contention is a frequent scenario for systems with large number of CPUs, and it is the consequence of situations when on the same in-memory structure, multiple threads are trying, concurrently, to acquire SQL Server latches that are not compatible with each other. Since SQL Server latches are controlled by an internal SQL Server mechanism, SQLOS will determine on its own when to use them. Due to the deterministic nature of SQL Server latches and their behavior, various parameters such as application design or database schema structure can significantly affect SQL Server latches
On high throughput systems which are designed for a large number of CPUs and thus, high-concurrency, active latch contention is expected as a regular occurrence of on memory structures are often accessed and protected using the latches. But the situation when latch contention and latch wait types wait time is large enough to decrease utilization of CPUs is what results in the reduced throughput
Recognizing and identifying the signs of latch contention is important, so let’s shed light on some symptoms of latch contention
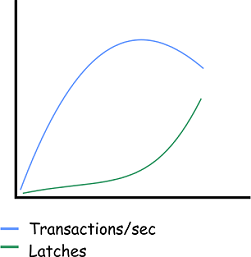
The expected behavior of SQL Server latches, in relation to the transactions per second, is that transactions per second will increase along with increasing average SQL Server latch waits, that themselves increase at a slow rate that will be within the margins of the throughput. Such a situation is represented in the image below and this is the desired system behavior which indicates that logical processors are not conflicting with each other. In such a scenario, adding more logical processors means that more can be done
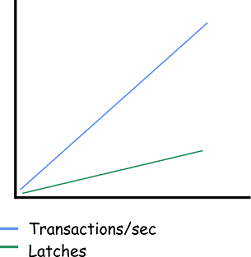
Situations when transactions/sec value is dropping when enabling additional logical processors while, at the same time, average SQL Server latch wait times are increasing at a greater rate than the system throughput, potentially indicate that there is a high probability that a problem with a latch contention may exist. The following image represents a typical situation where adding new logical processors worked until the certain point when longer latch wait times started to occur. This results in a situation where adding new logical processors will not have any benefits, up to a point where transactions/sec starts to negatively affect performance. This is ta typical situation where adding new logical processors actually had a negative, vs. a positive effect, as the resulting system environment will be spending a lot of time in a waiting state.
Latch contention that can affect the OLTP performance is mainly caused when high concurrency is the result of some of the following factors:
- Application design based on high concurrency – when a client application issues a high number of concurrent requests against the database
- SQL Server logical files layout – allocation structures such as Global Allocation Map (GAM), Shared Global Allocation Map (SGAM), Page Free Space (PFS) and Index Allocation Map (IAM) can impact page latch contention when many concurrent threads are in conflict
- Database schema design – read, write, delete data access patterns, index B+tree depth, design of clustered and non-clustered indexes, rows size and density per page
- The performance of I/O subsystems – is a quite frequent cause since, due to low I/O subsystem performance, SQL Server must wait for the data to be moved to a buffer pool. Excessive PAGEIOLATCH_XX wait type is indicative of the slow I/O subsystem
- Large number of logical CPUs assigned to SQL Server – Excessive latch contention that affects the performance of SQL Server to a level that is not acceptable is indicated in the system with more than 16 logical CPUs, and more logical CPUs are available the higher level of contention might be
Nikola is computer freak since 1981 and an SQL enthusiast with intention to became a freak. Specialized in SQL Server auditing, compliance and performance monitoring.
Military aviation devotee and hard core scale aircraft modeler. Extreme sports fan; parachutist and bungee jump instructor. Once serious, now just a free time photographer
Дополнительный материал 2: Приложение B. Параметры конфигурирования Microsoft SQL Server
Этот объект используется для просмотра статистики Cache Manager . Каждый из этих счетчиков может следить за следующими экземплярами данного объекта: Adhoc SQL Plans, Misc. Normalized Trees, Prepared SQL Plans, Procedure Plans, Replication Procedure Plans и Trigger Plans. Это следующие счетчики.
- Cache Hit Ratio . Соотношение между количеством попаданий и непопаданий в кэш. Этот счетчик очень полезен, если вы хотите определить, насколько эффективно используется кэш SQL Server для вашей системы. При низком значении этого счетчика вам, возможно, требуется дополнительная память.
- Cache Object Counts . Количество кэш-объектов в кэше.
- Cache Pages . Количество 8-килобайтных страниц, используемых объектами кэша.
- Cache Use Counts/sec . Количество использований в секунду каждого типа кэш-объектов.
Объект SQL Server: Databases
Этот объект содержит набор счетчиков, которые следят за каждой базой данных в системе. Выбранный экземпляр объекта представляет базу данных, за которой вы хотите следить. Вы можете следить за базами данных master, model, msdb и tempdb, а также за базой данных Northwind, pubs и всеми базами данных, которые создаются пользователями. Это следующие счетчики.
- Аctive Transactions . Количество активных транзакций в базе данных.
- Backup/Restore Throughput /sec . Производительность активных операций резервного копирования и восстановления в секунду.
- Bulk Copy Rows/sec . Текущее количество строк в секунду, копируемых с помощью операции массового копирования.
- Bulk Copy Throughput /sec . Текущее количество килобайтов в секунду, копируемых с помощью операции массового копирования.
- Data File (s) Size (KB) . Суммарный размер (в Кб) всех файлов данных в базе данных.
- DBCC Logical Scan Bytes/sec . Интенсивность логических операций чтения при сканировании для команд DBCC.
- Log Bytes Flushed/sec . Количество байтов журнала в секунду при сбросе на диск.
- Log Cache Hit Ratio .Процент операций чтения журнала, выполненных из кэша журнала.
- Log Cache Reads/sec . Количество операций чтения кэша журнала в секунду.
- Log File (s) Size (KB) . Суммарный размер файла или файлов журнала в килобайтах.
- Log File (s) Used Size (KB) . Текущий суммарный объем пространства, используемого в файле или файлах журнала.
- Log Flush Wait Time . Суммарное время ожидания для сбросов журнала на диск (в миллисекундах).
- Log Flush Waits/sec . Количество ожиданий в секунду для сбросов журнала на диск.
- Log Flushes/sec . Количество сбросов журнала на диск в секунду.
- Log Growths . Количество увеличений журнала, т.е. сколько раз происходило самостоятельное расширение журнала.
- Log Shrinks . Количество уплотнений журнала, т.е. сколько раз происходило самостоятельное уплотнение журнала.
- Log Truncations . Количество усечений журнала, выполненных для соответствующей базы данных.
- Percent Log Used . Процент используемой части журнала.
- Repl. Pending Xacts . Количество ожидающих транзакций репликации в базе данных.
- Repl. Trans. Rate . Количество транзакций репликации в секунду.
- Shrink Data Movement Bytes/sec . Скорость перемещения данных с помощью операции autoshrink или команды DBCC.
- Transactions/sec . Количество транзакций в секунду для базы данных. Этот счетчик показывает интенсивность операций в вашей системе. Чем выше это значение, тем больше операций происходит в системе.
Объект SQL Server: General Statistics
Счетчики этого объекта дают вам некоторую общую информацию о подсоединениях пользователей к SQL Server. Это следующие счетчики.
- Logins/sec . Количество входов по login-записям в секунду.
- Logouts /sec .Количество выходов в секунду.
- User Connections . Текущее количество подсоединенных пользователей. Этот счетчик полезно использовать, поскольку он указывает точное количество подсоединенных пользователей.
Объект SQL Server: Latches
Этот объект используется для показа статистики по защелкам. Защелки ( latches ) – это внутренние механизмы блокирования, используемые в SQL Server. Данный объект дает информацию по этим внутренним защелкам и содержит следующие счетчики.
Latch sql что это такое
A latch is in essence a “lightweight lock”. From a technical perspective, a latch is a lightweight, short-term synchronization object (for those who like technical jargon). A latch acts like a lock, in that its purpose is to prevent data from changing unexpectedly. For example, when a row of data is being moved from the buffer to the SQL Server storage engine, a latch is used by SQL Server during this move (which is very quick indeed) to prevent the data in the row from being changed during this very short time period. This not only applies to rows of data, but to index information as well, as it is retrieved by SQL Server.
Just like a lock, a latch can prevent SQL Server from accessing rows in a database, which can hurt performance. Because of this, you want to minimize latch time.
SQL Server provides three different ways to measure latch activity. They include:
- Average Latch Wait Time (ms): The wait time (in milliseconds) for latch requests that have to wait. Note here that this is a measurement for only those latches whose requests had to wait. In many cases, there is no wait. So keep in mind that this figure only applies for those latches that had to wait, not all latches.
- Latch Waits/sec: This is the number of latch requests that could not be granted immediately. In other words, these are the amount of latches, in a one second period, that had to wait. So these are the latches measured by Average Latch Wait Time (ms).
- Total Latch Wait Time (ms): This is the total latch wait time (in milliseconds) for latch requests in the last second. In essence, this is the two above numbers multiplied appropriately for the most recent second.
SQL Server, Latches Object
The SQLServer:Latches object in Microsoft SQL Server provides counters to monitor internal SQL Server resource locks called latches. Monitoring the latches to determine user activity and resource usage can help you to identify performance bottlenecks.
This table describes the SQL Server Latches counters.
| SQL Server Latches counters | Description | |
| Average Latch Wait Time (ms) | Average latch wait time (in milliseconds) for latch requests that had to wait. | |
| Latch Waits/sec | Number of latch requests that could not be granted immediately. | |
| Number of SuperLatches | Number of latches that are currently SuperLatches. | |
| SuperLatch Demotions/sec | Number of SuperLatches that have been demoted to regular latches in the last second. | |
| SuperLatch Promotions/sec | Number of latches that have been promoted to SuperLatches in the last second. | |
| Total Latch Wait Time (ms) | Total latch wait time (in milliseconds) for latch requests in the last second. | |
When reading these figures, be sure you have read the scale on Performance Monitor correctly. The scale can change from counter to counter, and this is can be confusing if you don’t compare apples to apples.
Based on my experience, the Average Latch Wait Time (ms) counter will remain fairly constant over time, while you may see huge fluctuations in the other two counters, depending on what SQL Server is doing.
Because each server is somewhat different, latch activity is different on each server. That is a good idea to get baseline numbers for each of these counters for your typical workload. This will allow you to compare “typical” latch activity against what is happening right now, letting you know if latch activity is higher or lower than “typical”.
If latch activity is higher than expected, this often indicates one of two potential problems. First, it may mean your SQL Server could use more memory. If latch activity is high, check to see what your buffer cache hit ratio is. If it is below 99%, your server could probably benefit from more RAM. If the hit ratio is above 99%, then it could be the I/O system that is contributing to the problem, and a faster I/O system might benefit your server’s performance.
If you really like to get your hands dirty, here are a couple of commands you might want to experiment with to learn more about latching behavior of your software.
SELECT * FROM SYSPROCESSES WHERE waittime>0 and spid>50
This query will display currently existing SPIDs that are waiting, along with the waittype, waittime, lastwaittype, and waitresource. The lastwaittype and waitresource tells you what your latch type, and the waitresource will tell you what object the SPID is waiting on. When you run it, you may not get any results because there are no waiting occuring at the time you ran the query. But if you run the query over and over, you will eventually get some results.
DBCC SQLPerf (waitstats, clear) –clears stats
DBCC SQLPerf (waitstats) –give you stats as of the last clear (or SQL Server service restart)
This query displays the current latches (among other stuff), along with their Wait Type and Wait Time. You may first want to clear the stats, then run DBCC SQLPerf (waitstats) periodically over a short time period to see what latches are taking the most time.
SQL Server performs faster and with less resources if it can retrieve data from the buffer cache instead of reading it from disk. In some cases, memory intensive operations can force data pages out of the cache before they ideally should be flushed out. This can occur if the buffer cache is not large enough and the memory intensive operation needs more buffer space to work with. When this happens, the data pages that were flushed out to make extra room must again be read from disk, hurting performance.
There are three different SQL Server counters that you can watch to help determine if your SQL Server is experiencing such a problem.
- SQL Server Buffer Mgr: Page Life Expectancy: This performance monitor counter tells you, on average, how long data pages are staying in the buffer. If this value gets below 300 seconds, this is a potential indication that your SQL Server could use more memory in order to boost performance.
- SQL Server Buffer Mgr: Lazy Writes/Sec: This counter tracks how many times a second that the Lazy Writer process is moving dirty pages from the buffer to disk in order to free up buffer space. Generally speaking, this should not be a high value, say more than 20 per second or so. Ideally, it should be close to zero. If it is zero, this indicates that your SQL Server’s buffer cache is plenty big and SQL Server doesn’t have to free up dirty pages, instead waiting for this to occur during regular checkpoints. If this value is high, then a need for more memory is indicated.
- SQL Server Buffer Mgr: Checkpoint Pages/Sec: When a checkpoint occurs, all dirty pages are written to disk. This is a normal procedure and will cause this counter to rise during the checkpoint process. What you don’t want to see is a high value for this counter over time. This can indicate that the checkpoint process is running more often than it should, which can use up valuable server resources. If this has a high figure (and this will vary from server to server), consider adding more RAM to reduce how often the checkpoint occurs, or consider increasing the “recovery interval” SQL Server configuration setting.
Question: What kind of latch does SQL Server use when reading a page from disk?
Answer: Anytime you talk about latching and database pages, think in terms of BUF (buffer) latches. So to read a page from disk and put this into cache, the worker thread will take out an EX (Exclusive) latch on the BUF associated with the page. Then the read is issues for the page. Then a SH latch is taken out by this same thread on this BUF structure. Since these are not compatible, the thread will wait. Makes sense since we need to wait for the page to be read in from disk before trying to look at it. Any other thread needing to read this page will also wait since you need a SH latch on a BUF to read the page in cache. When the read has completed, the EX latch is released, and now the SH latch is acquired and the thread(s) can read the page in cache.
When a thread has to wait on a BUF latch, the engine will look at the BUF structure to see if a special bit is turned on called BUF_IO. This is set when a page associated with the BUF is currently being read from or written to disk. This is how the engine knows that if your thread is waiting on a latch, that it is waiting on an “IO Latch”. The wait_type will therefore look something like PAGEIOLATCH_SH as opposed to PAGELATCH_SH.
Notice above, I said a SH latch is not compatible with an EX latch. Latches have compatibilities just like locks. Because I couldn’t find this documented anywhere, I published here a table that describes latch compatibility (Y=Compatible;N=Not Compatible)
| KP | SH | UP | EX | DT | |
| KP | Y | Y | Y | Y | N |
| SH | Y | Y | Y | N | N |
| UP | Y | Y | N | N | N |
| EX | Y | N | N | N | N |
| DT | N | N | N | N | N |
You can see from the table, that a SH and EX latch are not compatible. So what are UP, KP, and DT latches?. Well, I will answer that as you read on for the other questions I was asked.
Question: I have a question about latches and writing database pages to disk. The SQL Books Online in a section called Writing Pages says “Just before a page is written, the form of page protection specified in the database is added to the page. If torn page protection is added, the page must be latched EX(clusively) for the I/O. This is because the torn page protection modifies the page, making it unsuitable for any other thread to read. If checksum page protection is added, or the database uses no page protection, the page is latched with an UP(date) latch for the I/O. This latch prevents anyone else from modifying the page during the write, but still allows readers to use it.” Can you explain this further especially why you us an EX latch in one case and an UP latch in another?