SQL-Урок 13. Добавление данных (INSERT INTO)
В предыдущих разделах мы рассматривали работу по получению данных с заранее созданных таблиц. Теперь пора разобрать, каким же образом мы можем создавать/удалять таблицы, добавлять новые записи и удалять старые. Для этих целей в SQL существуют такие операторы, как: CREATE — создает таблицу, ALTER — изменяет структуру таблицы, DROP — удаляет таблицу или поле, INSERT — добавляет данные в таблицу. Начнем знакомство с данной группой операторов из оператора INSERT.
1. Добавление целых строк
- — добавить одну полную строку
- — добавить часть строки
- — добавить результаты запроса.
Итак, чтобы добавить новую строку в таблицу, нам необходимо указать название таблицы, перечислить названия колонок и указать значение для каждой колонки с помощью конструкции INSERT INTO название_таблицы (поле1, поле2 . ) VALUES (значение1, значение2 . ). Рассмотрим на примере.
INSERT INTO Sellers (ID, Address, City, Seller_name, Country) VALUES (‘6’, ‘1st Street’, ‘Los Angeles’, ‘Harry Monroe’, ‘USA’)
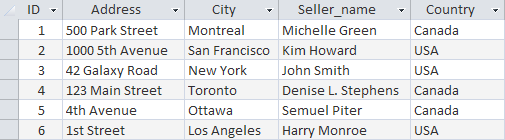
Также можно изменять порядок указания названий колонок, однако одновременно нужно менять и порядок значений в параметре VALUES.
2. Добавление части строк
В предыдущем примере при использовании оператора INSERT мы явно отмечали имена столбцов таблицы. Используя данный синтаксис, мы можем пропустить некоторые столбцы. Это значит, что вы вводите значение для одних столбцов но не предлагаете их для других. Например:
INSERT INTO Sellers (ID, City, Seller_name) VALUES (‘6’, ‘Los Angeles’, ‘Harry Monroe’)
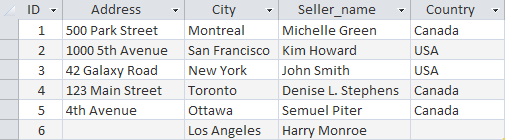
В данном примере мы не указали значение для двух столбцов Address и Country . Вы можете исключать некоторые столбцы из оператора INSERT INTO, если это позволяет производить определение таблицы. В этом случае должно соблюдаться одно из условий: этот столбец определен как допускающий значение NULL (отсутствие какого-либо значения) или в определение таблицы указанное значение по умолчанию. Это означает, что, если не указано никакое значение, будет использовано значение по умолчанию. Если вы пропускаете столбец таблицы, которая не допускает появления в своих строках значений NULL и не имеет значения, определенного для использования по умолчанию, СУБД выдаст сообщение об ошибке, и это строка не будет добавлена.
3. Добавление отобранных данных
В предыдущей примерах мы вставляли данные в таблицы, прописывая их вручную в запросе. Однако оператор INSERT INTO позволяет автоматизировать этот процесс, если мы хотим вставлять данные из другой таблицы. Для этого в SQL существует такая кострукция как INSERT INTO . SELECT . . Данная конструкция позволяет одновременно выбирать данные из одной таблицы, и вставить их в другую. Предположим мы имеем еще одну таблицу Sellers_EU с перечнем продавцов нашего товара в Европе и нам нужно их добавить в общую таблицу Sellers. Структура этих таблиц одинакова (то же количество колонок и те же их названия), однако другие данные. Для этого мы можем прописать следующий запрос:
INSERT INTO Sellers (ID, Address, City, Seller_name, Country) SELECT ID, Address, City, Seller_name, Country FROM Sellers_EU
Нужно обратить внимание, чтобы значение внутренних ключей не повторялись (поле ID), в противном случае произойдет ошибка. Оператор SELECT также может включать предложения WHERE для фильтрации данных. Также следует отметить, что СУБД не обращает внимания на названия колонок, которые содержатся в операторе SELECT, для нее важно только порядок их расположения. Поэтому данные в первом указанном столбце, что были выбраны из-за SELECT, будут в любом случае заполнены в первый столбец таблицы Sellers, указанной после оператора INSERT INTO, независимо от названия поля.
4. Копирование данных из одной таблицы в другую
Часто при работе с базами данных возникает необходимость в создании копий любых таблиц, с целью резервирования или модификации. Чтобы сделать полную копию таблицы в SQL предусмотрен отдельный оператор SELECT INTO. Например, нам нужно создать копию таблицы Sellers, нужно будет прописать запрос следующим образом:
Какой оператор sql используется для вставки новых данных в базу данных
Use the INSERT statement to add rows to a table, the base table of a view, a partition of a partitioned table or a subpartition of a composite-partitioned table, or an object table or the base table of an object view.
For you to insert rows into a table, the table must be in your own schema or you must have the INSERT object privilege on the table.
For you to insert rows into the base table of a view, the owner of the schema containing the view must have the INSERT object privilege on the base table. Also, if the view is in a schema other than your own, then you must have the INSERT object privilege on the view.
If you have the INSERT ANY TABLE system privilege, then you can also insert rows into any table or the base table of any view.
You must also have the READ or SELECT object privilege on the table into which you want to insert rows if the table is on a remote database.
Conventional and Direct-Path INSERT
You can use the INSERT statement to insert data into a table, partition, or view in two ways: conventional INSERT and direct-path INSERT . When you issue a conventional INSERT statement, Oracle Database reuses free space in the table into which you are inserting and maintains referential integrity constraints. With direct-path INSERT , the database appends the inserted data after existing data in the table. Data is written directly into data files, bypassing the buffer cache. Free space in the existing data is not reused. This alternative enhances performance during insert operations and is similar to the functionality of the Oracle direct-path loader utility, SQL*Loader. When you insert into a table that has been created in parallel mode, direct-path INSERT is the default.
The manner in which the database generates redo and undo data depends in part on whether you are using conventional or direct-path INSERT :
Conventional INSERT always generates maximal redo and undo for changes to both data and metadata, regardless of the logging setting of the table and the archivelog and force logging settings of the database.
Direct-path INSERT generates both redo and undo for metadata changes, because these are needed for operation recovery. For data changes, undo and redo are generated as follows:
Direct-path INSERT always bypasses undo generation for data changes.
If the database is not in ARCHIVELOG or FORCE LOGGING mode, then no redo is generated for data changes, regardless of the logging setting of the table.
If the database is in ARCHIVELOG mode (but not in FORCE LOGGING mode), then direct-path INSERT generates data redo for LOGGING tables but not for NOLOGGING tables.
If the database is in ARCHIVELOG and FORCE LOGGING mode, then direct-path SQL generate data redo for both LOGGING and NOLOGGING tables.
Direct-path INSERT is subject to a number of restrictions. If any of these restrictions is violated, then Oracle Database executes conventional INSERT serially without returning any message, unless otherwise noted:
You can have multiple direct-path INSERT statements in a single transaction, with or without other DML statements. However, after one DML statement alters a particular table, partition, or index, no other DML statement in the transaction can access that table, partition, or index.
Queries that access the same table, partition, or index are allowed before the direct-path INSERT statement, but not after it.
If any serial or parallel statement attempts to access a table that has already been modified by a direct-path INSERT in the same transaction, then the database returns an error and rejects the statement.
The target table cannot be of a cluster.
The target table cannot contain object type columns.
Direct-path INSERT is not supported for an index-organized table (IOT) if it has a mapping table, or if it is reference by a materialized view.
Direct-path INSERT into a single partition of an index-organized table (IOT), into a partitioned IOT with only one partition, or into an IOT that is not partitioned, will be done serially, even if the IOT was created in parallel mode or you specify the APPEND or APPEND_VALUES hint. However, direct-path INSERT operations into a partitioned IOT will honor parallel mode as long as the partition-extended name is not used and the IOT has more than one partition.
The target table cannot have any triggers or referential integrity constraints defined on it.
The target table cannot be replicated.
A transaction containing a direct-path INSERT statement cannot be or become distributed.
You cannot query or modify direct-path inserted data immediately after the insert is complete. If you attempt to do so, an ORA-12838 error is generated. You must first issue a COMMIT statement before attempting to read or modify the newly-inserted data.
Oracle Database Administrator’s Guide for a more complete description of direct-path INSERT
Oracle Database Utilities for information on SQL*Loader
Oracle Database SQL Tuning Guide for information on statistics gathering when inserting into an empty table using direct-path INSERT
Оператор SQL INSERT для вставки данных в таблицу БД
Оператор SQL INSERT предназначен для вставки значений столбцов в таблицу баз данных. В результате его применения в таблице базы данных появляется новая строка.
Оператор INSERT имеет следующий синтаксис:
Квадратные скобки [], в которые заключен элемент запроса (ИМЕНА СТОЛБЦОВ), означают, что этот элемент является необязательным.
Вставка значений в таблицу с указанием или без указания столбцов
Рассмотрим подробнее применение оператора INSERT с указанием имён столбцов и без указания, остановимся на случаях, когда указывать имена столбцов всё же требуется.
Будем работать с базой данных портала объявлений. В ней есть таблица ADS, содержащая данные о объявлениях, поданных за неделю.
Если вы хотите выполнить запросы к базе данных из этого урока на MS SQL Server, но эта СУБД не установлена на вашем компьютере, то ее можно установить, пользуясь инструкцией по этой ссылке .
А скрипт для создания базы данных «Портал объявлений 1», её таблицы и заполения таблицы данных — в файле по этой ссылке .
Для использующих же MySQL приводим содержание оператора CREATE для создания таблицы:
Пример 1. Итак, есть база данных портала объявлений. Таблица ADS выглядит так:
| Id | Category | Part | Units | Money |
| 1 | Транспорт | Автомашины | 110 | 17600 |
| 2 | Недвижимость | Квартиры | 89 | 18690 |
| 3 | Недвижимость | Дачи | 57 | 11970 |
| 4 | Транспорт | Мотоциклы | 131 | 20960 |
| 5 | Стройматериалы | Доски | 68 | 7140 |
| 6 | Электротехника | Телевизоры | 127 | 8255 |
| 7 | Электротехника | Холодильники | 137 | 8905 |
| 8 | Стройматериалы | Регипс | 112 | 11760 |
| 9 | Досуг | Книги | 96 | 6240 |
| 10 | Недвижимость | Дома | 47 | 9870 |
| 11 | Досуг | Музыка | 117 | 7605 |
| 12 | Досуг | Игры | 41 | 2665 |
Для вставки новой строки в эту таблицу на MySQL используем следующий запрос:
Или без указания имён столбцов:
MS SQL Server в ответ на такой запрос выдаст сообщение об ошибке, так как при создании таблицы было указано, что значения столбца Id являются идентификаторами и вставляются при добавлении новых строк автоматически с приращением 1. Поэтому на MS SQL Server нужно использовать следующий запрос (можете скопировать его и вставить в окно запросов):
В результате выполнения запроса в таблице появится новая строка:
| 13 | Недвижимость | Гаражи | 22 | 4620 |
Из примера видно, что для вставки числовых значений в таблицу значения нужно указывать без кавычек, а для вставки строковых значений — в одинарных кавычках.
В запросе на вставку данных можно список столбцов можно указать не в том порядке, который задан при создании таблицы, и тогда данные следует указывать также в изменённом порядке.
Пример 2. Таким будет запрос на MySQL, в котором порядок следования столбцов изменён:
В результате выполнения запроса в таблице появится такая же новая строка, как и в примере 1.
Если вы используете MS SQL Server, то в запросе не нужно указывать столбец Id и запрос с изменённым порядком следования столбцов будет таким:
Вставка значений по умолчанию (DEFAULT) и неопределённых значений (NULL)
Заметим, что при создании таблицы было предусмотрено, что значения столбцов могут иметь значения по умолчанию (DEFAULT). На MySQL для столбца Id можно предусмотреть значение 100. На MS SQL Server со строгим автоматическим приращением идентификатора это не допускается. В остальном же всё одинаково: для стобцов Category и Part значения по умолчанию — соответственно Some Category и Some Part, для столбцов Units и Money — значения NULL. Если в запросе на вставку данных на MySQL некоторые столбцы отсутствуют, то в них будут вставлены значения по умолчанию. На MS SQL в качестве значений нужно указать DEFAULT.
Пример 3. База данных и таблица — те же.
Запрос на MySQL. Вставим новые значения, указывая лишь столбец Id и его значение:
Все столбцы кроме Id получили значения по умолчанию. После выполнения этого запроса новая строка будет содержать следующие данные:
| 14 | Some Category | Some Part | NULL | NULL |
На MS SQL Server такой запрос недопустим.
Поскольку все столбцы могут иметь значения по умолчанию, можно использовать в запросе на вставку данных ключевое слово DEFAULT и не указывать имена столбцов.
Пример 4. Запрос на MySQL. Вставим новые значения, используя ключевое слово DEFAULT и не указывая имён столбцов:
Теперь все столбцы получили значения по умолчанию. После выполнения этого запроса новая строка будет содержать следующие данные:
| 100 | Some Category | Some Part | NULL | NULL |
Запрос на MS SQL Server (без указания столбца Id):
Вместо многократного использования слова DEFAULT можно использовать конструкцию DEFAULT VALUES, которая есть во многих диалектах SQL. Следует помнить, что в MySQL эта конструкция отсутствует.
Пример 5. Вставим новые значения, используя констукцию DEFAULT VALUES (запрос можно использовать и на MS SQL Server c предваряющей конструкцией USE adportal1):
После выполнения этого запроса новая строка будет содержать следующие данные:
| след. номер | Some Category | Some Part | NULL | NULL |
Вставка значений с использованием оператора SET в MySQL
В MySQL дополнительно существует альтернативная конструкция для вставки значений в таблицу с использованием оператора SET. Она похожа на конструкцию оператора UPDATE и имеет следующий синтаксис:
В подобных запросах можно указывать имена не всех столбцов, при этом не указанные столбцы принимают значения по умолчанию.
Пример 6. База данных и таблица — те же, что и в предыдущих примерах.
Вставим в таблицу строку, при этом столбцы Units и Money примут значения по умолчанию:
В результате выполнения запроса в таблице появится новая строка:
| 13 | Недвижимость | Гаражи | NULL | NULL |
Использование механизма автоматического приращения при вставке данных
Механизм автоматического приращения предназначен для автоматического генерирования уникальных значений первичного ключа в таблице. При его использовании не требуется проверять все значения первичного ключа, чтобы определить максимальное значение. При создании новой записи можно указать в качестве значения первичного ключа 0 или NULL и в таблицу будет автоматически вставлено значение, увеличенное на единицу по сравнению с максимальным значением.
В разных диалектах SQL синтаксис автоматического приращения различается. В MySQL используется ключевое слово AUTO_INCREMENT. Таблица с использованием механизма AUTO_INCREMENT в MySQL создаётся так:
В SQL Server используется ключевое слово IDENTITY (N, M), где N — начальное значение столца, M — шаг приращения. Так, указав IDENTITY (1, 1) мы обеспечим начальное значение первичного ключа 1 и приращение на 1 значения при каждой вставке новой строки:
Вставка нескольких строк в таблицу
Применение рассмотренного выше механизма автоматического приращения позволяет вставлять в таблицу базы данных сразу несколько строк, не заботясь об уникальности значений первичного ключа.
Для этого применяется либо однострочный, либо многострочный оператор INSERT. Рассмотрим сначала синтаксис однострочного варианта.
Пример 7. Если используется механизм автоматического приращения значений первичного ключа, то на MySQL вставить новые строки в таблицу можно, применив несколько раз оператор INSERT и указав в качестве значений первичного ключа 0 или NULL:
Допустим, перед вставкой новых строк записи в таблице завершались строкой со значением первичного ключа 5. В результате выполнения запроса в таблице появятся новые строки:
| 6 | Электротехника | Телевизоры | 127 | 8255 |
| 7 | Электротехника | Холодильники | 137 | 8905 |
| 8 | Стройматериалы | Регипс | 112 | 11760 |
| 9 | Досуг | Книги | 96 | 6240 |
На MS SQL Server нет необходимости указывать значения столбца Id. Аналогичный запрос будет следующим:
В MySQL и SQL Server существует многострочный оператор INSERT. Его отличие от однострочного варианта в том, что для вставки нескольких строк он используется один раз, а после ключевого слова VALUES указывается не один, а несколько списков значений добавляемых строк.
Пример 8. Вставим строки с теми же значениями, что и в предыдущем примере, используя многострочный оператор INSERT.
Запрос на MySQL:
Запрос на MS SQL Server:
Результат применения — тот же, что и в предыдущем примере.
Примеры запросов к базе данных «Портал объявлений-1» есть также в уроках об операторах UPDATE, DELETE, HAVING и UNION.
INSERT INTO в SQL
Оператор INSERT INTO используется для вставки новых строк в таблицу. Например:
Здесь мы вставляем новую строку с указанными значениями в таблицу Customers.

Примечание: Если нужно вставить данные из другой существующей таблицы, следует использовать команду INSERT INTO SELECT.
В таблице поле с идентификатором обычно является уникальным и автоматически увеличивается на единицу. В таких случаях мы можем не указывать значение для этого столбца при вставке строки. Например: