SQL
ВЫБРАТЬ
Оператор SELECT лежит в основе большинства SQL-запросов. Он определяет, какой результат должен быть возвращен запросом, и почти всегда используется в сочетании с предложением FROM, которое определяет, какую часть (ы) базы данных следует запрашивать.
Синтаксис
SELECT [DISTINCT] [column1] [, [column2] . ]
FROM [таблица]
[ГДЕ условие]
[GROUP BY [column1] [, [column2] . ]
[HAVING [column1] [, [column2] . ]
[ORDER BY ASC | DESC]
замечания
SELECT определяет, какие данные столбцов будут возвращены и в каком порядке из данной таблицы (при условии, что они соответствуют другим требованиям в вашем запросе конкретно — где и с фильтрами и объединениями).
будут возвращать результаты только из столбцов Name и Serial Number , но не из столбца Rank , например
указывает, что все столбцы будут возвращены. Однако учтите, что это низкая практика SELECT * поскольку вы буквально возвращаете все столбцы таблицы.
Использование символа подстановки для выбора всех столбцов в запросе.
Рассмотрим базу данных со следующими двумя таблицами.
Таблица сотрудников:
| Я бы | FName | LName | DeptId |
|---|---|---|---|
| 1 | Джеймс | кузнец | 3 |
| 2 | Джон | Джонсон | 4 |
Таблица отделов:
| Я бы | название |
|---|---|
| 1 | Продажи |
| 2 | маркетинг |
| 3 | финансов |
| 4 | ЭТО |
Операция простого выбора
* — это символ подстановки, используемый для выбора всех доступных столбцов в таблице.
При использовании в качестве замены явных имен столбцов он возвращает все столбцы во всех таблицах, которые запрос выбирает FROM . Этот эффект применяется ко всем таблицам, к которым обращается запрос через его предложения JOIN .
Рассмотрим следующий запрос:
Он вернет все поля всех строк таблицы Employees :
| Я бы | FName | LName | DeptId |
|---|---|---|---|
| 1 | Джеймс | кузнец | 3 |
| 2 | Джон | Джонсон | 4 |
Точечная нотация
Чтобы выбрать все значения из конкретной таблицы, подстановочный знак можно применить к таблице с точечной нотацией .
Рассмотрим следующий запрос:
Это вернет набор данных со всеми полями в таблице Employee , а затем просто поле Name в таблице Departments :
| Я бы | FName | LName | DeptId | название |
|---|---|---|---|---|
| 1 | Джеймс | кузнец | 3 | финансов |
| 2 | Джон | Джонсон | 4 | ЭТО |
Предупреждения против использования
Как правило, рекомендуется использовать * в производственном коде, где это возможно, поскольку это может вызвать ряд потенциальных проблем, в том числе:
- Избыток ввода-вывода, загрузка сети, использование памяти и т. Д. Из-за того, что данные базы данных не считывают данные и не передают их интерфейсу. Это особенно опасно, когда могут быть большие поля, такие как те, которые используются для хранения длинных заметок или прикрепленных файлов.
- Дальнейшая избыточная загрузка ввода-вывода, если базе данных необходимо спутать внутренние результаты на диск как часть обработки запроса более сложным, чем SELECT <columns> FROM <table> .
- Дополнительная обработка (и / или даже больше ввода-вывода), если некоторые из ненужных столбцов:
- вычисляемые столбцы в базах данных, которые их поддерживают
- в случае выбора из представления столбцы из таблицы / представления, которые оптимизатор запросов мог бы в противном случае оптимизировать
- Потенциал неожиданных ошибок, если столбцы добавляются к таблицам и представлениям позже, приводит к неоднозначным именам столбцов. Например, SELECT * FROM orders JOIN people ON people.id = orders.personid ORDER BY displayname — если столбец столбца с именем displayname добавлен в таблицу заказов, чтобы пользователи могли давать свои заказы значимых имен для будущей ссылки, тогда появится имя столбца дважды на выходе, поэтому предложение ORDER BY будет неоднозначным, что может привести к ошибкам («неоднозначное имя столбца» в последних версиях MS SQL Server), и если не в этом примере, ваш код приложения может начать отображать имя заказа, в котором имя человека потому что новый столбец является первым из этого имени, и так далее.
Когда вы можете использовать * , принимая предупреждение выше?
Несмотря на то, что в производственном коде лучше всего избегать, использование * отлично подходит для выполнения ручных запросов к базе данных для исследования или работы прототипа.
Иногда проектные решения в вашей заявке делают ее неизбежной (в таких обстоятельствах предпочитают tablealias.* по возможности * возможности).
При использовании EXISTS , таких как SELECT A.col1, A.Col2 FROM A WHERE EXISTS (SELECT * FROM B where A.ID = B.A_ID) , мы не возвращаем никаких данных из B. Таким образом, соединение не нужно, и двигатель знает, что никакие значения из B не должны быть возвращены, поэтому при использовании * . Аналогично COUNT(*) является прекрасным, так как он также фактически не возвращает ни один из столбцов, поэтому нужно только читать и обрабатывать те, которые используются для целей фильтрации.
Выбор с условием
Основной синтаксис предложения SELECT с предложением WHERE:
[Condition] может быть любым выражением SQL, указанным с использованием сравнительных или логических операторов, таких как>, <, =, <>,> =, <=, LIKE, NOT, IN, BETWEEN и т. Д.
Следующий оператор возвращает все столбцы из таблицы «Автомобили», где столбец состояния «ГОТОВ»:
См. WHERE и HAVING для получения дополнительных примеров.
Выберите отдельные столбцы
Этот оператор возвращает столбцы PhoneNumber , Email и PreferredContact из всех строк таблицы Customers . Также столбцы будут возвращены в последовательности, в которой они отображаются в предложении SELECT .
| Номер телефона | Эл. адрес | PreferredContact |
|---|---|---|
| 3347927472 | [email protected] | ТЕЛЕФОН |
| 2137921892 | [email protected] | ЭЛ. АДРЕС |
| НОЛЬ | [email protected] | ЭЛ. АДРЕС |
Если несколько таблиц объединены вместе, вы можете выбрать столбцы из определенных таблиц, указав имя таблицы перед именем столбца: [table_name].[column_name]
* AS OrderId означает, что поле Id таблицы Orders будет возвращено в виде столбца с именем OrderId . Для получения дополнительной информации см. Выбор с помощью псевдонима столбца .
Чтобы избежать использования имен длинных таблиц, вы можете использовать псевдонимы таблиц. Это уменьшает боль при написании длинных имен таблиц для каждого поля, которое вы выбираете в объединениях. Если вы выполняете самостоятельное соединение (соединение между двумя экземплярами одной и той же таблицы), вы должны использовать псевдонимы таблиц, чтобы отличать ваши таблицы. Мы можем написать псевдоним таблицы, такой как Customers c или Customers AS c . Здесь c работает как псевдоним для Customers и мы можем выбрать, скажем, по Email : c.Email .
SELECT Использование псевдонимов столбцов
Алиасы столбцов используются, главным образом, для сокращения кода и создания более удобных имен столбцов.
Код становится короче, как длинные имена таблиц и ненужная идентификация столбцов (например, в таблице может быть 2 идентификатора, но только один из них используется в инструкции) . Наряду с псевдонимами таблиц это позволяет использовать более длинные описательные имена в структуре вашей базы данных, сохраняя при этом запросы в этой структуре краткими.
Кроме того, они иногда требуются , например, в представлениях, чтобы назвать вычисленные выходы.
Все версии SQL
Псевдонимы могут быть созданы во всех версиях SQL с использованием двойных кавычек ( " ).
Различные версии SQL
Вы можете использовать одинарные кавычки ( ' ), двойные кавычки ( " ) и квадратные скобки ( [] ) для создания псевдонима в Microsoft SQL Server.
| Имя | Второе имя | Фамилия |
|---|---|---|
| Джеймс | Джон | кузнец |
| Джон | Джеймс | Джонсон |
| Майкл | Маркус | Williams |
Этот оператор возвращает столбцы FName и LName с заданным именем (псевдоним). Это достигается с помощью оператора AS за которым следует псевдоним, или просто записывая псевдоним непосредственно после имени столбца. Это означает, что следующий запрос имеет тот же результат, что и выше.
| Имя | Второе имя | Фамилия |
|---|---|---|
| Джеймс | Джон | кузнец |
| Джон | Джеймс | Джонсон |
| Майкл | Маркус | Williams |
Однако явная версия (т. Е. Использование оператора AS ) более читаема.
Если псевдоним имеет одно слово, которое не является зарезервированным словом, мы можем записать его без одинарных кавычек, двойных кавычек или скобок:
| Имя | Фамилия |
|---|---|
| Джеймс | кузнец |
| Джон | Джонсон |
| Майкл | Williams |
Еще один вариант, доступный в MS SQL Server, — это <alias> = <column-or-calculation> , например:
| ФИО | Addr1 | Addr2 |
|---|---|---|
| Джеймс Смит | 123 AnyStreet | TownVille |
| Джон Джонсон | 668 MyRoad | Anytown |
| Майкл Уильямс | 999 High End Dr | Williamsburgh |
Некоторые находят использование = вместо того, чтобы читать As легче, хотя многие рекомендуют этот формат, главным образом потому, что он не является стандартным, поэтому не поддерживается всеми базами данных. Это может привести к путанице с другими использованиями символа = .
Все версии SQL
Кроме того, если вам нужно использовать зарезервированные слова, вы можете использовать скобки или кавычки для выхода:
Различные версии SQL
Аналогично, вы можете избежать ключевых слов в MSSQL со всеми различными подходами:
| ВЫБРАТЬ | ОТ | ГДЕ |
|---|---|---|
| Джеймс | Джон | кузнец |
| Джон | Джеймс | Джонсон |
| Майкл | Маркус | Williams |
Кроме того, псевдоним столбца может использоваться любым из заключительных предложений одного и того же запроса, например ORDER BY :
Однако вы не можете использовать
Чтобы создать псевдоним из этих зарезервированных слов ( SELECT и FROM ).
Это вызовет многочисленные ошибки при выполнении.
Выбор с отсортированными результатами
Этот оператор вернет все столбцы из таблицы Employees .
| Я бы | FName | LName | Номер телефона |
|---|---|---|---|
| 2 | Джон | Джонсон | 2468101214 |
| 1 | Джеймс | кузнец | 1234567890 |
| 3 | Майкл | Williams | 1357911131 |
Это заявление изменяет направление сортировки.
Можно также указать несколько столбцов сортировки. Например:
Этот пример сначала сортирует результаты по LName а затем для записей, имеющих одно и то же LName , сортирует по FName . Это даст вам результат, аналогичный тому, что вы найдете в телефонной книге.
Чтобы сохранить переименование имени столбца в предложении ORDER BY , вместо него можно использовать номер столбца. Обратите внимание, что номера столбцов начинаются с 1.
Вы также можете включить оператор CASE в предложение ORDER BY .
Это приведет к сортировке результатов, чтобы все записи были с LName «Jones» вверху.
Выберите столбцы с именами из зарезервированных ключевых слов
Когда имя столбца соответствует зарезервированному ключевому слову, стандартный SQL требует, чтобы вы заключили его в двойные кавычки:
Обратите внимание, что это делает имя столбца чувствительным к регистру.
Некоторые СУБД имеют собственные способы цитирования имен. Например, для этой цели SQL Server использует квадратные скобки:
в то время как MySQL (и MariaDB) по умолчанию используют обратные ссылки:
Выбор указанного количества записей
Стандарт SQL 2008 определяет предложение FETCH FIRST , чтобы ограничить количество возвращенных записей.
Этот стандарт поддерживается только в последних версиях некоторых RDMS. Специфический нестандартный синтаксис, предоставляемый поставщиком, предоставляется в других системах. Прогресс OpenEdge 11.x также поддерживает синтаксис FETCH FIRST <n> ROWS ONLY .
Кроме того, OFFSET <m> ROWS перед FETCH FIRST <n> ROWS ONLY позволяет пропускать строки перед извлечением строк.
Следующий запрос поддерживается в SQL Server и MS Access:
Чтобы сделать то же самое в MySQL или PostgreSQL, необходимо использовать ключевое слово LIMIT :
В Oracle то же самое можно сделать с ROWNUM :
Результаты : 10 записей.
Нюансы поставщика:
Важно отметить, что TOP в Microsoft SQL работает после WHERE и возвращает указанное количество результатов, если они существуют в любой точке таблицы, в то время как ROWNUM работает как часть WHERE , поэтому, если другие условия не существуют в указанное количество строк в начале таблицы, вы получите нулевые результаты, когда могут быть найдены другие.
Выбор с псевдонимом таблицы
Таблице Employees присваивается псевдоним «e» непосредственно после имени таблицы. Это помогает устранить неоднозначность в сценариях, где несколько таблиц имеют одинаковое имя поля, и вам нужно указать, в какой таблице вы хотите вернуть данные.
Обратите внимание, что как только вы определяете псевдоним, вы больше не можете использовать имя канонической таблицы. т.е.
будет выдавать ошибку.
Стоит отметить табличные псевдонимы — более формально «переменные диапазона» — были введены в язык SQL для решения проблемы дублированных столбцов, вызванных INNER JOIN . Стандарт SQL 1992 года исправил этот ранее недостаток дизайна, введя NATURAL JOIN (реализованный в mySQL, PostgreSQL и Oracle, но еще не в SQL Server), результат которого никогда не имеет повторяющихся имен столбцов. Вышеприведенный пример интересен тем, что таблицы объединяются в столбцы с разными именами ( Id и ManagerId ), но не должны соединяться в столбцах с тем же именем ( LName , FName ), требуя переименования столбцов, которые должны быть выполнены перед присоединением:
Обратите внимание, что хотя переменная alias / range должна быть объявлена для таблицы dervied (иначе SQL будет выдавать ошибку), никогда не имеет смысла фактически использовать ее в запросе.
Выбор строк из нескольких таблиц
Это называется кросс-продуктом в SQL, оно аналогично перекрестному продукту в наборах
Эти операторы возвращают выбранные столбцы из нескольких таблиц в одном запросе.
Между столбцами, возвращаемыми из каждой таблицы, нет никакой конкретной связи.
Выбор с помощью функций агрегации
Средний
Если сотрудник разделен на несколько отделов, и мы хотим найти среднюю зарплату для каждого отдела, мы можем использовать следующий запрос.
минимальный
максимальная
подсчитывать
сумма
Выбор с нулевым
Выбор с нулями принимает другой синтаксис. Не используйте = , используйте IS NULL или IS NOT NULL .
Выбор с помощью CASE
Когда результаты должны иметь некоторую логику, применяемую «на лету», можно использовать оператор CASE для ее реализации.
также может быть прикован
один может также иметь CASE внутри другого оператора CASE
Выбор без блокировки таблицы
Иногда, когда таблицы используются в основном (или только) для чтения, индексирование больше не помогает, и каждый бит подсчитывается, можно использовать select без LOCK для повышения производительности.
где UR означает «незафиксированное чтение».
Если вы используете таблицу, которая имеет изменения в записи, может иметь непредсказуемые результаты.
Выберите отдельные (только уникальные значения)
Этот запрос вернет все значения DISTINCT (уникальные, разные) из столбца ContinentCode из таблицы Countries
| ContinentCode |
|---|
| OC |
| Евросоюз |
| КАК |
| Не Доступно |
| AF |
Выбрать с условием нескольких значений из столбца
Это семантически эквивалентно
т.е. value IN ( <value list> ) является сокращением для дизъюнкции (логическое OR ).
Получить агрегированный результат для групп строк
Подсчет строк на основе определенного значения столбца:
Получение среднего дохода по отделу:
Важно выбрать только столбцы, указанные в предложении GROUP BY или используемые с агрегатными функциями .
Предложение WHERE также может использоваться с GROUP BY , но WHERE фильтрует записи до того, как будет выполнена какая-либо группировка:
Если вам нужно отфильтровать результаты после завершения группировки, например, чтобы увидеть только отделы, средний доход которых превышает 1000, вам нужно использовать предложение HAVING :
Выбор с более чем 1 условием.
AND ключевое слово используется для добавления дополнительных условий для запроса.
| название | Возраст | Пол |
|---|---|---|
| Сэм | 18 | M |
| Джон | 21 | M |
| боб | 22 | M |
| Мэри | 23 | F |
| название |
|---|
| Джон |
| боб |
использование ключевого слова OR
| название |
|---|
| Сэм |
| Джон |
| боб |
Эти ключевые слова могут быть объединены для более сложных сочетаний критериев:
Работаем с SQL – выборка данных
Самым популярным способом доступа к реляционным базам данных является язык запросов SQL. Именно с ним мы и будем знакомиться в этой главе. Мне кажется, проще всего начинать знакомство с доступа к данным, потому что это самый важный и часто используемый компонент и знание, которое необходимо программистам и тестерам.
Для те, кто знает и тем более говорит на английском язык запросов будет прост, потому что построение команд по своей структуре похоже, как мы строим предложения, чтобы попросить голосовой помощник сделать что-то.
Для тестирования нам понадобиться какая-то база данных, на которой мы будем тренироваться. Так как создание самой базы и таблиц я решил отложить на потом, я подготовил файл, который создаст для вас две таблицы.
| Phoneid | Firstname | Lastname | Phone | Cityid |
|---|---|---|---|---|
| 1 | John | Doe | 4144122 | 1 |
| 2 | Steve | Doe | 414124 | 1 |
| 3 | Johnatan | Something | 4142947 | 2 |
| 4 | Donald | Trump | 414251123 | 2 |
| 5 | Alice | Cooper | 414254234 | 2 |
| 6 | Michael | Jackson | 4142544 | 3 |
| 7 | John | Abama | 414254422 | 3 |
| 8 | Andre | Jackson | 414254422 | 3 |
| 9 | Mark | Oh | 414254422 | |
| 10 | Charly | Lownoise | 414254422 |
| Cityid | cityname |
|---|---|
| 1 | Toronto |
| 2 | Vancouver |
| 3 | Montreal |
Итак, скачайте файл testdb.sql
Если вы используете VS Code, то подключитесь к базе данных mysql, откройте новое окно для SQL запросов, скопируйте в него содержимое файла testdb.sql, и нажмите кнопку выполнения.
Если вы используете командную строку, то подключитесь к базе данных, скопируйте содержимое файла testdb.sql в буфер обмена и теперь кликните правой кнопкой в окне терминала. Команды из файла должны вставиться и выполниться в терминале. Выполняться все, кроме последней, вам скорей всего придется нажать Enter, чтобы завершить последнюю команду.
Теперь мы готовы к изучению SQL. Когда вы работаете с Excel таблицей, что вы можете с ней сделать? Искать данные в таблице поиском, добавлять новые строки, изменять существующие, удалять строки. То же самое можно делать и с базой данных, давайте начнем знакомиться с тем, как можно отображать содержимое таблицы и искать данные.
SELECT доступ к одной таблице
Команда SELECT достаточно простая, потому что она выглядит и звучит вполне логично и последовательно. Да, она может быть и сложной, потому что позволяет достаточно многое, и чтобы не пугать вас, я даже не буду пытаться показывать сейчас максимальную версию.
Начнем с самой простой версии:
Большими буквами я выделил ключевые слова языка запросов SQL, а русскими маленькими буквами показано то, что мы должны заменить на реальные значения. Если перевести эту команду, то она будет звучать:
Если исправить склонение в последнем слове, то все будет звучать совсем ясно и понятно.
Колонки – это список имен колонок через запятую. Если вы хотите выбрать все колонки, то можно указать символ звездочки *.
У нас есть таблица City, давайте выберем из нее все записи и все колонки. Все колонки, значит нужно заменить слово «колонки» на символ звездочки, а на месте таблицы пишем city и в результате получаем
Не забываем, что если выполнять из командной строки в mysql, то нужно в конце добавить точку запятой, но очень часто она не нужна, поэтому я в своих запросах буду опускать этот символ.
В результате мы должны увидеть следующее:
Если мы пишем множество запросов, неужели каждый раз придется писать имя базы данных перед именем таблицы? Нет, это не обязательно. Если вы работаете с определенной базой, то можно как бы перейти в нее, или можно еще сказать выбрать ее. Для этого выполняем команду:
Слово USE означает «использовать». То есть мы просим сервер использовать определенную базу для всех последующих запросов, пока снова не выберем другую. В нашем случае база данных это testdb, так что выполняем команду:
Теперь имя базы перед именем таблицы указывать не нужно, а значит запрос на получения всех колонок и всех строк из таблицы city может выглядеть теперь так:
Это достаточно важный пункт, поэтому не забывайте его. В дальнейшем я буду писать запросы с учетом, что текущая база данных это testdb и поэтому перед именем таблицы указывать имя базы не буду.
В зависимости от настроек и используемой базы данных имена SQL может быть чувствительным к регистру и нет. Все чаще сталкиваюсь с тем, что MySQL по умолчанию ставится чувствительным к регистру, а значит имя таблицы нужно указать именно так, как это было при создании. Чтобы было проще, я все имена давал в нижем регистре.
Это значит, что следующие две команды могут завершиться ошибкой:
Потому что называние города написано в неверном регистре.
Писать команды SQL большими буквами не обязательно. Вот их как раз можно писать в любом регистре и следующая команда завершиться удачно:
Я не помню уже почему, то много лет назад, еще в 90-е годы я привык писать все слова, которые относятся к SQL большими буквами, чтобы они выделялись. На мой взгляд это читается проще, но вы не обязаны следовать этому же подходу.
Если в качестве колонок указать звездочку, то отображаются все поля в том порядке, в котором они создавались в базе данных. Мы можем перечислить имена через запятую:
В этом случае у нас есть возможность указать имена в любом порядке и указать сначала имя города, а потом идентификатор:
Или можно отобразить только имя города:
Настоятельно рекомендую повторять все, что мы здесь рассматриваем, потому что именно практика позволяет лучше запомнить материал.
Пробелы в именах объектов базы данных
У тебя может возникнуть вопрос – а что, а можно создавать имена таблица или колонок из нескольких слов и как тогда MySQL будет работать с пробелами? Создавать объекты с пробелами можно, но в этом случае имя нужно окружить специальными символами, которые зависят от базы данных, в MySQL это символ ` который находится слева от цифры 1 на большинстве клавиш.
Так что теоретически наш запрос может выглядеть так:
Обратите внимание, что колонка Address id содержит пробел, поэтому вначале и в конце стоит символ `. У колонки Name нет пробелов, поэтому ничего добавлять не нужно. У имени таблицы так же есть пробел.
Если в имени объекта есть пробел, то ` является обязательным, если пробела нет, то можно поставить, а можно и опустить. Это значит, следующие запросы одинаково корректны:
Все они корректны и все будут работать.
Хотя все примеры мы рассматриваем и тестируем под MySQL, почти все они будут работать и в других базах данных, но вот разделитель в разных базах может отличаться. В MS SQL Server это квадратные скобки:
Очень часто программисты стараются создавать таблицы и колонки без пробелов, поэтому не так часто можно увидеть запросы, в которых используются символы, которыми окружаются имена объектов.
Фильтрация выборки WHERE
Отлично, мы научились выбирать все данные из таблицы или определенные колонки, а теперь хорошо бы научиться еще и выбирать только определенные строки.
Формат команды выборки начинает усложняться и уже начинает выглядеть так:
В качестве фильтра можно указывать имя колонки, по которой мы хотим фильтровать и значение, которое мы ищем. Например, если мы хотим найти все записи из нашего телефонного справочника, где фамилия владельца это Doe, то мы должны в фильтре указать:
Здесь lastname – это имя колонки, поэтому его просто указываем без каких-то дополнений. Когда сервер будет читать этот запрос, то он увидит слово lastname, попробует найти это имя среди известных ему имен и без проблем сможет найти его, так что вопросов нет.
Фамилия – это строка, которая неизвестна MySQL. Для него это просто текст, и он не уверен, где начинается строка и заканчивается. Чтобы проще было определить начало и конец произвольных строк, мы должны помещать их в одинарные кавычки, как в примере выше.
Взглянем на следующий пример:
Без одинарных кавычек MySQL не сможет понять этот фильтр, потому что он будет думать – нужно ли искать только по Mc или нужно искать по Mc Donald. А если все это объединить в одинарные кавычки, то фильтр станет корректным.
Если символы, которыми мы окружаем имена объектов являются НЕ обязательными, то одинарные кавычки являются обязательными и их опускать НЕЛЬЗЯ.
Итак, полный запрос, который все записи людей с фамилией Doe будет выглядеть так:
В результате вы должны увидеть только две строки:
В большом городе может оказаться слишком много людей с фамилией Doe и когда мы ищем телефон, то скорей всего мы знаем, что нужного нам человека зовут Steve. Мы можем искать сразу по двум колонкам – имени и фамилии, просто объединив обе проверки с помощью слова AND:
В ответ должна быть отображена только одна строка:
Взглянем по-другому – мы ищем по фамилии и хотим увидеть всех, чья фамилия Doe или Jackson. Просто возможно человек поменял фамилию, и мы не знаем, под какой из них остался зарегистрирован телефон. Нам нужна записи, где колонка lastname равна Doe или Jackson. Именно так мы и должны писать наш запрос, объединив две проверки с помощью ИЛИ, в английском это OR:
Ok, фамилии меняют после свадьбы и хотя у меня в таблице все имена мужские (я только сейчас сообразил и это сделано не специально), допустим, что мы знаем имя и это Andre. Возможно вы захотите написать запрос так:
Может показаться, что в результате должна быть только одна запись – Andre Jackson, но это не так, мы увидим три записи:
Дело в том, что наш запрос говорит, что мы хотим увидеть всех с фамилией Doe ИЛИ всех с фамилией Jackson и именем Andre. Чтобы проще было понять проблему я добавлю скобки, чтобы показать, как сгруппированы проверки:
Как раз скобки мы и должны использовать, чтобы исправить проблему:
Здесь мы уже говорим, что у человека может быть фамилия Doe или Jackson, но имя обязательно должно быть Andre.
Вот теперь мы увидим в результате только одну запись:
Для подобных задач в SQL есть более красивый синтаксис – использовать слово IN, что можно перевести как одно из. Формат такой:
Колонка in (значения, перечисленные через запятую)
То есть запрос, где мы искали одну из двух фамилий, можно переписать так:
На мой взгляд это читается на много проще. Если прочитать это предложение по-русски, то все будет звучать так:
На мой взгляд наглядно. Если добавить еще и условие с именем, то запрос будет выглядеть так:
Тоже достаточно просто читается и не нужно заморачиваться со скобками, чтобы указать на приоритет, как мы объединяем ИЛИ и И.
Когда мы ищем по числам, то их оборачивать в одинарные кавычки не нужно. Допустим, что мы хотим найти запись в справочнике под номером 1. Именно под номером, а не первую под счету. Такой запрос может выглядеть так:
В случае с числами еще очень часто может потребоваться искать числа больше или меньше какого-то значения. Допустим, что нужно найти все записи, где id телефона меньше 5. В нашем случае это будет первые 4 строки. Как и в математике, так и в программировании можно использовать символы:
- < меньше
- > больше
- >= больше или равно
В нашем случае можно использовать < 5 как в следующем примере:
Если мы хотим включить в выборку и строку с phoneid равных 5, то можно увеличить число до 6 или использовать меньше или равно <=
Усложняем задачу, ищем записи с id больше 3 и меньше 7. И снова мы можем воспользоваться AND, чтобы объединить две проверки:
Чтобы проще читать и красивее все выглядело можно то же самое записать:
Для этой задачи есть вариант решения проще, по крайней мере для некоторых – использовать between:
Обратите внимание, что я использую числа 4 и 6, а не 3 и 7, потому что between включает граничные значение, это то же самое, что и:
С точки зрения чтения это звучит лучше: выбрать все из телефонов, где id между 4 и 6. Звучит хорошо, но я почему-то почти не использую эту конструкцию. Мне больше нравится решать то же самое с помощью математических конструкций > или
Если работать со строками, то тут SQL предоставляет нам некую гибкость, мы можем искать по шаблону. Допустим, что мы хотим найти всех, у кого имя начинается с буквы J. Для этого используем новое слово LIKE. В английском это слово очень часто можно перевести как “нравиться” или “выглядеть как”, в зависимости от того, в качестве какой части речи использовать это слово. В данном случае это второй вариант. После этого мы можем использовать в качестве шаблона специальные символы:
% заменяет любое количество любых символов
_ заменяет один, но любой символ
Так как нам нужно найти всех, у кого первая бука J, а потом идет любое количество любых символов, то наш шаблон будет выглядеть как ‘J%’
А что если мы хотим найти любую фамилию, в которой содержится хотя бы одна буква A. Для этого можно указать % перед и после буквы A:
Символ % означает любое количество любых символов, значит до и после A может быть что угодно и в любом количестве.
Отлично, но что, если мы не знаем только одну букву. Например, моя фамилия Флёнов, но очень часто приходиться писать Фленов только потому, что буква ё не поддерживается. Очень часто это проблема печати – в паспорте, в бумажном журнале или в книге.
Подчеркивание означает один и только один символ. Недостаток именно этого запроса – он возвращает не только Фленов и Флёнов, но, возможно, и какие-то другие вариации, если они существуют Фланов, Флонов и т.д. Но возможно именно это нам и нужно.
Пустые поля NULL
Если выбрать все содержимое таблицы phone, то в последних двух строках будет не число, а какое странное NULL:
NULL – это не строка и не число, это отсутствующее значение, то есть в этих двух строках в колонке cityid отсутствует. NULL можно перевести как ноль, но правильнее все же переводить это слово как “несуществующий” или “недействительный”.
Если поле с числом равно 0, то это число, просто оно нулевое. А если поле с числом равно NULL, то это уже не число и не ноль, это значит, что там вообще числа нет, черная дыра, пробоина, все что угодно, но только не число.
Я только что ляпнул новое понятие – поле. Это пересечение колонки и строки. Это то, куда мы записываем значение какой-то колонки/строки.
Особенно такие вещи могут путать в случае работы со строками. Некоторые программы для работы с запросами отображают пустую строку и отсутствующее значение как просто пустоту. Но это не так. Просто в обоих случаях отобразить нечего.
Для базы данных есть огромная разница – мы храним пустую строку или в поле нет вовсе значения, потому что это разные вещи. Если строка пустая, то это все же строка, просто у нее нет длины, но если значения нет, то строки не существует.
Скорость у машины может быть нулевая, если машина стоит или какое-то число, если машина едет. А если машины нет? Скорости тоже не будет в принципе, и мы не можем сказать, что скорость нулевая у машины, которой просто нет.
Работа с нулевыми полями отличается, потому что если попробовать выполнить запрос:
то ничего не вернется. Казалось бы, мы же сравниваем число символом сравнения с NULL, но это не работает. Дело в том, что сравнивать с помощью равенства нельзя, вместо этого нужно использовать слово is:
А если мы хотим найти все строки, в которых поле не пустое, а имеет какое-то значение. Тут нужно использовать is not:
На этом пока с основами получения данных закончим. В процессе рассмотрения дальнейшего материала мы познакомимся с еще более сложными запросами на практике.
Сортировка данных в запросах SQL
Когда мы выполняем запрос, то база данных может вернуть данные в любой последовательности, хотя чаще всего возвращает строки в том порядке, в котором они хранятся и чаще всего это будет совпадать со значением ключевой колонки, в нашем случае это phoneid.
Если вы хотите отсортировать по фамилии, то мы должны это явно сказать серверу. Для этого используется ORDER BY, который ставиться в конце запроса:
Обратите внимание, что первая колонка теперь не отсортирована, а вот в lastname все значения возрастают начиная с буквы A в сторону Z. Нет, это происходит не всегда. Если мы не указали направление сортировки, то используется ASC, возрастание, то есть это то же самое, что написать:
А теперь посмотрите на колонку имени – оно не по возрастающей. Мы попросили отсортировать по фамилии, а когда фамилия одинаковая, то сервер имеет право вернуть данные в любом порядке и в данном случае ему удобно вывести в соответствии с ключевой колонкой phoneid. У Michael Jackson первая колонка равна 6 и это меньше 8, что мы видим у Andre.
Если вы хотите, чтобы в случае одинаковой фамилии данные сортировались по имени, то нужно указать обе колонки именно в таком порядке:
следующий запрос вернет то же самое, потому что не забываем, что ASC – возрастание это сортировка по умолчанию:
Теперь данные будут сначала отсортированы по фамилии и если фамилия одинакова, то по имени и в обоих случаях по возрастающей.
Можно сортировать по любому количеству колонок, если это реально принесет выгоду.
Если вы хотите отсортировать таблицу по фамилии, но в обратном порядке, то вместо ASC нужно указать DESC – убывание:
Добавить запись в таблицу
Мы разобрались с базовыми возможностями выборки данных и сегодня давайте посмотрим, как можно добавлять новые данные. Самый простой формат вставки данных в базу данных наверно
С именем таблицы вопросов нет. Если мы хотим вставить значения в таблицу телефонов, то пишем:
При такой команде в скобках нужно обязательно указать значения для каждой колонки. Строковые значения должны быть в одинарных кавычках, числовые могут быть в кавычках, но лучше все же без них. Это уже более глубокий вопрос, который мы скорей всего рассмотрим чуть позже.
Мы пока типы полей не рассматривали, но в некоторые колонки вставлять данные нельзя. К таким относится ключевое поле, если оно настроено как авто увеличиваемое. Некоторые базы позволяют изменять даже автоматически увеличиваемые поля, но даже в этом случае это не очень хорошо.
MySQL относится как раз к тем базам, которые могут позволить вставлять даже в автоматические поля, хотя повторюсь, я это не рекомендую. Первое поле в обеих таблицах, которые я создал для примеров этой работы как раз является автоматически увеличиваемым и ключом. Об этом подробнее во время создания таблиц, а сейчас просто для общего развития такой небольшой отступ от основной темы.
Итак, мы должны перечислить значения всех колонок, а их у нас в таблице 5, из которых первое и последние числа, значит их указываем без кавычек и указываем именно число. Первое поле ключ и его значение указывать не обязательно, но если вы сделаете это, то обязательно укажите уникальное число, которого до сих пор не было. Я создал таблицу с 10 строками, и первая колонка содержит значения от 1 до 10. Следующее значение 11, поэтому можно указать его.
Итак, запрос на вставку записи с ID равным 11 будет выглядеть так:
Как я уже сказал, я сделал первую колонку автоматически увеличиваемой, поэтому значение для нее указывать не обязательно. Если вы не хотите самостоятельно искать следующее свободное число, просто не указывайте его, а вместо числа можно использовать NULL, как мы помним это как бы отсутствующее значение:
Если мы показываем, что для первой колонки передано NULL, то есть мы не хотим указывать значение, то для автоматически увеличиваемых полей сервер сам найдет следующее свободное и будет использовать его. В нашем случае должно быть 12. Проверим:
Поля таблиц могут быть настроены так, что они будут обязательными и нет. Я для этого примера намеренно сделал все поля необязательными, а значит мы можем просто передать вместо значений для каждой колонки только NULL:
SELECT * FROM phone WHERE phoneid = 13;
И вот что, что мы получили
Указывать отсутствующее значение (NULL) для всех колонок, для которых мы не хотим указывать реальное значение – странно и глупо. Вместо этого после имени таблицы в скобках можно указать имена колонок, значения которых мы хотим указать:
INSERT phone (phoneid, phone, firstname) VALUES (14, ‘4184719’, ‘Mary’);
В этом запросе после имени таблицы в скобках указаны имена колонок phoneid, phone и firstname. Я намеренно указал имена не в том порядке, как они созданы в таблице, ведь реально имя находиться в таблице вторым, а здесь третьим.
Именно в таком же порядке должны быть предоставлены значения в круглых скобках после слова VALUES. Как видите значения тоже идут в таком же порядке – ID, номер телефона и только потом имя.
Таким образом мы можем опускать любые необязательные поля, но только необязательные. Если колонка обязательно должна иметь значение, то мы обязаны указать ее в операторе INSERT и предоставить значение.
У нас необязательных значений нет, так что теоретически мы можем выполнить такую команду:
Будет вставлена новая строка, у которой будут заданы только колонки, для которых есть значения по умолчанию или автоматически увеличиваемые. Эта команда идентична уже той, что мы выполняли:
Она выполниться успешно только если в таблице нет колонок с обязательными полями без значения по умолчанию.
SQL — Обновление данных
Бывают такие случаи, когда данные вставил в таблицу и они больше никогда не меняются. Но в реальной жизни нередко данные подвержены изменениям и у нас должна быть возможность сделать это.
Минимальная команда изменения данных:
В секции WHERE мы можем писать такие же условия, как мы делали и при SELECT. В остальном в принципе все понятно.
Давайте посмотрим на содержимое строки с >
Здесь у нас Мэри, но у нее не было указано фамилии. Давайте обновим эту строку и укажим фамилию.
Стоп, что указать в качестве фильтра WHERE? Можно указать имя, но если в базе данных будет несколько записей людей с именем Mary, то мы обновим их все. Не думаю, что мы этого хотим.
По номеру телефона. . . Возможно это сработает, если номер действительно уникальный.
Если у нас есть колонка с уникальными значениями, то лучше использовать ее, тогда мы точно будем знать, что обновлена именно нужная нам запись. Именно поэтому создают в базах данных ключевые поля, как я это сделал с phoneid и самый простой способ добиться уникальности – сделать колонку автоматически увеличиваемой или сохранять в ней что-то типа уникального GUID.
Некоторые базы данных даже не позволяют обновлять данные в таблице, если в ней нет уникальной колонки, потому что база данных в таком случае не может гарантировать, что будет обновлена или удалена именно нужная колонка.
Если забыть про наличие phoneid, которую я заведомо и продуманно создал, то мы можем вставить в таблицу две записи с абсолютно одинаковыми значениями. Допустим, что у нас есть такая таблица:
Как мы можем обновить вторую запись Mary, без уникального кода id? А первую? Да все равно какую из них! Записи идентичны и с обновлением проблема. Самый простой способ – удалить обе записи и вставить новые. Да, это решит проблему, но все же.
Именно поэтому некоторые не разрешают изменять данные, если нет первичного ключа, который гарантирует уникальность данных, потому что хотя бы этот ключ и будет различать записи.
С другой стороны, при наличии первичного уникального ключа, которым является personid, желательно использовать его:
Если ты потерялся и все еще не понимаешь, что такое первичный ключ, мы еще будем говорить на тему ключей, когда будем создавать таблицы. Я помню мне тоже на первом этапе знакомства с базами данных было не совсем понятно было что это такое, зачем это нужно. Пока просто помните, что первичный ключ, это колонка (может и не одна), которая гарантирует уникальность каждой строки.
Мы можем обновлять не одну, а сразу несколько колонок, указав их значения через запятую. Давайте изменим сразу фамилию и телефон:
Удаление данных из базы данных
Самая простая тема – это удаление данных. Самый простой вариант удалить данные – выполнить оператор:
Что удалиться? Все!
Если мы не хотим удалять все, то мы можем добавить уже знакомую нам секцию WHERE:
Здесь мы удаляем все записи, где телефон принадлежит человеку с именем Mary. Если их больше одного, то будут удалены все.
Если нужно удалить только конкретную запись, то мы снова можем использовать первичный ключ:
Transact-SQL — инструкция SELECT: базовые возможности

В этой и следующей статьях обсуждается, как использовать инструкцию SELECT для выборки данных из таблиц. В частности, рассматриваются все предложения этой инструкции и приводятся многочисленные примеры с использованием базы данных SampleDb для демонстрации практического применения каждого предложения.
В языке Transact-SQL имеется одна основная инструкция для выборки информации из базы данных — инструкция SELECT. Эта инструкция позволяет извлекать информацию из одной или нескольких таблиц базы данных и даже из нескольких баз данных. Результаты выполнения инструкции SELECT помещаются в еще одну таблицу, называемую результирующим набором (result set).
Самая простая форма инструкции SELECT состоит из списка столбцов выборки и предложения FROM. (Все прочие предложения являются необязательными.) Эта форма инструкции SELECT имеет следующий синтаксис:
В параметре table1 указывается имя таблицы, из которой извлекается информация, а в параметре tab_alias1 — псевдоним имени соответствующей таблицы. Псевдоним — это другое, сокращенное, имя таблицы, посредством которого можно обращаться к этой таблице или к двум логическим экземплярам одной физической таблицы. Если вы испытываете трудности с пониманием этого концепта, не волнуйтесь, поскольку все станет ясно в процессе рассмотрения примеров.
В параметре column_list указывается один или несколько из следующих спецификаторов:
символ звездочка (*) указывает все столбцы таблиц, перечисленных в предложении FROM (или с одной таблицы, если задано указателем в виде table2.*);
явное указание имен столбцов, из которых нужно извлечь значения;
спецификатор в виде column_name [as] column_heading, что позволяет заменить имя столбца при чтении данных (не в базе) или присвоить новое имя выражению;
системная или агрегатная функция.
Инструкция SELECT может извлекать из таблицы как отдельные столбцы, так и строки. Первая операция называется списком выбора (или проекцией), а вторая — выборкой. Инструкция SELECT также позволяет выполнять комбинацию обеих этих операций.
Перед тем как можно выполнять примеры запросов в этой статье, вам необходимо заново создать базу данных SampleDb, которую можно найти в исходниках к этой статье. В следующем примере показана самая простая форма выборки данных посредством инструкции SELECT:
Результат выполнения этого запроса:

В примере инструкция SELECT извлекает все строки всех столбцов таблицы Department. Если список выбора инструкции SELECT содержит все столбцы таблицы (как это показано в примере), их можно указать с помощью звездочки (*), но использовать этот способ не рекомендуется. Имена столбцов служат в качестве заголовков столбцов в результирующем выводе.
Только что рассмотренная простейшая форма инструкции SELECT не очень полезна для практических запросов. На практике в запросах с инструкцией SELECT приходится применять намного больше предложений, чем в запросе, приведенном в примере выше. Далее показан синтаксис инструкции SELECT, содержащий почти все возможные предложения:
Порядок предложений в инструкции SELECT должен быть таким, как показано в приведенном синтаксисе. Например, предложение GROUP BY должно следовать за предложением WHERE и предшествовать предложению HAVING. Предложение INTO не является настолько важным, как другие предложения, и поэтому будет рассмотрено позже других.
Далее мы рассмотрим эти предложения в том порядке, в каком они следуют в запросе, а также рассмотрим свойство IDENTITY, возможность упорядочивания результатов, операторы над множествами и выражение CASE. Но так как первое в списке предложение INTO менее важно, чем остальные, оно будет рассматриваться позже, после всех других предложений.
Предложение WHERE
Часто при выборке данных из таблицы нужны данные только из определенных строк, для чего в запросе определяется одно или несколько соответствующих условий. В предложении WHERE определяется логическое выражение (т.е. выражение, возвращающее одно из двух значений: true или false), которое проверяется для каждой из строк, кандидатов на выборку. Если строка удовлетворяет условию выражения, т.е. выражение возвращает значение true, она включается в выборку; в противном случае строка пропускается.
Применение предложения WHERE показано в примере ниже, в котором происходит выборка имен и номеров отделов, расположенных в Москве:
Результат выполнения этого запроса:

Кроме знака равенства, в предложении WHERE могут применяться другие операторы сравнения, включая следующие:
| Оператор | Значение |
|---|---|
| <> (или !=) | не равно |
| < | меньше чем |
| > | больше чем |
| >= | больше чем или равно |
| <= | меньше чем или равно |
| !> | не больше чем |
| !< | не меньше чем |
В примере ниже показано использование в предложении WHERE одного из этих операторов сравнения:
В этом примере происходит выборка имен и фамилий всех сотрудников, чей табельный номер больше или равен 15 000. Частью условия в предложении WHERE может быть выражение, показанное в примере ниже:
В этом примере происходит выборка проектов с бюджетом свыше 60 000 евро (предполагая, что в поле Budget хранится информация в долларах). Валютный курс: 1.1$ за €1.
Сравнение строк (т.е. значений с типами данных CHAR, VARCHAR, NCHAR и NVARCHAR) выполняется в действующем порядке сортировки, а именно в порядке сортировки, указанном при установке компонента Database Engine. При сравнении строк в кодировке ASCII (или в любой другой кодировке) сравниваются соответствующие символы каждой строки (т.е. первый символ первой строки с первым символом второй строки, второй символ первой строки со вторым символом второй строки и т.д.). Старшинство символа определяется его позицией в кодовой таблице: символ, чей код стоит в таблице перед кодом другого, считается меньше этого символа. При сравнении строк разной длины, более короткая строка дополняется в конце пробелами до длины более длинной строки.
Числа сравниваются алгебраически. Значения временных типов данных (таких как DATE, TIME и DATETIME) сравниваются в хронологическом порядке.
Логические операторы
Условия предложения WHERE могут быть простыми или составными, т.е. содержащими несколько простых условий. Множественные условия можно создавать посредством логических операторов AND, OR и NOT.
При соединении условий оператором AND возвращаются только те строки, которые удовлетворяют обоим условиям. При соединении двух условий оператором OR возвращаются все строки таблицы, которые удовлетворяют одному или обоим этим условиям, как показано в примере ниже:
В этом примере происходит выборка номеров сотрудников, которые работают над проектом p1 или p2 (или над обоими). Результат выполнения этого запроса:

Результаты выполнения этого примера содержат дубликаты значений столбца Id. Эту избыточную информацию можно устранить с помощью ключевого слова DISTINCT, как показано в следующем примере:
Результат выполнения модифицированного кода:

Обратите внимание, что опцию DISTINCT можно использовать только один раз в списке выбора, и она должна предшествовать всем именам столбцов. Поэтому, код в примере ниже ошибочен:
Результатом выполнения этого запроса будет сообщение об ошибке, выданное сервером:
Если список выбора содержит больше, чем один столбец, то предложение DISTINCT выводит все строки с разными комбинациями значений столбцов.
Предложение WHERE может содержать любое число одинаковых или разных логических операций. Следует помнить, что логические операторы имеют разный приоритет выполнения: оператор NOT имеет самый высший приоритет, далее идет оператор AND, а оператор OR имеет самый низший приоритет. Неправильное размещение логических операторов может дать непредвиденные результаты, как это показано в примере ниже:
Результат выполнения этих запросов:

Как можно видеть, эти два кажущиеся одинаковыми запроса SELECT выдают два разных результирующих набора данных. В первой инструкции SELECT система сначала вычисляет оба оператора AND (слева направо), а потом вычисляет оператор OR. Во второй же инструкции SELECT порядок выполнения операторов изменен вследствие использования скобок, операторы в скобках выполняются первыми, в порядке слева направо. Как можно видеть, первая инструкция возвратила одну строку, тогда как вторая не возвратила ни одной.
Наличие логических операторов в предложении WHERE усложняет содержащую его инструкцию SELECT и способствует появлению в ней ошибок. В таких случаях настоятельно рекомендуется применять скобки, даже если они не являются необходимыми. Применение скобок значительно улучшает читаемость инструкции SELECT и уменьшает возможность появления в ней ошибок. Далее приводится первый вариант инструкции SELECT из примера выше, модифицированной в соответствии с этой рекомендацией:
Третий логический оператор NOT изменяет логическое значение, к которому он применяется, на противоположное. Это означает, что отрицание истинного значения (true) дает ложь (false) и наоборот. Отрицание значения NULL также дает NULL. Ниже демонстрируется использование оператора отрицания NOT:
В этом примере происходит выборка табельных номеров и имен сотрудников, не принадлежащих к отделу d2. В данном случае логический оператор NOT можно заменить логическим оператором сравнения <> (не равно).
Операторы IN и BETWEEN
Оператор IN позволяет указать одно или несколько выражений, по которым следует выполнять поиск в запросе. Результатом выражения будет истина (true), если значение соответствующего столбца равно одному из условий, указанных в предикате IN. В примере ниже демонстрируется использование оператора IN:
В этом примере происходит выборка всех столбцов сотрудников, чей табельный номер равен 10102, 28559 или 25348. Результат выполнения этого запроса будет следующим:

Оператор IN равнозначен последовательности условий, соединенных операторами OR. (Число операторов OR на один меньше, чем количество выражений в списке оператора IN.)
Оператор IN можно использовать совместно с логическим оператором NOT, как показано в примере ниже. В данном случае запрос выбирает все строки, не содержащие ни одного из указанных значений в соответствующих столбцах:
Результат выполнения этого запроса:

В отличие от оператора IN, для которого указываются отдельные значения, для оператора BETWEEN указывается диапазон значений, чьи границы определяются нижним и верхним значениями. Использование оператора BETWEEN показано в примере ниже:
В этом примере происходит выборка наименований проектов и бюджетов всех проектов с бюджетом, находящимся в диапазоне от $95 000 и до $120 000 включительно.
Оператор BETWEEN возвращает все значения в указанном диапазоне, включая значения для границ; т.е. приемлемые значения могут быть между значениями указанных границ диапазона или быть равными значениям этих границ.
Оператор BETWEEN логически эквивалентен двум отдельным сравнениям, соединенным логическим оператором AND. Поэтому запрос, приведенный в примере выше, эквивалентен запросу:
Подобно оператору BETWEEN, оператор NOT BETWEEN можно использовать для выборки значений, находящихся за пределами указанного диапазона значений. Оператор BETWEEN также можно применять со значениями, которые имеют символьный или временной тип данных.
В примере ниже показаны две разные формы запроса SELECT, которые дают одинаковые результаты:
В этом примере происходит выборка всех проектов с бюджетом меньшим, чем $99 000 и большим, чем $150 000. Формулировка требования запроса: «Выбрать наименования всех проектов с бюджетом меньшим, чем $99 000 и имена всех проектов с бюджетом большим, чем $150 000» может навести на мысль, что во втором запросе SELECT требуется применить логический оператор AND. Но логический смысл запроса требует применения оператора OR, т.к. использование оператора AND не даст никаких результатов вообще. Это потому, что не может бюджет быть одновременно и меньшим, чем $99 000 и большим, чем $150 000. Но это и является ответом, почему используется оператор OR, а не AND, поскольку мы выбираем все проекты, бюджет которых меньше $99 000 или больше $150 000.
Запросы, связанные со значением NULL
Параметр NULL в инструкции CREATE TABLE указывает, что соответствующий столбец может содержать специальное значение NULL (которое обычно представляет неизвестное или неприменимое значение). Значения NULL отличаются от всех других значений базы данных. Предложение WHERE инструкции SELECT обычно возвращает строки, удовлетворяющие указанным в нем условиям сравнения. Но здесь возникает вопрос, как будут оцениваться в этих сравнениях значения NULL?
Все сравнения со значением NULL возвращают false, даже если им предшествует оператор NOT. Для выборки строк, содержащих значения NULL, в языке Transact-SQL применяется оператор IS NULL. Указание в предложении WHERE строк, содержащих (или не содержащих) значение NULL, имеет следующую общую форму:
Использование оператора IS NULL демонстрируется в примере ниже:
В этом примере происходит выборка табельных номеров служащих и соответствующих номеров проектов для служащих, чья должность неизвестна и которые работают над проектом p2. В следующем примере демонстрируется синтаксически правильное, но логически неправильное использование сравнения с NULL. Причиной ошибки является то обстоятельство, что сравнение любого значения, включая NULL, с NULL возвращает false:
Выполнение этого запроса не возвращает никаких строк. Условие «column IS NOT NULL» эквивалентно условию «NOT (column IS NULL)». Системная функция ISNULL позволяет отображать указанное значение вместо значения NULL:
Результат выполнения этого запроса:

В примере выше для столбца должностей Job в результате запроса используется заголовок ‘task’.
Оператор LIKE
Оператор LIKE используется для сопоставления с образцом, т.е. он сравнивает значения столбца с указанным шаблоном. Столбец может быть любого символьного типа данных или типа дата. Общая форма оператора LIKE выглядит таким образом:
Параметр ‘pattern’ может быть строковой константой, или константой даты, или выражением (включая столбцы таблицы), и должен быть совместимым с типом данных соответствующего столбца. Для указанного столбца сравнение значения строки и шаблона возвращает true, если значение совпадает с выражением шаблона.
Определенные применяемые в шаблоне символы, называющиеся подстановочными символами (wildcard characters), имеют специальное значение. Рассмотрим два из этих символов:
% (знак процента) — обозначает последовательность любых символов любой длины;
_ (символ подчеркивания) — обозначает любой один символ.
Использование подстановочных символов % и _ показано в примере ниже:
В этом примере происходит выборка имен, фамилий и табельных номеров сотрудников, у которых второй буквой имени является буква «а». Результат выполнения этого запроса:

Кроме знака процентов и символа подчеркивания, поддерживает другие специальные символы, применяемые с оператором LIKE. Использование этих символов ([, ] и ^) демонстрируется в примерах ниже:
В этом примере происходит выборка данных сотрудников, чье имя начинается с символа в диапазоне от «В» до «И». Результат выполнения этого запроса:

Как можно видеть по результатам примера, квадратные скобки [] ограничивают диапазон или список символов. Порядок отображения символов диапазона определяется порядком сортировки, указанным при установке системы.
Символ ^ обозначает отрицание диапазона или списка символов. Но такое значение этот символ имеет только тогда, когда находится внутри квадратных скобок, как показано в примере ниже. В данном примере запроса осуществляется выборка имен и фамилий тех сотрудников, чьи имена начинаются с буквы отличной от В-И, П-Я:
В примере ниже демонстрируется использование оператора LIKE совместно с отрицанием NOT:
Здесь выбираются все столбцы сотрудников, чьи имена начинаются на буквы, отличные от букв в диапазоне ‘А-И’.
Любой подстановочный символ (%, _, [, ] или ^), заключенный в квадратные скобки, остается обычным символом и представляет сам себя. Такая же возможность существует при использовании параметра ESCAPE. Поэтому оба варианта применения инструкции SELECT, показанные в примере ниже, эквивалентны:
Результат выполнения этих двух инструкций SELECT будет одинаковым. В этом примере обе инструкции SELECT рассматривают символ подчеркивания в значениях столбца FirstName, как таковой, а не как подстановочный. В первой инструкции SELECT это достигается заключением символа подчеркивания в квадратные скобки. А во второй инструкции SELECT этот же эффект достигается за счет применения символа перехода (escape character), каковым в данном случае является символ восклицательного знака. Символ перехода переопределяет значение символа подчеркивания, делая его из подстановочного символа обычным. (Результат выполнения этих инструкций содержит ноль строк, потому что ни одно имя сотрудника не содержит символов подчеркивания.)
Стандарт SQL поддерживает только подстановочные символы %, _ и оператор ESCAPE. Поэтому если требуется представить подстановочный символ как обычный символ, то вместо квадратных скобок рекомендуется применять оператор ESCAPE.
Учебник по языку SQL (DDL, DML) на примере диалекта MS SQL Server. Часть вторая
Вступление и DDL – Data Definition Language (язык описания данных)
DML – Data Manipulation Language (язык манипулирования данными)
В первой части мы уже немного затронули язык DML, применяя почти весь набор его команд, за исключением команды MERGE.
Рассказывать про DML я буду по своей последовательности выработанной на личном опыте. По ходу, так же постараюсь рассказать про «скользкие» места, на которые стоит акцентировать внимание, эти «скользкие» места, схожи во многих диалектах языка SQL.
Т.к. учебник посвящается широкому кругу читателей (не только программистам), то и объяснение, порой будет соответствующее, т.е. долгое и нудное. Это мое видение материала, которое в основном получено на практике в результате профессиональной деятельности.
Основная цель данного учебника, шаг за шагом, выработать полное понимание сути языка SQL и научить правильно применять его конструкции. Профессионалам в этой области, может тоже будет интересно пролистать данный материал, может и они смогут вынести для себя что-то новое, а может просто, будет полезно почитать в целях освежить память. Надеюсь, что всем будет интересно.
Т.к. DML в диалекте БД MS SQL очень сильно связан с синтаксисом конструкции SELECT, то я начну рассказывать о DML именно с нее. На мой взгляд конструкция SELECT является самой главной конструкцией языка DML, т.к. за счет нее или ее частей осуществляется выборка необходимых данных из БД.
- SELECT – выборка данных
- INSERT – вставка новых данных
- UPDATE – обновление данных
- DELETE – удаление данных
- MERGE – слияние данных
В данной части, мы рассмотрим, только базовый синтаксис команды SELECT, который выглядит следующим образом:
Тема оператора SELECT очень обширная, поэтому в данной части я и остановлюсь только на его базовых конструкциях. Я считаю, что, не зная хорошо базы, нельзя приступать к изучению более сложных конструкций, т.к. дальше все будет крутиться вокруг этой базовой конструкции (подзапросы, объединения и т.д.).
Также в рамках этой части, я еще расскажу о предложении TOP. Это предложение я намерено не указал в базовом синтаксисе, т.к. оно реализуется по-разному в разных диалектах языка SQL.
Если язык DDL больше статичен, т.е. при помощи него создаются жесткие структуры (таблицы, связи и т.п.), то язык DML носит динамический характер, здесь правильные результаты вы можете получить разными путями.
Обучение так же будет продолжаться в режиме Step by Step, т.е. при чтении нужно сразу же своими руками пытаться выполнить пример. После делаете анализ полученного результата и пытаетесь понять его интуитивно. Если что-то остается непонятным, например, значение какой-нибудь функции, то обращайтесь за помощью в интернет.
Примеры будут показываться на БД Test, которая была создана при помощи DDL+DML в первой части.
Для тех, кто не создавал БД в первой части (т.к. не всех может интересовать язык DDL), может воспользоваться следующим скриптом:
Все, теперь мы готовы приступить к изучению языка DML.
SELECT – оператор выборки данных
Первым делом, для активного редактора запроса, сделаем текущей БД Test, выбрав ее в выпадающем списке или же командой «USE Test».
Начнем с самой элементарной формы SELECT:
В данном запросе мы просим вернуть все столбцы (на это указывает «*») из таблицы Employees – можно прочесть это как «ВЫБЕРИ все_поля ИЗ таблицы_сотрудники». В случае наличия кластерного индекса, возвращенные данные, скорее всего будут отсортированы по нему, в данном случае по колонке ID (но это не суть важно, т.к. в большинстве случаев сортировку мы будем указывать в явном виде сами при помощи ORDER BY …):
| ID | Name | Birthday | PositionID | DepartmentID | HireDate | ManagerID | |
|---|---|---|---|---|---|---|---|
| 1000 | Иванов И.И. | 1955-02-19 | i.ivanov@test.tt | 2 | 1 | 2015-04-08 | NULL |
| 1001 | Петров П.П. | 1983-12-03 | p.petrov@test.tt | 3 | 3 | 2015-04-08 | 1003 |
| 1002 | Сидоров С.С. | 1976-06-07 | s.sidorov@test.tt | 1 | 2 | 2015-04-08 | 1000 |
| 1003 | Андреев А.А. | 1982-04-17 | a.andreev@test.tt | 4 | 3 | 2015-04-08 | 1000 |
Вообще стоит сказать, что в диалекте MS SQL самая простая форма запроса SELECT может не содержать блока FROM, в этом случае вы можете использовать ее, для получения каких-то значений:
| (No column name) | (No column name) | (No column name) |
|---|---|---|
| 825 | 2015-04-11 12:12:36.0406743 | 1 |
Обратите внимание, что выражение (5550/100*15) дало результат 825, хотя если мы посчитаем на калькуляторе получится значение (832.5). Результат 825 получился по той причине, что в нашем выражении все числа целые, поэтому и результат целое число, т.е. (5550/100) дает нам 55, а не (55.5).
- Целое / Целое = Целое (т.е. в данном случае происходит целочисленное деление)
- Вещественное / Целое = Вещественное
- Целое / Вещественное = Вещественное
Здесь (123.) = (123.0), просто в данном случае 0 можно отбросить и оставить только точку.
При других арифметических операциях действует та же самая логика, просто в случае деления этот нюанс более актуален.
Поэтому обращайте внимание на тип данных числовых столбцов. В том случае если он целый, а результат вам нужно получить вещественный, то используйте преобразование, либо просто ставьте точку после числа указанного в виде константы (123.).
Для преобразования полей можно использовать функцию CAST или CONVERT. Для примера воспользуемся полем ID, оно у нас типа int:
| ID | (No column name) | (No column name) | (No column name) | (No column name) |
|---|---|---|---|---|
| 1000 | 10 | 10 | 10 | 10.000000 |
| 1001 | 10 | 10.01 | 10.01 | 10.010000 |
| 1002 | 10 | 10.02 | 10.02 | 10.020000 |
| 1003 | 10 | 10.03 | 10.03 | 10.030000 |
На заметку. В БД ORACLE синтаксис без блока FROM недопустим, там для этой цели используется системная таблица DUAL, которая содержит одну строку:
Примечание. Имя таблицы во многих РБД может предваряться именем схемы:
Схема – это логическая единица БД, которая имеет свое наименование и позволяет сгруппировать внутри себя объекты БД такие как таблицы, представления и т.д.
Определение схемы в разных БД может отличатся, где-то схема непосредственно связанна с пользователем БД, т.е. в данном случае можно сказать, что схема и пользователь – это синонимы и все создаваемые в схеме объекты по сути являются объектами данного пользователя. В MS SQL схема – это независимая логическая единица, которая может быть создана сама по себе (см. CREATE SCHEMA).
По умолчанию в базе MS SQL создается одна схема с именем dbo (Database Owner) и все создаваемые объекты по умолчанию создаются именно в данной схеме. Соответственно, если мы в запросе указываем просто имя таблицы, то она будет искаться в схеме dbo текущей БД. Если мы хотим создать объект в конкретной схеме, мы должны будем так же предварить имя объекта именем схемы, например, «CREATE TABLE имя_схемы.имя_таблицы(…)».
В случае MS SQL имя схемы может еще предваряться именем БД, в которой находится данная схема:
- в одном запросе мы обращаемся к объектам расположенных в разных схемах или базах данных
- требуется сделать перенос данных из одной схемы или БД в другую
- находясь в одной БД, требуется запросить данные из другой БД
- и т.п.
Так же не забываем, что в тексте запроса мы можем использовать как однострочные «— …», так и многострочные «/* … */» комментарии. Если запрос большой и сложный, то комментарии могут очень помочь, вам или кому-то другому, через некоторое время, вспомнить или разобраться в его структуре.
Если столбцов в таблице очень много, а особенно, если в таблице еще очень много строк, плюс к тому если мы делаем запросы к БД по сети, то предпочтительней будет выборка с непосредственным перечислением необходимых вам полей через запятую:
Т.е. здесь мы говорим, что нам из таблицы нужно вернуть только поля ID и Name. Результат будет следующим (кстати оптимизатор здесь решил воспользоваться индексом, созданным по полю Name):
| ID | Name |
|---|---|
| 1003 | Андреев А.А. |
| 1000 | Иванов И.И. |
| 1001 | Петров П.П. |
| 1002 | Сидоров С.С. |
На заметку. Порой бывает полезным посмотреть на то как осуществляется выборка данных, например, чтобы выяснить какие индексы используются. Это можно сделать если нажать кнопку «Display Estimated Execution Plan – Показать расчетный план» или установить «Include Actual Execution Plan – Включить в результат актуальный план выполнения запроса» (в данном случае мы сможем увидеть уже реальный план, соответственно, только после выполнения запроса):

Анализ плана выполнения очень полезен при оптимизации запроса, он позволяет выяснить каких индексов не хватает или же какие индексы вообще не используются и их можно удалить.
Если вы только начали осваивать DML, то сейчас для вас это не так важно, просто возьмите на заметку и можете спокойно забыть об этом (может это вам никогда и не пригодится) – наша первоначальная цель изучить основы языка DML и научится правильно применять их, а оптимизация это уже отдельное искусство. Порой важнее, чтобы на руках просто был правильно написанный запрос, который возвращает правильные результат с предметной точки зрения, а его оптимизацией уже занимаются отдельные люди. Для начала вам нужно научиться просто правильно писать запросы, используя любые средства для достижения цели. Главная цель которую вы сейчас должны достичь – чтобы ваш запрос возвращал правильные результаты.
Задание псевдонимов для таблиц
При перечислении колонок их можно предварять именем таблицы, находящейся в блоке FROM:
Но такой синтаксис обычно использовать неудобно, т.к. имя таблицы может быть длинным. Для этих целей обычно задаются и применяются более короткие имена – псевдонимы (alias):
Здесь emp – псевдоним для таблицы Employees, который можно будет использоваться в контексте данного оператора SELECT. Т.е. можно сказать, что в контексте этого оператора SELECT мы задаем таблице новое имя.
Конечно, в данном случае результаты запросов будут точно такими же как и для «SELECT ID,Name FROM Employees». Для чего это нужно будет понятно дальше (даже не в этой части), пока просто запоминаем, что имя колонки можно предварять (уточнять) либо непосредственно именем таблицы, либо при помощи псевдонима. Здесь можно использовать одно из двух, т.е. если вы задали псевдоним, то и пользоваться нужно будет им, а использовать имя таблицы уже нельзя.
DISTINCT – отброс строк дубликатов
Ключевое слово DISTINCT используется для того чтобы отбросить из результата запроса строки дубликаты. Грубо говоря представьте, что сначала выполняется запрос без опции DISTINCT, а затем из результата выбрасываются все дубликаты. Продемонстрируем это для большей наглядности на примере:
Наглядно это будет выглядеть следующим образом (все дубликаты помечены одним цветом):
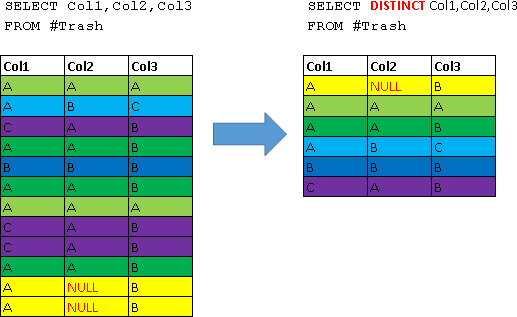
Теперь давайте рассмотрим где это можно применить, на более практичном примере – вернем из таблицы Employees только уникальные идентификаторы отделов (т.е. узнаем ID отделов в которых числятся сотрудники):
| DepartmentID |
|---|
| 1 |
| 2 |
| 3 |
Здесь мы получили три строки, т.к. 2 сотрудника у нас числятся в одном отделе (ИТ).
Теперь узнаем в каких отделах, какие должности фигурируют:
| DepartmentID | PositionID |
|---|---|
| 1 | 2 |
| 2 | 1 |
| 3 | 3 |
| 3 | 4 |
Здесь мы получили 4 строчки, т.к. повторяющихся комбинаций (DepartmentID, PositionID) в нашей таблице нет.
Ненадолго вернемся к DDL
Так как данных для демонстрационных примеров начинает не хватать, а рассказать хочется более обширно и понятно, то давайте чуть расширим нашу таблицу Employess. К тому же немного вспомним DDL, как говорится «повторение – мать учения», и плюс снова немного забежим вперед и применим оператор UPDATE:
Убедимся, что данные обновились успешно:
| ID | Name | … | LastName | FirstName | MiddleName | Salary | BonusPercent |
|---|---|---|---|---|---|---|---|
| 1000 | Иванов И.И. | Иванов | Иван | Иванович | 5000 | 50 | |
| 1001 | Петров П.П. | Петров | Петр | Петрович | 1500 | 15 | |
| 1002 | Сидоров С.С. | Сидоров | Сидор | NULL | 2500 | NULL | |
| 1003 | Андреев А.А. | Андреев | Андрей | NULL | 2000 | 30 |
Задание псевдонимов для столбцов запроса
Думаю, здесь будет проще показать, чем написать:
| ФИО | Дата приема | Дата рождения | ZP |
|---|---|---|---|
| Иванов Иван Иванович | 2015-04-08 | 1955-02-19 | 5000 |
| Петров Петр Петрович | 2015-04-08 | 1983-12-03 | 1500 |
| NULL | 2015-04-08 | 1976-06-07 | 2500 |
| NULL | 2015-04-08 | 1982-04-17 | 2000 |
Как видим заданные нами псевдонимы столбцов, отразились в заголовке результирующей таблицы. Собственно, это и есть основное предназначение псевдонимов столбцов.
Обратите внимание, т.к. у последних 2-х сотрудников не указано отчество (NULL значение), то результат выражения «LastName+’ ‘+FirstName+’ ‘+MiddleName» так же вернул нам NULL.
Для соединения (сложения, конкатенации) строк в MS SQL используется символ «+».
Запомним, что все выражения в которых участвует NULL (например, деление на NULL, сложение с NULL) будут возвращать NULL.
На заметку.
В случае ORACLE для объединения строк используется оператор «||» и конкатенация будет выглядеть как «LastName||’ ‘||FirstName||’ ‘||MiddleName». Для ORACLE стоит отметить, что у него для строковых типов есть исключение, для них NULL и пустая строка » это одно и тоже, поэтому в ORACLE такое выражение вернет для последних 2-х сотрудников «Сидоров Сидор » и «Андреев Андрей ». На момент версии ORACLE 12c, насколько я знаю, опции которая изменяет такое поведение нет (если не прав, прошу поправить меня). Здесь мне сложно судить хорошо это или плохо, т.к. в одних случаях удобнее поведение NULL-строки как в MS SQL, а в других как в ORACLE.
В ORACLE тоже допустимы все перечисленные выше псевдонимы столбцов, кроме […].
Для того чтобы не городить конструкцию с использованием функции ISNULL, в MS SQL мы можем применить функцию CONCAT. Рассмотрим и сравним 3 варианта:
| FullName1 | FullName2 | FullName3 |
|---|---|---|
| Иванов Иван Иванович | Иванов Иван Иванович | Иванов Иван Иванович |
| Петров Петр Петрович | Петров Петр Петрович | Петров Петр Петрович |
| NULL | Сидоров Сидор | Сидоров Сидор |
| NULL | Андреев Андрей | Андреев Андрей |
В MS SQL псевдонимы еще можно задавать при помощи знака равенства:
Использовать для задания псевдонима ключевое слово AS или же знак равенства, наверное, больше дело вкуса. Но при разборе чужих запросов, данные знания могут пригодиться.
Напоследок скажу, что для псевдонимов имена лучше задавать, используя только символы латиницы и цифры, избегая применения ‘…’, "…" и […], то есть использовать те же правила, что мы использовали при наименовании таблиц. Дальше, в примерах я буду использовать только такие наименования и никаких ‘…’, "…" и […].
Основные арифметические операторы SQL
| Оператор | Действие |
|---|---|
| + | Сложение (x+y) или унарный плюс (+x) |
| — | Вычитание (x-y) или унарный минус (-x) |
| * | Умножение (x*y) |
| / | Деление (x/y) |
| % | Остаток от деления (x%y). Для примера 15%10 даст 5 |
Приоритет выполнения арифметических операторов такой же, как и в математике. Если необходимо, то порядок применения операторов можно изменить используя круглые скобки — (a+b)*(x/(y-z)).
И еще раз повторюсь, что любая операция с NULL дает NULL, например: 10+NULL, NULL*15/3, 100/NULL – все это даст в результате NULL. Т.е. говоря просто неопределенное значение не может дать определенный результат. Учитывайте это при составлении запроса и при необходимости делайте обработку NULL значений функциями ISNULL, COALESCE:
| ID | Name | Result1 | Result2 | Result3 |
|---|---|---|---|---|
| 1000 | Иванов И.И. | 2500 | 2500 | 2500 |
| 1001 | Петров П.П. | 225 | 225 | 225 |
| 1002 | Сидоров С.С. | NULL | 0 | 0 |
| 1003 | Андреев А.А. | 600 | 600 | 600 |
| 1004 | Николаев Н.Н. | NULL | 0 | 0 |
| 1005 | Александров А.А. | NULL | 0 | 0 |
Немного расскажу о функции COALESCE:
В основном, я сосредоточусь на рассказе конструкций языка DML и по большей части не буду рассказывать о функциях, которые будут встречаться в примерах. Если вам непонятно, что делает та или иная функция поищите ее описание в интернет, можете даже поискать информацию сразу по группе функций, например, задав в поиске Google «MS SQL строковые функции», «MS SQL математические функции» или же «MS SQL функции обработки NULL». Информации по функциям очень много, и вы ее сможете без труда найти. Для примера, в библиотеке MSDN, можно узнать больше о функции COALESCE:
Вырезка из MSDN Сравнение COALESCE и CASE
Выражение COALESCE — синтаксический ярлык для выражения CASE. Это означает, что код COALESCE(expression1. n) переписывается оптимизатором запросов как следующее выражение CASE:
Для примера рассмотрим, как можно воспользоваться остатком от деления (%). Данный оператор очень полезен, когда требуется разбить записи на группы. Например, вытащим всех сотрудников, у которых четные табельные номера (ID), т.е. те ID, которые делятся на 2:
| ID | Name |
|---|---|
| 1000 | Иванов И.И. |
| 1004 | Николаев Н.Н. |
| 1002 | Сидоров С.С. |
ORDER BY – сортировка результата запроса
Предложение ORDER BY используется для сортировки результата запроса.
| LastName | FirstName | Salary |
|---|---|---|
| Андреев | Андрей | 2000 |
| Иванов | Иван | 5000 |
| Петров | Петр | 1500 |
| Сидоров | Сидор | 2500 |
После имя поля в предложении ORDER BY можно задать опцию DESC, которая служит для сортировки этого поля в порядке убывания:
| LastName | FirstName | Salary |
|---|---|---|
| Иванов | Иван | 5000 |
| Сидоров | Сидор | 2500 |
| Андреев | Андрей | 2000 |
| Петров | Петр | 1500 |
Стоит отметить, что в предложении ORDER BY можно использовать и поля, которые не перечислены в предложении SELECT (кроме случая, когда используется DISTINCT, об этом случае я расскажу ниже). Для примера забегу немного вперед используя опцию TOP и покажу, как например, можно отобрать 3-х сотрудников у которых самая высокая ЗП, с учетом что саму ЗП в целях конфиденциальности я показывать не должен:
| ID | LastName | FirstName |
|---|---|---|
| 1000 | Иванов | Иван |
| 1002 | Сидоров | Сидор |
Конечно здесь есть случай, что у нескольких сотрудников может быть одинаковая ЗП и тут сложно сказать каких именно трех сотрудников вернет данный запрос, это уже нужно решать с постановщиком задачи. Допустим, после обсуждения с постановщиком данной задачи, вы согласовали и решили использовать следующий вариант – сделать дополнительную сортировку по полю даты рождения (т.е. молодым у нас дорога), а если и дата рождения у нескольких сотрудников может совпасть (ведь такое тоже не исключено), то можно сделать третью сортировку по убыванию значений ID (в последнюю очередь под выборку попадут те, у кого ID окажется максимальным – например, те кто был принят последним, допустим табельные номера у нас выдаются последовательно):
Т.е. вы должны стараться чтобы результат запроса был предсказуемым, чтобы вы могли в случае разбора полетов объяснить почему в «черный список» попали именно эти люди, т.е. все было выбрано честно, по утверждённым правилам.
Сортировать можно так же используя разные выражения в предложении ORDER BY:
Так же в ORDER BY можно использовать псевдонимы заданные для колонок:
Стоит отметить что в случае использования предложения DISTINCT, в предложении ORDER BY могут использоваться только колонки, перечисленные в блоке SELECT. Т.е. после применения операции DISTINCT мы получаем новый набор данных, с новым набором колонок. По этой причине, следующий пример не отработает:
Т.е. предложение ORDER BY применяется уже к итоговому набору, перед выдачей результата пользователю.
Примечание 1. Так же в предложении ORDER BY можно использовать номера столбцов, перечисленных в SELECT:
Для начинающих выглядит удобно и заманчиво, но лучше забыть и никогда не использовать такой вариант сортировки.
Если в данном случае (когда поля явно перечислены), такой вариант еще допустим, то для случая с использованием «*» такой вариант лучше никогда не применять. Почему – потому что, если кто-то, например, поменяет в таблице порядок столбцов, или удалит столбцы (и это нормальная ситуация), ваш запрос может так же работать, но уже неправильно, т.к. сортировка уже может идти по другим столбцам, и это коварно тем что данная ошибка может обнаружиться очень нескоро.
В случае, если бы столбы были явно перечислены, то в вышеуказанной ситуации, запрос либо бы продолжал работать, но также правильно (т.к. все явно определено), либо бы он просто выдал ошибку, что данного столбца не существует.
Так что можете смело забыть, о сортировке по номерам столбцов.
Примечание 2.
В MS SQL при сортировке по возрастанию NULL значения будут отображаться первыми.
Соответственно при использовании DESC они будут в конце
Если необходимо поменять логику сортировки NULL значений, то используйте выражения, например:
В ORACLE для этой цели предусмотрены 2 опции NULLS FIRST и NULLS LAST (применяется по умолчанию). Например:
Обращайте на это внимание при переходе на ту или иную БД.
TOP – возврат указанного числа записей
Обычно данное выражение используется с предложением ORDER BY и мы уже смотрели примеры, когда нужно было вернуть N-первых строк из результирующего набора.
Без ORDER BY обычно данное предложение применяется, когда нужно просто посмотреть на неизвестную нам таблицу, в которой может быть очень много записей, в этом случае мы можем, для примера, попросить вернуть нам только первые 10 строк, но для наглядности мы скажем только 2:
Так же можно указать слово PERCENT, для того чтобы вернулось соответствуй процент строк из результирующего набора:
На моей практике чаше применяется именно выборка по количеству строк.
Так же с TOP можно использовать опцию WITH TIES, которая поможет вернуть все строки в случае неоднозначной сортировки, т.е. это предложение вернет все строки, которые равны по составу строкам, которые попадают в выборку TOP N, в итоге строк может быть выбрано больше чем N. Давайте для демонстрации добавим еще одного «Программиста» с окладом 1500:
и введем еще одного сотрудника без указания должности и отдела с окладом 2000:
Теперь давайте выберем при помощи опции WITH TIES всех сотрудников, у которых оклад совпадает с окладами 3-х сотрудников, с самым маленьким окладом (надеюсь дальше будет понятно, к чему я клоню):
Здесь хоть и указано TOP 3, но запрос вернул 4 записи, т.к. значение Salary которое вернуло TOP 3 (1500 и 2000) оказалось у 4-х сотрудников. Наглядно это работает примерно следующим образом:
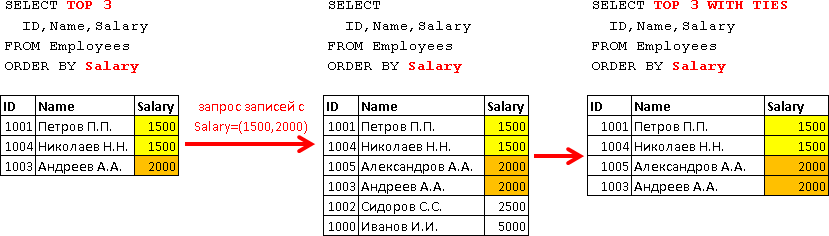
На заметку.
В разных БД TOP реализуется разными способами, в MySQL для этого есть предложение LIMIT, в котором дополнительно можно задать начальное смещение.
В ORACLE 12c, тоже ввели свой аналог совмещающий функциональность TOP и LIMIT – ищите по словам «ORACLE OFFSET FETCH». До версии 12c для этой цели обычно использовался псевдостолбец ROWNUM.
А что же будет если применить одновременно предложения DISTINCT и TOP? На такие вопросы легко ответить, проводя эксперименты. В общем, не бойтесь и не ленитесь экспериментировать, т.к. большая часть познается именно на практике. Порядок слов в операторе SELECT следующий, первым идет DISTINCT, а после него идет TOP, т.е. если рассуждать логически и читать слева-направо, то первым применится отброс дубликатов, а потом уже по этому набору будет сделан TOP. Что-ж проверим и убедимся, что так и есть:
| Salary |
|---|
| 1500 |
| 2000 |
Т.е. в результате мы получили 2 самые маленькие зарплаты из всех. Конечно может быть случай что ЗП для каких-то сотрудников может быть не указанной (NULL), т.к. схема нам это позволяет. Поэтому в зависимости от задачи принимаем решение либо обработать NULL значения в предложении ORDER BY, либо просто отбросить все записи, у которых Salary равна NULL, а для этого переходим к изучению предложения WHERE.
WHERE – условие выборки строк
Данное предложение служит для фильтрации записей по заданному условию. Например, выберем всех сотрудников работающих в «ИТ» отделе (его >
| ID | LastName | FirstName | Salary |
|---|---|---|---|
| 1004 | NULL | NULL | 1500 |
| 1003 | Андреев | Андрей | 2000 |
| 1001 | Петров | Петр | 1500 |
Предложение WHERE пишется до команды ORDER BY.
- WHERE – если указано, то первым делом из всего набора Employees идет отбор только удовлетворяющих условию записей
- DISTINCT – если указано, то отбрасываются все дубликаты
- ORDER BY – если указано, то делается сортировка результата
- TOP – если указано, то из отсортированного результата возвращается только указанное число записей
Рассмотрим для наглядности пример:
Наглядно это будет выглядеть следующим образом:

Стоит отметить, что проверка на NULL делается не знаком равенства, а при помощи операторов IS NULL и IS NOT NULL. Просто запомните, что на NULL при помощи оператора «=» (знак равенства) сравнивать нельзя, т.к. результат выражения будет так же равен NULL.
Например, выберем всех сотрудников, у которых не указан отдел (т.е. DepartmentID IS NULL):
| ID | Name |
|---|---|
| 1005 | Александров А.А. |
Теперь для примера посчитаем бонус для всех сотрудников у которых указано значение BonusPercent (т.е. BonusPercent IS NOT NULL):
Да, кстати, если подумать, то значение BonusPercent может равняться нулю (0), а так же значение может быть внесено со знаком минус, ведь мы не накладывали на данное поле никаких ограничений.
Хорошо, рассказав о проблеме, нам пока сказали считать, что если (BonusPercent<=0 или BonusPercent IS NULL), то это означает что у сотрудника так же нет бонуса. Для начала, как нам сказали, так и сделаем, реализуем это при помощи логического оператора OR и NOT:
Т.е. здесь мы начали изучать булевы операторы. Выражение в скобках «(BonusPercent<=0 OR BonusPercent IS NULL)» проверяет на то что у сотрудника нет бонуса, а NOT инвертирует это значение, т.е. говорит «верни всех сотрудников которые не сотрудники у которых нет бонуса».
Так же данное выражение можно переписать и сразу сказав сразу «верни всех сотрудников, у которых есть бонус» выразив это выражением (BonusPercent>0 и BonusPercent IS NOT NULL):
Также в блоке WHERE можно делать проверку разного рода выражений с применением арифметических операторов и функций. Например, аналогичную проверку можно сделать, использовав выражение с функцией ISNULL:
Булевы операторы и простые операторы сравнения
Да, без математики здесь не обойтись, поэтому сделаем небольшой экскурс по булевым и простым операторам сравнения.
Булевых операторов в языке SQL всего 3 – AND, OR и NOT:
| AND | логическое И. Ставится между двумя условиями (условие1 AND условие2). Чтобы выражение вернуло True, нужно, чтобы истинными были оба условия |
|---|---|
| OR | логическое ИЛИ. Ставится между двумя условиями (условие1 OR условие2). Чтобы выражение вернуло True, достаточно, чтобы истинным было только одно условие |
| NOT | инвертирует условие/логическое_выражение. Накладывается на другое выражение (NOT логическое_выражение) и возвращает True, если логическое_выражение = False и возвращает False, если логическое_выражение = True |
Для каждого булева оператора можно привести таблицы истинности где дополнительно показано какой будет результат, когда условия могут быть равны NULL:
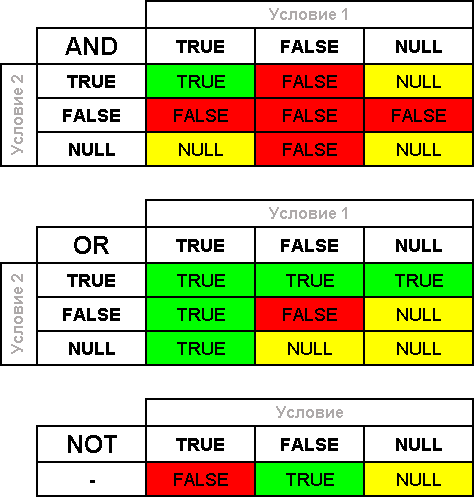
Есть следующие простые операторы сравнения, которые используются для формирования условий:
| Условие | Значение |
|---|---|
| = | Равно |
| < | Меньше |
| > | Больше |
| <= | Меньше или равно |
| >= | Больше или равно |
| <> != |
Не равно |
Плюс имеются 2 оператора для проверки значения/выражения на NULL:
| IS NULL | Проверка на равенство NULL |
|---|---|
| IS NOT NULL | Проверка на неравенство NULL |
Приоритет: 1) Все операторы сравнения; 2) NOT; 3) AND; 4) OR.
При построении сложных логических выражений используются круглые скобки:
Так же при помощи использования круглых скобок, можно изменить стандартную последовательность вычислений.
Здесь я постарался дать представление о булевой алгебре в достаточном для работы объеме. Как видите, чтобы писать условия посложнее без логики уже не обойтись, но ее здесь немного (AND, OR и NOT) и придумывали ее люди, так что все достаточно логично.
Идем к завершению второй части
Как видите даже про базовый синтаксис оператора SELECT можно говорить очень долго, но, чтобы остаться в рамках статьи, напоследок я покажу дополнительные логических операторы – BETWEEN, IN и LIKE.
BETWEEN – проверка на вхождение в диапазон
Этот оператор имеет следующий вид:
В роли значений могут выступать выражения.
Разберем на примере:
| ID | Name | Salary |
|---|---|---|
| 1002 | Сидоров С.С. | 2500 |
| 1003 | Андреев А.А. | 2000 |
| 1005 | Александров А.А. | 2000 |
Собственно, BETWEEN это упрощенная запись вида:
Перед словом BETWEEN может использоваться слово NOT, которое будет осуществлять проверку значения на не вхождение в указанный диапазон:
Соответственно, в случае использования BETWEEN, IN, LIKE вы можете так же объединять их с другими условиями при помощи AND и OR:
IN – проверка на вхождение в перечень значений
Этот оператор имеет следующий вид:
Думаю, проще показать на примере:
| ID | Name | Salary |
|---|---|---|
| 1001 | Петров П.П. | 1500 |
| 1003 | Андреев А.А. | 2000 |
| 1004 | Николаев Н.Н. | 1500 |
Т.е. по сути это аналогично следующему выражению:
В случае NOT это будет аналогично (получим всех кроме тех, кто из отдела 3 и 4):
Так же запрос с NOT IN можно выразить и через AND:
Учтите, что искать NULL значения при помощи конструкции IN не получится, т.к. проверка NULL=NULL вернет так же NULL, а не True:
В этом случае разбивайте проверку на несколько условий:
Или же можно написать что-то вроде:
Думаю, первый вариант, в данном случае будет более правильным и надежным. Ну ладно, это всего лишь пример, для демонстрации того какие еще конструкции можно строить.
Так же стоит упомянуть еще более коварную ошибку, связанную с NULL, которую можно допустить при использовании конструкции NOT IN. Для примера, давайте попробуем выбрать всех сотрудников, кроме тех, у которых отдел равен 1 или у которых отдел вообще не указан, т.е. равен NULL. В качестве решения напрашивается вариант:
Но выполнив запрос, мы не получим ни одной строки, хотя мы ожидали увидеть следующее:
| ID | Name | DepartmentID |
|---|---|---|
| 1001 | Петров П.П. | 3 |
| 1002 | Сидоров С.С. | 2 |
| 1003 | Андреев А.А. | 3 |
| 1004 | Николаев Н.Н. | 3 |
Опять же шутку здесь сыграло NULL указанное в списке значений.
Разберем почему в данном случае возникла логическая ошибка. Разложим запрос при помощи AND:
Правое условие (DepartmentID<>NULL) нам всегда здесь даст неопределенность, т.е. NULL. Теперь вспомним таблицу истинности для оператора AND, где (TRUE AND NULL) дает NULL. Т.е. при выполнении левого условия (DepartmentID<>1) из-за неопределенного правого условия в результате мы получим неопределенное значение всего выражения (DepartmentID<>1 AND DepartmentID<>NULL), поэтому строка не войдет в результат.
Переписать условие правильно можно следующим образом:
IN еще можно использовать с подзапросами, но к такой форме мы вернемся, уже в последующих частях данного учебника.
LIKE – проверка строки по шаблону
Про данный оператор я расскажу только в самом простом виде, который является стандартом и поддерживается большинством диалектов языка SQL. Даже в таком виде при помощи него можно решить много задач, которые требуют выполнить проверку по содержимому строки.
Этот оператор имеет следующий вид:
- Знак подчеркивания «_» — говорит, что на его месте может стоять любой единичный символ
- Знак процента «%» — говорит, что на его месте может стоять сколько угодно символов, в том числе и ни одного
Рассмотрим примеры с символом «_»:
При помощи ESCAPE можно задать отменяющий символ, который отменяет проверяющее действие специальных символов «_» и «%». Данное предложение используется, когда в строке нужно непосредственно проверить наличие знака процента или знака подчеркивания.
Для демонстрации ESCAPE давайте занесем в одну запись мусор:
И посмотрим, что вернут следующие запросы:
В случае, если требуется проверить строку на полное совпадение, то вместо LIKE лучше использовать просто знак «=»:
На заметку.
В MS SQL в шаблоне оператора LIKE так же можно задать поиск по регулярным выражениям, почитайте о нем в интернете, в том случае, если вам станет недостаточно стандартных возможностей данного оператора.
В ORACLE для поиска по регулярным выражениям применяется функция REGEXP_LIKE.
Немного о строках
В случае проверки строки на наличие Unicode символов, нужно будет ставить перед кавычками символ N, т.е. N’…’. Но так как у нас в таблице все символьные поля в формате Unicode (тип nvarchar), то для этих полей можно всегда использовать такой формат. Пример:
Если делать правильно, при сравнении с полем типа varchar (ASCII) нужно стараться использовать проверки с использованием ‘…’, а при сравнении поля с типом nvarchar (Unicode) нужно стараться использовать проверки с использованием N’…’. Это делается для того, чтобы избежать в процессе выполнения запроса неявных преобразований типов. То же самое правило используем при вставке (INSERT) значений в поле или их обновлении (UPDATE).
При сравнении строк стоит учесть момент, что в зависимости от настройки БД (collation), сравнение строк может быть, как регистро-независимым (когда ‘Петров’=’ПЕТРОВ’), так и регистро-зависимым (когда ‘Петров'<>’ПЕТРОВ’).
В случае регистро-зависимой настройки, если требуется сделать поиск без учета регистра, то можно, например, сделать предварительное преобразование правого и левого выражения в один регистр – верхний или нижний:
Немного о датах
При проверке на дату, вы можете использовать, как и со строками одинарные кавычки ‘…’.
Вне зависимости от региональных настроек в MS SQL можно использовать следующий синтаксис дат ‘YYYYMMDD’ (год, месяц, день слитно без пробелов). Такой формат даты MS SQL поймет всегда:
В некоторых случаях, дату удобнее задавать при помощи функции DATEFROMPARTS:
Так же есть аналогичная функция DATETIMEFROMPARTS, которая служит для задания Даты и Времени (для типа datetime).
Еще вы можете использовать функцию CONVERT, если требуется преобразовать строку в значение типа date или datetime:
Значения 104 и 120, указывают какой формат даты используется в строке. Описание всех допустимых форматов вы можете найти в библиотеке MSDN задав в поиске «MS SQL CONVERT».
Функций для работы с датами в MS SQL очень много, ищите «ms sql функции для работы с датами».
Немного о числах и их преобразованиях
Информация этого раздела наверно больше будет полезна ИТ-специалистам. Если вы таковым не являетесь, а ваша цель просто научится писать запросы для получения из БД необходимой вам информации, то такие тонкости вам возможно и не понадобятся, но в любом случае можете бегло пройтись по тексту и взять что-то на заметку, т.к. если вы взялись за изучение SQL, то вы уже приобщаетесь к ИТ.
В отличие от функции преобразования CAST, в функции CONVERT можно задать третий параметр, который отвечает за стиль преобразования (формат). Для разных типов данных может использоваться свой набор стилей, которые могут повлиять на возвращаемый результат. Использование стилей мы уже затрагивали при рассмотрении преобразования строки функцией CONVERT в типы date и datetime.
Подробней про функции CAST, CONVERT и стили можно почитать в MSDN – «Функции CAST и CONVERT (Transact-SQL)»: msdn.microsoft.com/ru-ru/library/ms187928.aspx
Для упрощения примеров здесь будут использованы инструкции языка Transact-SQL – DECLARE и SET.
Конечно, в случае преобразования целого числа в вещественное (которое я привел вначале данного урока, в целях демонстрации разницы между целочисленным и вещественным делением), знание нюансов преобразования не так критично, т.к. там мы делали преобразование целого числа в вещественное (диапазон которого намного больше диапазона целых):
Возможно не стоило указывать способ неявного преобразования, получаемого делением на (1.), т.к. желательно стараться делать явные преобразования, для большего контроля типа получаемого результата. Хотя, в случае, если мы хотим получить результат типа numeric, с указанным количеством цифр после запятой, то мы можем в MS SQL применить трюк с умножением целого значения на (1., 1.0, 1.00 и т.д):
В некоторых случаях детали преобразования могут быть действительно важны, т.к. они влияют на правильность полученного результата, например, в случае, когда делается преобразование числового значения в строку (varchar). Рассмотрим примеры по преобразованию значений типа money и float в varchar:
Как видно из примера, плавающие типы float, real в некоторых случаях действительно могут создать большую погрешность, особенно при перегонке в строку и обратно (такое может быть при разного рода интеграциях, когда данные, например, передаются в текстовых файлах из одной системы в другую).
Если нужно явно контролировать точность до определенного знака, более 4-х, то для хранения данных, порой лучше использовать тип decimal/numeric. Если хватает 4-х знаков, то можно использовать и тип money – он примерно соотвествует numeric(20,4).
Примечание.
С версии MS SQL 2008, можно использовать вместо конструкции:
Более короткий синтаксис инициализации переменных:
Заключение второй части
В этой части, я постарался вспомнить и отразить наиболее важные моменты, касающиеся базового синтаксиса. Базовая конструкция – это костяк, без которого нельзя приступать к изучению более сложных конструкций языка SQL.
Надеюсь, данный материал поможет людям, делающим первые шаги в изучении языка SQL.