Что такое партицирование в sql
Из-за проблем с формированием двоичный дистрибутив MySQL 5.1.12 не содержат NDB Cluster или Partitioning. Пожалуйста, обновитесь до 5.1.14. Если Вы формируете пакет из исходника, Вы можете выполнять выбор конфигурации configure с параметрами —with-ndbcluster и —with-partition .
Эта глава обсуждает определяемое пользователем выделение разделов, как выполнено в MySQL 5.1.
MySQL поддерживает несколько типов выделения разделов, а также подвыделение разделов.
Методы добавления, удаления и изменения разделов в существующих разбитых на разделы таблицах рассмотрены в » 3.3. Управление разделами».
Важно : разбитые на разделы таблицы, созданные в MySQL до версии 5.1.6, не могут читаться версией 5.1.6 или позже. Кроме того, таблица INFORMATION_SCHEMA.TABLES не может использоваться, если такие таблицы присутствуют на сервере 5.1.6. Начиная с MySQL 5.1.7, подходящее предупреждающее сообщение сгенерировано о том, что несовместимые разбитые на разделы таблицы были найдены сервером.
Важно : если Вы используете разбитые на разделы таблицы, которые были созданы в MySQL 5.1.5 или ранее, убедитесь, что изучили список изменений.
Реализация выделения разделов в MySQL 5.1 все еще подвергается изменениям. Дополнительные ресурсы по теме:
Это официальный форум обсуждения для тех, кого заинтересовала технология MySQL выделение разделов. Это показывает объявления и модификации от MySQL разработчиков и других. Это контролируется членами Partitioning Development and Documentation Teams.
MySQL Partitioning Architect and Lead Developer Mikael Ronstr├╢m часто регистрирует статьи относительно работы с выделением разделов MySQL и с кластером MySQL.
Место новостей по MySQL, показывающее MySQL-касающиеся блоги, которые должны быть интересными любому, использующему MySQL.
Двоичная версия MySQL 5.1 теперь доступна с http://dev.mysql.com/downloads/mysql/5.1.html. Однако, для последнего исправления механизма выделения разделов и добавления свойств, Вы можете получать исходник из архива BitKeeper. Чтобы допускать выделению разделов, Вы должны компилировать сервер, используя опцию —with-partition . Если Вы имеете проблемы при компилировании MySQL 5.1 с допускаемым выделением разделов, почитайте форум http://forums.mysql.com/list.php?106 и поищите ответ там.
3.1. Краткий обзор выделения разделов в MySQL
Этот раздел обеспечивает концептуальный краткий обзор выделения разделов в MySQL 5.1.
Стандарт SQL не обеспечивает многого относительно физических аспектов хранения данных. Язык SQL непосредственно предназначен, чтобы работать независимо от любых структур данных или средств, лежащих в основе схем, таблиц, строк или столбцов, с которыми работает. Тем не менее, наиболее продвинутые системы управления базами данных развили некоторые средства определения физического расположения, которое нужно использовать для сохранения специфических частей данных в терминах аппаратных средств или даже файловых систем. В MySQL InnoDB обеспечил понятие пространства таблиц, так что сервер MySQL даже до введения выделения разделов, мог быть сконфигурирован, чтобы использовать различные физические каталоги для сохранения различных баз данных.
Partitioning берет это понятие и продвигает на шаг далее, позволяя Вам распределить части индивидуальных таблиц по файловым системам согласно правилам, которые Вы можете устанавливать в значительной степени так, как необходимо. В действительности, различные части таблицы сохранены как отдельные таблицы в различных местах. Выбранное пользователем правило, которым выполнен раздел данных, известно как функция выделения разделов, которая в MySQL может быть модулем, простым соответствием набору диапазонов или списков, внутренней или линейной хэш-функцией. Функция выбрана согласно типу выделения разделов, определенному пользователем, и берет как параметр значение обеспеченного пользователем выражения. Это выражение может быть целочисленным значением столбца или функция, действующая на один или большее количество значений столбца, и возвращающая целое число. Значение этого выражения передано функции выделения разделов, которая возвращает целочисленное значение, представляющее номер раздела, в котором эта специфическая запись должна быть сохранена. Эта функция должна быть непостоянная и непроизвольная. Это не может содержать любые запросы, но может использовать фактически любое выражение SQL, которое является допустимым в MySQL, поскольку то выражение возвращает положительное целое число меньше, чем MAXVALUE (самое большое возможное положительное целое число). Примеры выделения разделов функций могут быть найдены в обсуждениях выделения разделов позже в этой главе.
Это известно как горизонтальное выделение разделов (horizontal partitioning), то есть различные строки таблицы могут быть назначены к различным физическим разделам. MySQL 5.1 не поддерживает вертикальное выделение разделов (vertical partitioning), в котором различные столбцы таблицы назначены различным физическим разделам. Не имеется никаких планов представить вертикальное выделение разделов в MySQL 5.1.
Выделение разделов включено в -max выпуски MySQL 5.1 (то есть двоичные версии 5.1 -max сформированы с —with-partition ). Если MySQL сформирован с выделением разделов, ничто далее не должно быть выполнено, чтобы допустить это (например, никакие специальные записи не требуются в Вашем файле my.cnf ). Вы можете определять, поддерживает ли сервер выделение разделов посредством команды SHOW VARIABLES типа этого:
Если Вы не видите, что переменная have_partitioning со значением YES перечислена как показано выше в выводе соответствующей SHOW VARIABLES , то Ваша версия MySQL не поддерживает выделение разделов.
До MySQL 5.1.6 эта переменная была именована have_partition_engine (Глюк #16718).
Для создания разбитых на разделы таблиц, Вы можете использовать большинство типов хранения, которые обеспечиваются сервером MySQL. MySQL-выделение разделов выполняется в отдельном уровне и может взаимодействовать с любыми из них. В MySQL 5.1 все разделы той же самой разбитой на разделы таблицы должны использовать тот же самый тип памяти, например, Вы не можете использовать MyISAM для одного раздела, а InnoDB для другого. Однако, не имеется ничего предотвращающего Вас от использования различных типов памяти для различных разбитых на разделы таблиц на том же самом сервере MySQL или даже в той же самой базе данных.
Обратите внимание: : выделение разделов MySQL не может использоваться с типами памяти MERGE или CSV . До MySQL 5.1.6 также было невозможно создать разбитую на разделы таблицу, использующую BLACKHOLE (Глюк #14524). Выделение разделов KEY обеспечивается для использования с NDBCluster , но другие типы определяемого пользователем выделения разделов не обеспечиваются для таблиц Cluster в MySQL 5.1.
Чтобы использовать специфический тип памяти для разбитой на разделы таблицы, необходимо только использовать опцию [STORAGE] ENGINE точно как для не разбитой на разделы таблицы. Однако, Вы должны иметь в виду, что [STORAGE] ENGINE (и другие параметры таблицы) должен быть перечислен прежде, чем любые параметры выделения разделов используются в инструкции CREATE TABLE . Этот пример показывает, как создать таблицу, которая разбита на 6 разделов по hash и использует тип памяти InnoDB :
Обратите внимание, что каждое предложение PARTITION может включать опцию [STORAGE] ENGINE , но в MySQL 5.1 это не имеет никакого эффекта.
Обратите внимание : выделение разделов применяется ко всем данным и индексам таблицы. Вы не можете выделять разделы только данных и не индексы или наоборот, при этом Вы не можете выделять разделы только части таблицы.
Данные и индексы для каждого раздела могут быть назначены к специфическому каталогу, используя опции DATA DIRECTORY и INDEX DIRECTORY для предложения PARTITION инструкции CREATE TABLE , используемой чтобы создать разбитую на разделы таблицу. Кроме того, MAX_ROWS и MIN_ROWS могут использоваться, чтобы определить максимальные и минимальные числа строк, соответственно, которые могут быть сохранены в каждом разделе таблицы.
Некоторые из преимуществ выделения разделов:
Можно сохранять большее количество данных в одной таблице, чем может быть записано на одиночном диске или файловой системе.
Данные, которые теряют полноценность, часто легко могут быть удалены из таблицы, удаляя раздел, содержащий только эти данные. Наоборот, процесс добавления новых данных в некоторых случаях может быть значительно облегчен, добавляя новый раздел специально для этих данных.
Некоторые запросы могут быть значительно оптимизированы в том, что данные, удовлетворяющие предложению WHERE могут быть сохранены только на одном или большем количестве разделов, таким образом исключая любые остающиеся разделы из поиска. Поскольку разделы могут быть изменены после того, как разбитая на разделы таблица была создана, Вы можете реорганизовать данные, чтобы расширить частые запросы, которые, возможно, были медленными, когда схема выделения разделов была сначала установлена. Эта возможность, иногда упоминаемая как сокращение раздела (partition pruning), была выполнена в MySQL 5.1.6.
Другие выгоды, обычно связываемые с выделением разделов, включены в следующий список. Эти свойства в настоящее время не выполнены в MySQL Partitioning, но высоки в списке приоритетов.
Запросы, включающие составные функции типа SUM() и COUNT() , легко могут быть распараллелены. Простым примером такого запроса мог бы быть SELECT salesperson_id, COUNT(orders) as order_total FROM sales GROUP BY salesperson_id; . Запрос может быть выполнен одновременно на каждом разделе, и результат получен просто суммируя результаты, полученные для всех разделов.
Достижение большей производительности запроса благодаря разбросу данных по разным дискам.
3.2. Типы раздела
Этот раздел обсуждает типы выделения разделов, которые доступны в MySQL 5.1. Они включают:
RANGE partitioning : назначает строки разделам, основанным на значениях столбца, попадающих внутрь заданного диапазона.
LIST partitioning : подобно выделению разделов диапазоном, за исключением того, что раздел выбран основанным на столбцах, соответствующих одному из набора дискретных значений.
HASH partitioning : раздел выбран основанным на значении, возвращенном определяемым пользователем выражением, которое функционирует на значениях столбца в строках, которые будут вставлены в таблицу. Функция может состоять из любого выражения, допустимого в MySQL, которое выдает не отрицательное целочисленное значение.
KEY partitioning : подобно выделению разделов hash, за исключением того, что обеспечены только один или большее количество столбцов, которые будут оценены, и сервер MySQL обеспечивает собственную хэш-функцию. Эти столбцы могут содержать не целочисленные значения, так как хэш-функция, обеспеченная MySQL, гарантирует целочисленный результат, независимо от типа данных столбца.
Очень общее использование выделения разделов базы данных должно выделять данные по времени. Некоторые системы баз данных поддерживают явное выделение разделов даты, которое MySQL не выполняет в 5.1. Однако, нетрудно создать в MySQL схемы выделения разделов, основанные на столбцах DATE , TIME , DATETIME или на выражениях, использующих такие столбцы.
При выделении разделов KEY или LINEAR KEY , Вы можете использовать столбец DATE , TIME или DATETIME как столбец выделения разделов без того, чтобы выполнить любую модификацию значения столбца. Например, эта инструкция создания таблицы совершенно допустима в MySQL:
Другие типы выделения разделов MySQL, однако, требуют выражения выделения разделов, которое выдает целочисленное значение или NULL . Если Вы желаете использовать дата-основанное выделение разделов RANGE , LIST , HASH или LINEAR HASH , Вы можете просто использовать функцию, которая функционирует на столбце DATE , TIME или DATETIME и возвращает такое значение, как показано здесь:
Выделение разделов в MySQL оптимизирован для использования с функциям. TO_DAYS() и YEAR() . Однако, Вы можете использовать другие функции даты и времени, которые возвращают целое число или NULL , типа WEEKDAY() , DAYOFYEAR() или MONTH() .
Важно помнить, что независимо от типа выделения разделов, которое Вы используете, разделы всегда нумеруются автоматически и в той последовательности, в какой созданы, при старте с 0. Когда новая строка вставлена в разбитую на разделы таблицу, это числа раздела, которые используются в идентификации правильного раздела. Например, если Ваша таблица использует 4 раздела, эти разделы пронумерованы 0 , 1 , 2 и 3 . Для типов разделов RANGE и LIST необходимо гарантировать, что имеется раздел, определенный для каждого номера раздела. Для выделения разделов HASH использованная функция пользователя должна возвратить целочисленное значение большее, чем 0 . Для выделения разделов KEY об этой проблеме позаботится автоматическая хэш-функция, которую сервер MySQL использует внутренне.
Имена разделов вообще следуют правилам для других MySQL-идентификаторов, типа тех, что применяются для таблиц и баз данных. Однако, Вы должны обратить внимание, что имена раздела не чувствительны к регистру. Например, следующая инструкция CREATE TABLE терпит неудачу как показано:
Сбой происходит потому, что MySQL не видит никакого различия между именами разделов mypart и MyPart .
Когда Вы определяете число разделов для таблицы, это должно быть выражено как положительный ненулевой целочисленный литерал без начальных нулей, и не может быть выражением типа 0.8E+01 или 6-2 , даже если это оценивается как целое число. Начиная с MySQL 5.1.12, десятичные дроби больше не усечены, но взамен отвергнуты полностью.
В разделах, которые следуют далее, мы не обязательно рассматриваем все возможные формы для синтаксиса, который может использоваться для создания каждого типа раздела.
3.2.1. RANGE Partitioning
Таблица, которая разбита на разделы диапазоном, разбита на разделы таким способом, которым каждый раздел содержит строки, для которых значение выражения выделения разделов находится внутри данного диапазона. Диапазоны должны быть непрерывны, но не перекрываться и определены, используя оператор VALUES LESS THAN . Для следующих немногих примеров, предположите, что Вы создаете таблицу типа следующей, чтобы сохранить персональные записи для цепочки из 20 видеоклипов, пронумерованных от 1 до 20:
Эта таблица может быть разбита на разделы диапазоном по-разному, в зависимости от Ваших потребностей. Один способ состоит в том, чтобы использовать столбец store_id . Например, Вы могли бы выделять разделы таблицы 4 способами, добавляя предложение PARTITION BY RANGE как показано здесь:
В этой схеме выделения разделов все строки, соответствующие записям, занимающим номера от 1 до 5, сохранены в разделе p0 , от 6 до 10 в p1 и т. д. Обратите внимание, что каждый раздел определен чтобы хранить номера от самого низкого до самого высокого. Это требование синтаксиса PARTITION BY RANGE : Вы можете думать об этом как об аналоге переключателя switch . case в C или Java в этом отношении.
Просто определить, что новая строка, содержащая данные (72, ‘Michael’, ‘Widenius’, ‘1998-06-25’, NULL, 13) , вставлена в раздел p2 , но что случается, когда Ваша цепочка, добавляет 21-ю запись? Согласно этой схеме, не имеется никакого правила, которое покрывает строку, с store_id большим чем 20, так что результатом будет ошибка, потому что сервер не знает, где поместить это. Вы можете обойти сбой, используя предложение VALUES LESS THAN в инструкции CREATE TABLE , которая обеспечивает все значения большие, чем явно именованное самое высокое значение:
MAXVALUE представляет самое большое возможное целочисленное значение. Теперь, любые строки, чье значение столбца store_id является большим или равным 16 (самое высокое определенное значение), сохранены в разделе p3 . В некоторой точке в будущем, когда число записей увеличится до 25, 30 или больше, Вы можете использовать инструкцию ALTER TABLE , чтобы добавить новые разделы для диапазонов 21-25, 26-30 и т. д.
В аналогичном режиме Вы могли бы выделять разделы таблицы, основанные на кодах работы служащего, то есть на диапазонах значений столбца job_code . Например, приняв, что коды работы с двумя цифрами используются для регулярных (in-store) рабочих, коды с тремя цифрами используются для ведомства и персонала поддержки, а четырехразрядные коды для позиций управления, Вы могли бы создать разбитую на разделы таблицу, используя:
В этом образце все строки в отношении рабочих in-store были бы сохранены в разделе p0 , строки для ведомства и персонала поддержки в p1 , а администраторы в разделе p2 .
Также возможно использовать выражение в предложениях VALUES LESS THAN . Однако, MySQL должен быть способен оценить возвращаемое значение выражения как часть сравнения LESS THAN ( < ).
Вы можете использовать выражение, основанное на одном из двух столбцов DATE . Например, предположим, что Вы желаете выделить разделы основанные на годе, в котором каждый служащий оставил компанию, то есть значение YEAR(separated) . Пример инструкции CREATE TABLE , которая осуществляет такую схему выделения разделов, показывается здесь:
В этой схеме для всех служащих, кто оставил работу до 1991, строки сохранены в разделе p0 , для периода 1991-1995 в p1 , для 1996-2000 в p2 , а для любых рабочих, кто оставил фирму после 2000 года в p3 .
Выделение разделов по диапазону особенно полезно когда:
Вы хотите удалить старые данные. Если Вы используете схему выделения разделов, показанную выше, Вы можете просто использовать ALTER TABLE employees DROP PARTITION p0; , чтобы удалять все строки в отношении служащих, оставивших работу до 1991. Для таблицы с очень многими строками, это может быть намного более эффективно, чем выполнение запроса DELETE , например, DELETE FROM employees WHERE YEAR(separated) <=1990; .
Вы хотите использовать столбец, содержащий значения даты, времени или значения, являющиеся результатом некоторого другого ряда.
Вы часто выполняете запросы, которые зависят непосредственно от столбца, используемого для выделения разделов таблицы. Например, при выполнении запроса типа SELECT COUNT(*) FROM employees WHERE YEAR(separated) = 2000 GROUP BY store_id; , MySQL может быстро определять, что только раздел p2 должен быть просмотрен, потому что остающиеся разделы не могут содержать записи, удовлетворяющие предложению WHERE .
3.2.2. LIST Partitioning
Как в выделении разделов RANGE , каждый раздел должен быть явно определен. Главное различие в том, что в выделении разделов списка, каждый раздел определен и выбран основываясь на членстве значения столбца в одном наборе значений списков, а не непрерывных диапазонов значений. Это выполнено, используя PARTITION BY LIST( expr ) , где expr значение столбца или выражение, основанное на значении столбца и возврате целочисленного значения, а затем определение каждого раздела посредством VALUES IN ( value_list ) , где value_list разделяемый запятыми список целых чисел.
Обратите внимание : В MySQL 5.1 возможно соответствовать только списку целых чисел (и возможно NULL ) при выделении разделов LIST .
В отличие от случая с разделами, определенными диапазоном, разделы списка не должны быть объявлены в любом специфическом порядке.
Для примеров ниже будем считать, что базисное определение таблицы, которая будет разбита на разделы обеспечивается инструкцией CREATE TABLE , показанной здесь:
Предположите, что имеются 20 видеоклипов, распределенных среди 4 привилегий, как показано в следующей таблице:
| Область | Store ID Numbers |
| Север | 3, 5, 6, 9, 17 |
| Восток | 1, 2, 10, 11, 19, 20 |
| Запад | 4, 12, 13, 14, 18 |
| Центр | 7, 8, 15, 16 |
Чтобы выделять разделы таблицы таким способом, чтобы строки для клипов, принадлежащих к той же самой области, были сохранены в том же самом разделе, Вы могли бы использовать инструкцию CREATE TABLE , показанную здесь:
Это облегчает добавление или удаление записи в отношении специфических областей. Например, предположите, что все клипы в западной области проданы другой компании. Все строки в их отношении могут быть удалены запросом ALTER TABLE employees DROP PARTITION pWest; , который может быть выполнен намного более эффективно, чем эквивалентная инструкция DELETE FROM employees WHERE store_id IN (4,12,13,14,18); .
Как с RANGE и HASH partitioning, если Вы желаете выделить разделы таблицы столбцом, чье значение не целое число или NULL , Вы должны использовать выражение выделения разделов, основанное на том столбце, который возвращает такое значение. Например, предположите, что таблица, содержащая данные определена, как показано здесь:
В этой версии таблицы employees код работы является символом, а не числом. Каждый символ соответствует специфической работе, и мы желаем выделить разделы таблицы таким способом, чтобы записи для служащих, имеющих подобные работы, или работающих в том же самом отделе, были сгруппированы в том же самом разделе, согласно следующей схеме:
| Категория работы или отдел | Коды работы |
| Management | D, M, O, P |
| Sales | B, L, S |
| Technical | A, E, G, I, T |
| Clerical | K, N, Y |
| Support | C, F, J, R, V |
| Unassigned | Empty |
Так как мы не можем использовать символьные значения в списках, мы должны преобразовать их в целых числа или NULL . Для этой цели мы можем использовать функцию ASCII() на значении столбца. Кроме того, из-за использования различных прикладных программ в разное время коды могут быть верхнего или нижнего регистра, значение empty означает » сейчас не назначен «, представлением чего могут быть NULL , пустая строка или пробел. Разбитая на разделы таблица, которая осуществляет эту схему, показывается здесь:
Так как выражения не разрешаются в списках значения раздела, Вы должны внести в список коды ASCII для символов, которые должны быть согласованы. Обратите внимание, что ASCII(NULL) вернет NULL .
Важно : если Вы пробуете вставлять строку так, что значение столбца (или возвращаемое значение выражения выделения разделов) не найдено в любом из списков значения выделения разделов, запрос INSERT будет терпеть неудачу с ошибкой. Например, этот запрос будет терпеть неудачу:
Сбой происходит, потому что 81 (код ASCII для прописной буквы ‘Q’ ) не найден в любом из списков значения используемых, чтобы определить любой из разделов. Не имеется никаких перехватчиков catch-all для list partitions , аналогичных VALUES LESS THAN(MAXVALUE) , который приспосабливает значения, не найденные в любом из списков значения. Другими словами, любое значение, которое должно быть согласовано, должно быть найдено в одном из списков значений.
Как с выделением разделов RANGE , возможно объединить выделение разделов LIST , чтобы произвести составное выделение разделов (подвыделение разделов).
3.2.3. HASH Partitioning
Выделение разделов HASH используется прежде всего, чтобы гарантировать четкое распределение данных среди предопределенного числа разделов. С диапазоном или выделением разделов списка, Вы должны определить явно, в который раздел данное значение столбца или набор значений столбца должно быть сохранено, с выделением разделов hash MySQL заботится об этом для Вас, и Вы должны только определить значение столбца или выражение, основанное на значении столбца для хэширования и число разделов, на которые должна быть разделена разбитая на разделы таблица.
Чтобы выделять разделы таблицы, использующей выделение разделов HASH , необходимо конкатенировать к инструкции CREATE TABLE предложение PARTITION BY HASH ( expr ) , где expr выражение, которое возвращает целое число. Это может быть просто имя столбца, чей тип является одним из целочисленных типов MySQL. Кроме того, Вы будете, наиболее вероятно, пользоваться предложением PARTITIONS num , где num неотрицательное целое число, представляющее число разделов, на которые таблица должна быть разделена.
Например, следующая инструкция создает таблицу, которая использует хэширование на столбце store_id и разделена на 4 раздела:
Если Вы не включаете предложение PARTITIONS , числом разделов по умолчанию будет 1 . Использование ключевого слова PARTITIONS без числа после него приводит к синтаксической ошибке.
Вы можете также использовать выражение SQL, которое возвращает целое число для expr . Например, Вы могли бы выделять разделы, основываясь на годе, в котором служащий был нанят. Это может быть выполнено как показано здесь:
Вы можете использовать любое функциональное или другое выражение для expr , которое является допустимым в MySQL, пока это возвращает непостоянное, непроизвольное целочисленное значение. Другими словами, это должно изменяться, но детерминировано. Однако, Вы должны иметь в виду, что это выражение оценено каждый раз, когда строка вставлена или модифицируется (или возможно удалена). Это означает, что очень сложные выражения могут вызывать проблемы эффективности, особенно при выполнении операций (типа пакетных вставок), которые воздействуют на очень многие строки в одно время.
Наиболее эффективная хэш-функция та, которая функционирует на одиночном столбце таблицы, и чье значение увеличивается или уменьшается последовательно со значением столбца, поскольку это учитывает сокращение (pruning) на диапазонах разделов. То есть, выражение изменяется со значением столбца, на котором основано.
Например, если столбец date_col типа DATE , то выражение TO_DAYS(date_col) изменяется непосредственно со значением date_col , потому что для каждого изменения в значении date_col значение выражения изменяется непротиворечивым способом. Дисперсия выражения YEAR(date_col) относительно date_col не так пряма, как TO_DAYS(date_col) , потому что не каждое возможное изменение в date_col производит эквивалентное изменение в YEAR(date_col) . Даже в этом случае YEAR(date_col) хороший кандидат на хэш-функцию, потому что это изменяется непосредственно с частью date_col , и не имеется никакого возможного изменения в date_col , которое производит непропорциональное изменение в YEAR(date_col) .
Посредством контраста, предположите, что Вы имеете столбец int_col типа INT . Теперь рассмотрите выражение POW(5-int_col,3)+6 . Это было бы плохим выбором для хэш-функции, потому что изменение в значении int_col не произведет пропорциональное изменение в значении выражения. Изменение значения int_col может производить очень разные изменения в значении выражения. Например, изменение int_col с 5 на 6 производит изменение в значении выражения -1 , но при изменении значения int_col с 6 на 7 это будет уже -7 .
Другими словами, граф значения столбца против значения выражения более близко следует за прямой строкой по уравнению y= n x , где n некоторая константа, отличная от нуля. Такое выражение лучше подходит для хэширования. Более нелинейный выражение произведет более неравное распределение данных среди разделов.
В теории сокращение также возможно для выражений включающих значение больше, чем одного столбца, но определение того, которые из таких выражений являются подходящими, может быть крайне трудным и отнимающим много времени. По этой причине использование выражений хэширования, включающих много столбцов, не особенно рекомендуется.
Когда используется PARTITION BY HASH , MySQL определяет который раздел num использовать, основываясь на модуле результата функции пользователя. Другими словами, для выражения expr раздел, в котором запись сохранена, представляет собой номер раздела N , где N =MOD( expr , num ) . Например, предположите, что таблица t1 определена следующим образом, чтобы имела 4 раздела:
Если Вы вставляете в t1 запись с ‘2005-09-15’ в col3 , то раздел, в котором это будет сохранено, определен следующим образом:
MySQL 5.1 также поддерживает вариант HASH partitioning известного как linear hashing (линейное хэширование) , которое использует более сложный алгоритм для определения размещения новых строк, вставленных в разбитую на разделы таблицу.
Функция пользователя оценена каждый раз, когда запись вставлена или модифицируется. Это может также быть в зависимости от обстоятельств, когда записи удалены.
Обратите внимание : если таблица, которая будет разбита на разделы, имеет ключ UNIQUE , то любые столбцы, обеспеченные как параметры к HASH функции пользователя или на KEY column_list , должны быть частью того ключа. Исключительная ситуация: это ограничение не относится к таблицам, использующим NDBCluster .
3.2.3.1. LINEAR HASH Partitioning
MySQL также поддерживает линейное хэширование, которое отличается от регулярного хэширования тем, что линейное хэширование использует линейный алгоритм степени двух в то время, как регулярное хэширование использует модуль значения хэш-функции.
Синтаксически единственное различие между выделением разделов линейного хэширования и регулярным хэшированием: добавление ключевого слова LINEAR в предложение PARTITION BY , как показано здесь:
Данный выражением expr раздел, в котором запись сохранена, когда линейное хэширование используется, представляет собой номер раздела N из числа разделов num , где N получен согласно следующему алгоритму:
Находят следующую степень 2 большую, чем num . Назовем это значение V , это может быть вычислено как:
Например, предположите, что num =13. Тогда LOG(2,13) =3.7004397181411. CEILING(3.7004397181411) 4, а V = POWER(2,4) = 3.
Например, предположите, что таблица t1 применяет линейное выделение разделов, имеет 6 разделов и создана, используя эту инструкцию:
Теперь примите, что Вы хотите вставлять две записи в t1 : у одной значение столбца col3 равно ‘2003-04-14’ , а у другой составляет ‘1998-10-19’ . Номер раздела для первой из них определен следующим образом:
Номер раздела, где сохранена вторая запись, вычислен как показано здесь:
Преимущество в выделении разделов линейным хэшем в том, что добавление, удаление, объединение и разбиение разделов сделано намного быстрее, что может быть полезно, когда имеешь дело с таблицами, содержащими чрезвычайно большие количества данных. Недостаток в том, что менее вероятно, что данные будут равномерно распределены между разделами по сравнению с распределением, полученным используя регулярное выделение разделов hash partitioning.
3.2.4. KEY Partitioning
Выделение разделов ключом подобно выделению разделов хэшем за исключением того, что выделение разделов хэшем использует определяемое пользователем выражение, а хэш-функция для выделения разделов ключом обеспечена MySQL. Здесь MySQL Cluster использует для этой цели MD5() , а для таблиц, использующих другие типы памяти, сервер применяет собственную внутреннюю хэш-функцию, которая основана на том же самом алгоритме, что и PASSWORD() .
Правила синтаксиса для CREATE TABLE . PARTITION BY KEY подобен правилам для создания таблицы, которая разбита на разделы хэшем. Главные различия состоят в том что:
KEY используется вместо HASH .
KEY берет только список из одного или большего количества имен столбцов. Начиная с MySQL 5.1.5, если таблица имеет первичный ключ, столбцы, по которым происходит выделение разделов, должны включать хотя бы его часть (или весь ключ).
Начиная с MySQL 5.1.6, KEY берет список из нуля или большего количества имен столбца. Если никакое имя столбца не определено как ключ выделения разделов, используется первичный ключ таблицы, если он имеется. Например, следующая инструкция CREATE TABLE допустима в MySQL 5.1.6 или позже:
Если не имеется никакого первичногоключа, но имеется уникальный ключ, то именно уникальный ключ используется для выделения разделов:
Однако, если уникальный столбец ключа не был определен как NOT NULL , то предыдущая инструкция будет терпеть неудачу.
В обоих из этих случаев ключом выделения разделов является столбец id , даже при том, что это не показывается в выводе SHOW CREATE TABLE или в столбце PARTITION_EXPRESSION таблицы INFORMATION_SCHEMA.PARTITIONS .
В отличие от случая с другими типами выделения разделов, столбцы, используемые для выделения разделов KEY , не ограничены значениями NULL или целым числом. Например, следующая инструкция CREATE TABLE допустима:
Предшествующая инструкция не была бы допустима для любого другого типа выделения разделов. Примечание : в этом случае, простое использование PARTITION BY KEY() было бы также допустимо и имело бы тот же самый эффект. что и PARTITION BY KEY(s1) , поскольку s1 является первичным ключом таблицы.
Обратите внимание : также начиная с MySQL 5.1.6, таблицы, использующие NDB Cluster неявно разбиты на разделы KEY , используя первичный ключ таблицы как ключ выделения разделов. Когда таблица кластера не имеет никакого явного первичного ключа, применяется скрытый первичный ключ, сгенерированный NDB для каждой таблицы кластера.
Важно : для таблицы с разделением по ключу, использующей любой тип памяти MySQL, кроме NDB Cluster , Вы не можете выполнять ALTER TABLE DROP PRIMARY KEY , так как это сгенерирует ошибку ERROR 1466 (HY000): Field in list of fields for partition function not found in table . Это не проблема для таблиц MySQL Cluster, которые разбиты на разделы KEY : в таких случаях, таблица реорганизована, используя скрытый первичный ключ для выделения разделов этой таблицы.
Также возможно выделить разделы таблицы линейным ключом. Имеется простой пример:
Использование LINEAR имеет тот же самый эффект на KEY , как на выделении разделов HASH с номером раздела, получаемым использованием алгоритма степени двух, а не арифметикой модуля.
3.2.5. Подвыделение разделов (Subpartitioning)
Subpartitioning также известно как составное выделение разделов (composite partitioning), что является дальнейшим делением каждого раздела в разбитой на разделы таблице. Например, рассмотрите следующую инструкцию CREATE TABLE :
Таблица ts имеет 3 раздела RANGE . Каждый из этих разделов p0 , p1 и p2 далее разделен на 2 подраздела. В действительности вся таблица разделена на 3*2=6 разделов. Однако, из-за действия предложения PARTITION BY RANGE первые 2 хранят только записи со значением меньше, чем 1990 в столбце purchased .
В MySQL 5.1 возможно подвыделить разделы таблиц, которые разбиты на разделы RANGE или LIST . Подразделы могут использовать выделение разделов HASH или KEY . Это также известно как составное выделение разделов.
Также возможно определить подразделы, явно использующие предложения SUBPARTITION , чтобы определить параметры для индивидуальных подразделов. Например, более подробный режим создания той же самой таблицы ts , как показано в предыдущем примере был бы:
Некоторые синтаксические элементы:
Каждый раздел должен иметь то же самое число подразделов.
Если Вы явно определяете любые подразделы, использующие SUBPARTITION на любом разделе разбитой на разделы таблицы, Вы должны определить их все. Другими словами, следующая инструкция будет терпеть неудачу:
Эта инструкция свалится даже если добавить предложение SUBPARTITIONS 2 .
Каждое предложение SUBPARTITION должно включить (как минимум) имя для подраздела. Иначе Вы можете устанавливать любую желательную опцию для подраздела или позволить принимать настройку по умолчанию для этой опции.
В MySQL 5.1.7 и ранее имена подразделов должны быть уникальны внутри каждого раздела, но не должны быть уникальны внутри таблицы в целом. Начиная с MySQL 5.1.8, имена подразделов должны быть уникальны для всей таблицы. Например, следующая инструкция CREATE TABLE допустима в MySQL 5.1.8 и позже:
Предыдущая инструкция также допустима для версий MySQL до 5.1.8.
Подразделы могут использоваться с особенно большими таблицами, чтобы распределить данные и индексы на много дисков. Предположите, что Вы имеете 6 дисков, установленные как /disk0 , /disk1 , /disk2 и т. д. Теперь рассмотрите следующий пример:
В этом случае отдельный диск используется для данных и индексов каждого RANGE . Много других разновидностей возможны, другой пример мог бы быть таким:
Здесь хранение следующее:
Строки с датами purchased до 1990 занимают обширное количество места, поэтому поделены 4 путями: с отдельным диском, специализированным для данных, и с дополнительным диском для индексов для каждого из двух подразделов ( s0a и s0b ), входящих в раздел p0 . Другими словами:
Данные для подраздела s0a сохранены на /disk0 .
Индексы для подраздела s0a сохранены на /disk1 .
Данные для подраздела s0b сохранены на /disk2 .
Индексы для подраздела s0b сохранены на /disk3 .
Строки, содержащие даты в пределах от 1990 до 1999 (раздел p1 ) не требуют так много памяти, как даты до 1990. Они размазаны между 2 дисками ( /disk4 и /disk5 ):
Данные и индексы, принадлежащие первому подразделу ( s1a ) раздела p1 , сохранены на /disk4 : данные в /disk4/data , а индексы в /disk4/idx .
Данные и индексы, принадлежащие второму подразделу ( s1b ) раздела p1 , сохранены на /disk5 : данные в /disk5/data , а индексы в /disk5/idx .
Строки, отражающие даты с года 2000 до текущей (раздел p2 ), не занимают так много места, как любой из двух предыдущих диапазонов. В настоящее время достаточно сохранить всех их в заданном по умолчанию расположении.
В будущем, когда число purchases в течение десятилетия, начинающегося годом 2000, вырастет до отметки, где заданное по умолчанию расположение больше не обеспечивает достаточного места, соответствующие строки могут перемещаться, используя ALTER TABLE . REORGANIZE PARTITION .
3.2.6. Как выделитель разделов в MySQL обрабатывает значения NULL
Выделение разделов в MySQL не делает ничего, чтобы отвергнуть NULL как значение выражения выделения разделов независимо от того, является ли это значением столбца или обеспеченного пользователем выражения. Даже разрешается использовать NULL как значение выражения, которое должно выдать целое число, но важно иметь в виду, что NULL числом не является. Начиная с версии 5.1.8, MySQL обрабатывает NULL как будто он меньше, чем любое не нулевое значение, точно как делает ORDER BY .
Из-за этого эта обработка NULL изменяется при выделении разделов различных типов, и может производить поведение, которое Вы не ожидаете. Если Вы вставляете строку в таблицу, разбитую на разделы RANGE так, что значение столбца, используемое, чтобы определить раздел, является NULL , строка вставлена в самый нижний раздел. Например, рассмотрите эти две таблицы, созданные и заполняемые следующим образом:
Вы можете видеть, в который раздел строки сохранены, осматривая файловую систему и сравнивая размеры .MYD -файлов:
Файлы разделов именованы согласно формату table_name #P# partition_name . extension так, чтобы t1#P#p0.MYD был файлом, в котором сохранены данные, принадлежащие к разделу p0 таблицы t1 . Обратите внимание : до MySQL 5.1.5, эти файлы были бы именованы соответственно t1_p0.MYD и t2_p0.MYD .
Вы можете также показывать, что эти строки были сохранены в самом низком разделе каждой таблицы, удаляя эти разделы, а затем делая повторный запуск инструкций SELECT :
Такая обработка также верна для выделения разделов с помощью выражений через использование функций SQL. Предположите, что мы имеем таблицу:
Как с другими функциями MySQL, YEAR(NULL) вернет NULL . Строка со значением NULL столбца dt обрабатывается, как если бы выражение выделения разделов было оценено к значению меньше, чем любое другое значение, и так вставлено в раздел p0 .
Таблица, которая разбита на разделы LIST допускает значения NULL если (и только если!) один из разделов определен, используя список значений, который содержит NULL . Таблица, разбитая на разделы LIST , которая явно не использует NULL в списке значений, отклоняет строки, приводящие к значению NULL для выражения выделения разделов, как показано в этом примере:
Только строки, имеющие значение c1 между 0 и 8 включительно, могут быть вставлены в ts1 . NULL выходит за пределы этого диапазона точно так же, как число 9 . Мы можем создавать таблицы ts2 и ts3 и списки значений, содержащие NULL , как показано здесь:
При определении значения для выделения разделов, Вы можете обрабатывать NULL точно как любое другое значение, и допустимы VALUES IN (NULL) и VALUES IN (1, 4, 7, NULL) (равно как и VALUES IN (1, NULL, 4, 7) , VALUES IN (NULL, 1, 4, 7) и тому подобное). Вы можете вставлять строку, имеющую NULL для столбца c1 в каждую из таблиц ts2 и ts3 :
Осматривая файловую систему, Вы можете проверить, что первая из этих инструкций вставила новую строку в раздел p3 таблицы ts2 , а вторая инструкция вставила новую строку в раздел p1 таблицы ts3 :
Как в более ранних примерах, мы принимаем использование оболочки bash в операционной системе для Unix для списка файлов. Например, если Вы используете оболочку DOS в операционной системе Windows эквивалент последнего вывода мог быть получен, выполняя команду dir ts3*.MYD в каталоге C:\Program Files\MySQL\MySQL Server 5.1\data\test .
Как показано ранее в этом разделе, Вы можете также проверять, которые разделы использовались для сохранения значений удаляя их, а затем выполняя SELECT .
NULL обработан несколько по-другому для таблиц, разбитых на разделы HASH или KEY . В этих случаях любое выражение раздела, которое выдает значение NULL , обрабатывается, как если бы возвращаемое значение было нулевым. Мы можем проверять это поведение, исследуя эффекты в файловой системе от создания таблицы, разбитой на разделы HASH и начальной загрузкой с записью, содержащей соответствующие значения. Предположите, что Вы имеете таблицу th , созданную в базе данных test , используя эту инструкцию:
При принятии установки RPM MySQL под Linux, эта инструкция создает два .MYD -файла в /var/lib/mysql/test , которые могут просматриваться в оболочке bash следующим образом:
Обратите внимание, что размер каждого файла 0 байтов. Теперь вставьте в th строку, чей столбец c1 является NULL , и проверьте, что эта строка была вставлена:
Заметьте, что для любого целого числа N значение NULL MOD N всегда NULL . Для таблиц, которые разбиты на разделы HASH илм KEY , этот результат обрабатывается для определения правильного раздела как 0 . При возврате к оболочке системы, мы можем видеть, что значение было вставлено в первый раздел (по умолчанию p0 ), выводя файлы данных еще раз:
Вы можете видеть, что инструкция INSERT изменила только файл th#P#p0.MYD (увеличение размера на диске) без того, чтобы воздействовать на другой файл данных.
Важно : до MySQL 5.1.8 выделение разделов по RANGE значение выражения выделения разделов NULL работало как 0 (единственный способ обходить это должен был разработать таблицы так, чтобы не позволить пустые указатели, обычно объявляя столбцы NOT NULL ). Если Вы имеете схему выделения разделов RANGE , которая зависит от этого более раннего поведения, Вы будете должны заново выполнить это при обновлении до MySQL 5.1.8 или позже.
3.3. Управление разделами
MySQL 5.1 обеспечивает ряд способов изменить разбитые на разделы таблицы. Возможно добавлять, удалять, переопределять, объединять или расчленять существующие разделы. Все эти действия могут быть выполнены, используя расширения выделения разделов к команде ALTER TABLE . Имеются также способы получить информацию относительно разбитых на разделы таблиц и разделов.
Обратите внимание : в MySQL 5.1 все разделы разбитой на разделы таблицы должны иметь то же самое число подразделов, и невозможно изменить подвыделение разделов, если только таблица была создана.
Инструкция ALTER TABLE . PARTITION BY . доступна с MySQL 5.1.6, предварительно, в MySQL 5.1, это было принято как допустимый синтаксис, но инструкция не делала ничего.
Чтобы изменять схему выделения разделов таблицы, необходимо использовать команду ALTER TABLE с предложением partition_options . Это предложение имеет тот же самый синтаксис, как то, что используется с CREATE TABLE для создания разбитой на разделы таблицы, и всегда начинается с ключевых слов PARTITION BY . Например, предположите, что Вы имеете таблицу, разбитую на разделы диапазоном, использующим следующую инструкцию CREATE TABLE :
Чтобы заново выделять разделы этой таблицы так, чтобы это было разбито на разделы ключом на два раздела, использующие значение столбца id как основание для ключа, Вы можете использовать эту инструкцию:
Это имеет тот же самый эффект на структуре таблицы как удаление таблицы и создания ее вновь, используя CREATE TABLE trb3 PARTITION BY KEY(id) PARTITIONS 2; .
Важно : в MySQL 5.1.7 и ранее ALTER TABLE . ENGINE = . удаляет все выделение разделов из обрабатываемой таблицы. Начиная с MySQL 5.1.8, этот оператор меняет только тип памяти, используемый таблицей, и оставляет схему выделения разделов таблицы неповрежденной. С MySQL 5.1.8 применяйте ALTER TABLE . REMOVE PARTITIONING , чтобы удалить выделение разделов таблицы.
3.3.1. Управление разделами RANGE и LIST
Разделы диапазона и списка очень похожи относительно того, как обработано добавление и удаление разделов. По этой причине мы обсуждаем здесь управление обеими сортами выделения разделов.
Удаление раздела из таблицы, которая разбита на разделы RANGE или LIST может быть выполнено, используя инструкцию ALTER TABLE с предложением DROP PARTITION . Имеется базисный пример, который предполагает, что Вы уже создали таблицу, которая разбита на разделы диапазоном и затем заполняется 10 записями, использующими следующие инструкции CREATE TABLE и INSERT :
Вы можете видеть, которые элементы должны быть вставлены в раздел p2 как показано здесь:
Чтобы удалить раздел p2 , выполните следующую команду:
Обратите внимание: в MySQL 5.1 NDB Cluster не поддерживает ALTER TABLE . DROP PARTITION . Это, однако, поддерживает другие связанные с выделением разделов расширения ALTER TABLE , которые описаны в этой главе.
Очень важно не забыть, что, когда Вы удаляете раздел, Вы также удаляете все данные, которые был сохранены в этом разделе. Вы можете видеть, что дело обстоит именно так, делая повторный запуск предыдущего запроса SELECT :
Из-за этого в MySQL 5.1.10 было добавлено требование, что Вы имеете привилегию DROP для таблицы прежде, чем Вы сможете выполнять ALTER TABLE . DROP PARTITION на этой таблице.
Если Вы желаете удалить все данные из всех разделов при сохранении определения таблицы и схемы выделения разделов, используйте команду TRUNCATE TABLE .
Если Вы предполагаете изменять выделение разделов таблицы без потерь данных, используйте вместо этого ALTER TABLE . REORGANIZE PARTITION .
Если Вы теперь выполняете команду SHOW CREATE TABLE , Вы можете видеть, как выделение разделов таблицы было изменено:
Когда Вы вставляете новые строки в измененную таблицу со значениями столбца purchased между ‘1995-01-01’ и ‘2004-12-31’ включительно, те строки будут сохранены в разделе p3 . Вы можете проверять этот факт следующим образом:
Обратите внимание, что число строк, удаленных из таблицы в результате ALTER TABLE . DROP PARTITION не сообщено сервером, поскольку это было бы эквивалентом запроса DELETE .
Удаление разделов LIST использует такой же синтаксис same ALTER TABLE . DROP PARTITION , как и для RANGE . Однако, имеется одно важное различие в эффекте, который это имеет на вашем использовании таблицы позже: Вы больше не можете вставлять в таблицу никакие строки, имеющие любое из значений, которые были включены в список значения, определяющие удаленный раздел.
Чтобы добавлять новый диапазон или раздел списка к предварительно разбитой на разделы таблице, используйте инструкцию ALTER TABLE . ADD PARTITION . Для таблиц, которые разбиты на разделы RANGE , это может использоваться, чтобы добавить новый диапазон к концу списка существующих разделов. Например, предположите, что Вы имеете разбитую на разделы таблицу, содержащую данные членства для Вашей организации, которая определена следующим образом:
Предположите далее, что минимальный возраст для элементов 3. Поскольку календарь приближается к концу 2005, Вы понимаете, что Вы будете скоро допускать элементы, которые были рождены в 1990 (и позже в последующих годах). Вы можете изменять таблицу элементов, чтобыразместить новые элементы members , рожденные в годах 1990-1999 как показано здесь:
Важно : с таблицами, которые разбиты на разделы диапазоном, Вы можете использовать ADD PARTITION , чтобы добавить новые разделы только к верхнему концу списка разделов. Попытки добавлять новый раздел этим способом между или прежде, чем существующие разделы, приведут к ошибке, как показано здесь:
В подобном режиме Вы можете добавлять новые разделы к таблице, которая разбита на разделы LIST . Например, данная таблица определена подобно этому:
Вы можете добавлять новый раздел, чтобы сохранить строки, имеющие значения столбца data 7 , 14 и 21 как показано здесь:
Обратите внимание, что Вы не можете добавлять новый раздел LIST , включающий любые значения, которые уже включены в список значений существующего раздела (сервер не поймет, в какой именно раздел ему дописывать данные). Если Вы пытаетесь сделать так, выйдет ошибка:
Потому что любые строки со значением столбца data 12 уже были назначены в раздел p1 , Вы не можете создавать новый раздел в таблице tt , который включает 12 в список значения. Чтобы выполнять это, Вы могли бы удалить p1 , добавить np , а затем новый p1 с изменяемым определением. Однако, как сказано ранее, это привело бы к потере всех данных, сохраненных в p1 , и это часто имеет место. Другое решение: сделать копию таблицы с новым выделением разделов и скопировать данные в нее, используя CREATE TABLE . SELECT . , затем удалить старую таблицу и переименовать новую, но это могло бы быть очень долго, когда имеешь дело с большими количествами данных. Это также не может быть возможно в ситуациях, где высокая доступность является требованием.
Начиная с MySQL 5.1.6, Вы можете добавлять много разделов в одиночной команде ALTER TABLE . ADD PARTITION , как показано здесь:
Реализация выделения разделов в MySQL обеспечивает способы переопределить разделы без потерь данных. Выберите таблицу элементов members , которая теперь определена как показано здесь:
Предположите, что Вы хотели бы переместить все строки, представляющие элементы, рожденные перед 1960 в отдельный раздел. Мы уже видели, что это не может быть выполнено, используя ALTER TABLE . ADD PARTITION . Однако, Вы можете использовать другое связанное с разделом расширение ALTER TABLE , чтобы выполнить это:
В действительности эти команды разделяют раздел p0 на два новых раздела s0 и s1 . Это также перемещает данные, которые были сохранены в p0 , в новые разделы согласно правилам, воплощенным в двух предложениях PARTITION . VALUES . , так, чтобы s0 содержал только те записи, для которых YEAR(dob) меньше, чем 1960 и s1 хранил те строки, в которых YEAR(dob) является большим чем или равным 1960, но меньше чем 1970.
Предложение REORGANIZE PARTITION может также использоваться для объединения смежных разделов. Вы можете возвращать таблицу элементов members к предыдущему выделению разделов, как показано здесь:
Никакие данные не потеряны при разбиении или объединении разделов, использующих REORGANIZE PARTITION . При выполнении вышеупомянутой инструкции MySQL перемещает все записи, которые были сохранены в разделах s0 и s1 в раздел p0 .
Общий синтаксис для REORGANIZE PARTITION :
Здесь tbl_name имя разбитой на разделы таблицы, partition_list разделяемый запятыми список имен одного или большего количества существующих разделов, которые будут изменены. partition_definitions разделяемый запятыми список новых определений разделов, которые следуют тем же самым правилам, что касаются списка partition_definitions , используемого в CREATE TABLE . Должно быть отмечено, что Вы не ограничены объединением нескольких разделов в один или разбиением одного раздела на много, когда используете REORGANIZE PARTITION . Например, Вы можете реорганизовать все четыре раздела таблицы элементов members в два следующим образом:
Имеются некоторые ключевые точки, которые следует иметь в виду, когда используете ALTER TABLE . REORGANIZE PARTITION , чтобы заново выделить разделы таблиц, которые разбиты на разделы RANGE или LIST :
Предложения PARTITION используемые, чтобы определить новую схему выделения разделов, подчинены тем же самым правилам, какие использовали с инструкцией CREATE TABLE .
Наиболее важно, Вы должны не забыть, что новая схема выделения разделов не может иметь любые диапазоны перекрывания (применяется к таблицам, разбитым на разделы RANGE ) или наборов значений (при реорганизации таблиц, разбитых на разделы LIST ).
Обратите внимание : до MySQL 5.1.4 Вы не могли бы многократно использовать имена существующих разделов в предложении INTO , даже когда те разделы удалялись удалялись или переопределялись.
Комбинация разделов в списке partition_definitions должна объявить тот же самый диапазон или полный набор значений, что и объединенные разделы, именованные в partition_list .
Например, в таблице элементов members , используемой в этом разделе, выделяются разделы p1 и p2 , которые вместе покрывают годы с 1980 по 1999. Следовательно, любая реорганизация этих двух разделов должна покрыть тот же самый диапазон полных лет.
Для таблиц, разбитых на разделы RANGE Вы можете реорганизовать только смежные разделы. Вы не можете перескакивать над разделами диапазона.
Например, Вы не могли бы реорганизовать таблицу элементов members , используемую в этом разделе, используя инструкцию, начинающуюся ALTER TABLE members REORGANIZE PARTITION p0, p2 INTO . , поскольку p0 покрывает годы до 1970, а p2 годы с 1990 по 1999 включительно, и таким образом это не смежные разделы.
Вы не можете использовать REORGANIZE PARTITION , чтобы изменить тип выделения разделов таблицы, то есть Вы не можете (например) изменять разделы RANGE на HASH или наоборот. Вы также не можете использовать эту команду, чтобы изменить выражение выделения разделов или столбец. Чтобы выполнять любую из этих задач без того, чтобы удалить и вновь создать таблицу, Вы можете использовать ALTER TABLE . PARTITION BY . . Например:
3.3.2. Управление разделами KEY и HASH
Таблицы, которые разбиты на разделы hash или key очень похожи друг на друга относительно создания изменений в установке выделений разделов, и оба типа отличаются от таблиц, которые были разбиты на разделы диапазоном или списком.
Вы не можете удалять разделы из таблиц, которые разбиты на разделы HASH или KEY таким же образом, каким Вы можете удалять их из таблиц, которые разбиты на разделы RANGE или LIST . Однако, Вы можете объединять разделы HASH или KEY , используя команду ALTER TABLE . COALESCE PARTITION . Например, предположите, что Вы имеете таблицу, содержащую данные относительно клиентуры, которая разделена на двенадцать разделов. Таблица clients определена как показано здесь:
Чтобы уменьшить число разделов с двенадцати до восьми, выполните следующую команду ALTER TABLE :
COALESCE работает одинаково хорошо с таблицами, которые разбиты на разделы HASH , KEY , LINEAR HASH или LINEAR KEY . Имеется пример, подобный предыдущему, отличаясь только тем, что таблица разбита на разделы LINEAR KEY :
Обратите внимание, что число, следующее за COALESCE PARTITION являются числом разделов, которое надлежит удалить из таблицы.
Если Вы пытаетесь удалить большее количество разделов, чем таблица имеет, результатом будет ошибка:
Чтобы увеличить число разделов для таблицы clients с 12 до 18, скомандуйте ALTER TABLE . ADD PARTITION :
3.3.3. Сопровождение разделов
Ряд задач сопровождения выделения разделов может быть выполнен в MySQL 5.1. MySQL не поддерживает команды CHECK TABLE , OPTIMIZE TABLE , ANALYZE TABLE или REPAIR TABLE для разбитых на разделы таблиц. Вместо этого Вы можете использовать ряд расширений ALTER TABLE , которые были выполнены в MySQL 5.1.5. Они могут использоваться для выполнения операций этого типа на одном или большем количестве разделов непосредственно, как описано в следующем списке:
Rebuilding partitions : восстанавливает раздел: это имеет тот же самый эффект, что и удаление всех записей, сохраненных в разделе, с последующей перевставкой их. Это может быть полезно с целью дефрагментации. Пример:
Optimizing partitions : если Вы удалили большое количество строк из раздела или сделали много изменений для разбитой на разделы таблицы со строками переменной длины (то есть, имея столбцы VARCHAR , BLOB или TEXT ), Вы можете использовать ALTER TABLE . OPTIMIZE PARTITION , чтобы восстановить неиспользуемое место и дефрагментировать файл данных раздела:
Использование OPTIMIZE PARTITION на данном разделе эквивалентно выполнению CHECK PARTITION , ANALYZE PARTITION и REPAIR PARTITION .
Analyzing partitions : читает и сохраняет распределения ключа для разделов. Пример:
Repairing partitions : это восстанавливает разрушенные разделы. Пример:
Checking partitions : Вы можете проверять раздел на ошибки способом, которым Вы можете использовать CHECK TABLE с не разбитыми на разделы таблицами:
Эта команда сообщит Вам, если данные или индексы в разделе p1 таблицы t1 разрушены. Если дело обстоит так, используйте ALTER TABLE . REPAIR PARTITION для ремонта раздела.
Вы можете также использовать утилиту mysqlcheck или myisamchk , чтобы выполнить эти задачи, действуя на отдельных .MYI -файлах, сгенерированных, выделяя разделы таблицы.
3.3.4. Получение информации относительно разделов
Этот раздел обсуждает получение информации относительно существующих разделов, что может быть выполнено несколькими способами. Они включают:
Использование инструкции SHOW CREATE TABLE , чтобы просмотреть предложения выделения разделов, используемые в создании разбитой на разделы таблицы.
Использование инструкции SHOW TABLE STATUS , чтобы определить, разбита ли таблица на разделы вообще.
Запрос таблицы INFORMATION_SCHEMA.PARTITIONS .
Использование инструкции EXPLAIN PARTITIONS SELECT , чтобы видеть, которые разделы используются данным SELECT .
SHOW CREATE TABLE включает в вывод предложение PARTITION BY , используемое, чтобы создать разбитую на разделы таблицу. Например:
Обратите внимание : в ранних версиях MySQL 5.1 предложение PARTITIONS не показывалось для таблиц, разбитых на разделы HASH или KEY . Эта проблема была отфиксирована в MySQL 5.1.6.
SHOW TABLE STATUS работает с разбитыми на разделы таблицами. Начиная с MySQL 5.1.9, вывод такой же, как для не разбитых на разделы таблиц за исключением того, что столбец Create_options содержит строку partitioned . В MySQL 5.1.8 и ранее столбец Engine всегда содержал значение PARTITION . Начиная с MySQL 5.1.9, этот столбец содержит имя типа памяти, используемого всеми разделами таблицы.
Вы можете также получать информацию относительно разделов из INFORMATION_SCHEMA , которая содержит таблицу PARTITIONS .
Начиная с MySQL 5.1.5, можно определить, которые разделы разбитой на разделы таблицы включаются в данном запросе SELECT , применяя EXPLAIN PARTITIONS . Ключевое слово PARTITIONS добавляет столбец partitions к выводу EXPLAIN , перечисляющего столбцы, из которых записи соответствуют запросу.
Предположите, что Вы имеете таблицу trb1 определенную и заполняемую следующим образом:
Вы можете видеть, которые разделы используются в запросе типа SELECT * FROM trb1; , как показано здесь:
В этом случае все четыре раздела задействованы. Однако, когда условие ограничено, используя ключ, выделение разделов добавлено к запросу. Вы можете видеть, что просмотрены только те разделы, которые содержат соответствующие значения, как показано здесь:
EXPLAIN PARTITIONS обеспечивают информацию относительно используемых и возможных ключей, точно как со стандартной инструкцией EXPLAIN SELECT :
Вы должны принять во внимание следующие ограничения на EXPLAIN PARTITIONS :
Вы не можете использовать ключевые слова PARTITIONS и EXTENDED вместе в том же самом запросе EXPLAIN . SELECT . Попытка сделать так производит синтаксическую ошибку.
Если EXPLAIN PARTITIONS используется, чтобы исследовать запрос для не разбитой на разделы таблицы, никакая ошибка не будет произведена, но значение столбца partitions всегда NULL .
3.4. Сокращение раздела
Этот раздел обсуждает сокращение раздела (partition pruning), оптимизацию, которая была выполнена для разбитых на разделы таблиц в MySQL 5.1.6.
Основное понятие сокращения раздела относительно просто, и может быть описано как «не просматриваются разделы, где не может иметься никаких значений соответствия». Например, предположите, что Вы имеете разбитую на разделы таблицу t1 , определенную этой инструкцией:
Рассмотрите случай, где Вы желаете получить результат запроса типа этого:
Просто видеть, что ни одна из строк, которые должны быть возвращены, не будет в разделе p0 или p3 . То есть, мы должны искать данные только в разделах p1 и p2 , чтобы найти строки соответствий. Делая так, можно расходовать намного меньше времени и усилий в нахождении строк соответствий, чем при просмотре всех разделов в таблице. Это и известно как сокращение ( pruning). Когда оптимизатор может использовать сокращение раздела, выполнение запроса может быть на порядок быстрее, чем тот же самый запрос на не разбитой на разделы таблицы, содержащей те же самые определения столбца и данные.
Оптимизатор запроса может выполнять сокращение всякий раз, когда условие WHERE может быть уменьшено до любого одного из следующего:
partition_column IN ( constant1 , constant2 , . constantN )
В первом случае, оптимизатор просто оценивает выражение выделения разделов для данного значения, определяет, который раздел содержит то значение, и просматривает только этот раздел. Во втором случае оптимизатор оценивает выражение выделения разделов для каждого значения в списке, создает список соответствия разделов, а затем просматривает только разделы в этом списке.
Сокращение может также применяться к коротким диапазонам, которые оптимизатор может преобразовывать в эквивалентные списки значений. Например, в предыдущем примере, предложение WHERE может быть преобразовано в WHERE region_code IN (125, 126, 127, 128, 129, 130) . Затем оптимизатор может определять, что первые три значения в списке найдены в разделе p1 , следующие три значения в разделе p2 и что другие разделы не содержат никаких релевантных значений.
Этот тип оптимизации может применяться всякий раз, когда выражение выделения разделов состоит из равенства или диапазона, который может быть уменьшен до набора равенств, или же когда выражение выделения разделов представляет связь уменьшения или увеличение. Сокращение может также быть применено для таблиц, разбитых на разделы на основании столбцов DATE или DATETIME , когда выражение выделения разделов использует функцию YEAR() или TO_DAYS() . Обратите внимание : в будущих версиях MySQL планируется добавлять поддержку сокращения для дополнительных функций, которые действуют на значения DATE или DATETIME , возвращают целое число и увеличиваются или уменьшаются. Например, предположите, что таблица t2 , определенная как показано здесь, разбита на разделы на столбце DATE :
Следующие запросы к t2 могут использовать сокращение:
В случае последнего запроса оптимизатор может также действовать следующим образом:
Найти раздел, содержащий нижний конец диапазона. .
YEAR(‘1984-06-21’) выдает значение 1984 , которое найдено в разделе d3 .
Найти раздел, содержащий верхний конец диапазона. .
YEAR(‘1999-06-21’) оценивается к 1999 , которое найдено в разделе d5 .
Просмотреть только эти два раздела и любые разделы, которые могут находиться между ними.
В этом случае, это означает, что просмотрены только разделы d3 , d4 и d5 . Остающиеся разделы могут безопасно игнорироваться (и игнорируются).
Пока мы смотрели только на примеры, использующие выделение разделов RANGE , но сокращение может применяться также и с другими типами выделения разделов.
Рассмотрите таблицу, которая разбита на разделы LIST , где выражение выделения разделов увеличивается или уменьшается, типа таблицы t3 , показанной здесь. В этом примере мы принимаем для краткости, что столбец region_code ограничен значениями от 1 до 10.
Для запроса типа SELECT * FROM t3 WHERE region_code BETWEEN 1 AND 3 оптимизатор определяет, в которых разделах значения 1, 2 и 3 найдены ( r0 и r1 ) и пропускает остающиеся ( r2 и r3 ).
Для таблиц, которые разбиты на разделы HASH или KEY , сокращение раздела также возможно в случаях, в которых предложение WHERE использует простое отношение = против столбца, используемого в выражении выделения разделов. Рассмотрите таблицу, созданную подобно этому:
Любой запрос типа этого может быть сокращен:
Сокращение также может быть использовано для коротких диапазонов, потому что оптимизатор может направлять такие условия в отношениях IN . Например, при использовании той же самой таблицы t4 как определено ранее, запросы типа этих могут быть сокращены:
В обеих случаях, предложения WHERE преобразованы оптимизатором в WHERE region_code IN (3, 4, 5) . Важно : эта оптимизация используется только, если размер диапазона меньший, чем число разделов. Рассмотрите этот запрос:
Диапазон в предложении WHERE покрывает 5 значений (4, 5, 6, 7, 8), но t4 имеет только 4 раздела. Это означает, что предыдущий запрос никак не может быть сокращен.
Сокращение может использоваться только на целочисленных столбцах таблиц, разбитых на разделы HASH или KEY . Например, этот запрос на таблице t4 не может использовать сокращение, потому что dob столбец типа DATE :
Однако, если таблица сохраняет значения года в столбце типа INT , то запрос WHERE year_col >= 2001 AND year_col <= 2005 может быть сокращен.
3.5. Ограничения выделения разделов
Этот раздел обсуждает текущие ограничения поддержки выделения разделов MySQL:
Начиная с MySQL 5.1.12, следующие конструкции не разрешаются в выражениях выделения разделов:
Вложенные обращения к функциям (то есть, конструкции типа func1 ( func2 ( col_name )) ).
Сохраненные процедуры, функции, UDF или plugins.
Объявленные переменные или переменные пользователя.
Начиная с MySQL 5.1.12, следующие функции MySQL специально не позволяются в выражениях выделения разделов:
Что такое партицирование в sql
Although tables and indexes are the most important and commonly used schema objects, the database supports many other types of schema objects, the most common of which are discussed in this chapter.
This chapter contains the following sections:
Overview of Partitions
In an Oracle database, partitioning enables you to decompose very large tables and indexes into smaller and more manageable pieces called partitions . Each partition is an independent object with its own name and optionally its own storage characteristics.
For an analogy that illustrates partitioning, suppose an HR manager has one big box that contains employee folders. Each folder lists the employee hire date. Queries are often made for employees hired in a particular month. One approach to satisfying such requests is to create an index on employee hire date that specifies the locations of the folders scattered throughout the box. In contrast, a partitioning strategy uses many smaller boxes, with each box containing folders for employees hired in a given month.
Using smaller boxes has several advantages. When asked to retrieve the folders for employees hired in June, the HR manager can retrieve the June box. Furthermore, if any small box is temporarily damaged, the other small boxes remain available. Moving offices also becomes easier because instead of moving a single heavy box, the manager can move several small boxes.
From the perspective of an application, only one schema object exists. SQL statements require no modification to access partitioned tables. Partitioning is useful for many different types of database applications, particularly those that manage large volumes of data. Benefits include:
The unavailability of a partition does not entail the unavailability of the object. The query optimizer automatically removes unreferenced partitions from the query plan so queries are not affected when the partitions are unavailable.
Easier administration of schema objects
A partitioned object has pieces that can be managed either collectively or individually. DDL statements can manipulate partitions rather than entire tables or indexes. Thus, you can break up resource-intensive tasks such as rebuilding an index or table. For example, you can move one table partition at a time. If a problem occurs, then only the partition move must be redone, not the table move. Also, dropping a partition avoids executing numerous DELETE statements.
Reduced contention for shared resources in OLTP systems
In some OLTP systems, partitions can decrease contention for a shared resource. For example, DML is distributed over many segments rather than one segment.
Enhanced query performance in data warehouses
In a data warehouse , partitioning can speed processing of ad hoc queries. For example, a sales table containing a million rows can be partitioned by quarter.
Partition Characteristics
Each partition of a table or index must have the same logical attributes, such as column names, data types, and constraints.
For example, all partitions in a table share the same column and constraint definitions. However, each partition can have separate physical attributes, such as the tablespace to which it belongs.
Partition Key
The partition key is a set of one or more columns that determines the partition in which each row in a partitioned table should go. Each row is unambiguously assigned to a single partition.
In the sales table, you could specify the time_id column as the key of a range partition. The database assigns rows to partitions based on whether the date in this column falls in a specified range. Oracle Database automatically directs insert, update, and delete operations to the appropriate partition by using the partition key.
Partitioning Strategies
Oracle Partitioning offers several partitioning strategies that control how the database places data into partitions. The basic strategies are range, list, and hash partitioning.
A single-level partitioning uses only one method of data distribution, for example, only list partitioning or only range partitioning. In composite partitioning , a table is partitioned by one data distribution method and then each partition is further divided into subpartitions using a second data distribution method. For example, you could use a list partition for channel_id and a range subpartition for time_id .
Example 6-1 Sample Row Set for Partitioned Table
This partitioning example assumes that you want to populate a partitioned table sales with the following rows:
Range Partitioning
In range partitioning, the database maps rows to partitions based on ranges of values of the partitioning key. Range partitioning is the most common type of partitioning and is often used with dates.
Suppose that you create time_range_sales as a partitioned table using the following SQL statement, with the time_id column as the partition key:
Afterward, you load time_range_sales with the rows from Example 6-1. The code shows the row distributions in the four partitions. The database chooses the partition for each row based on the time_id value according to the rules specified in the PARTITION BY RANGE clause. The range partition key value determines the non-inclusive high bound for a specified partition.
Interval Partitioning
Interval partitioning is an extension of range partitioning.
If you insert data that exceeds existing range partitions, then Oracle Database automatically creates partitions of a specified interval. For example, you could create a sales history table that stores data for each month in a separate partition.
Interval partitions enable you to avoid creating range partitions explicitly. You can use interval partitioning for almost every table that is range partitioned and uses fixed intervals for new partitions. Unless you create range partitions with different intervals, or unless you always set specific partition attributes, consider using interval partitions.
When partitioning by interval, you must specify at least one range partition. The range partitioning key value determines the high value of the range partitions, which is called the transition point . The database automatically creates interval partitions for data with values that are beyond the transition point. The lower boundary of every interval partition is the inclusive upper boundary of the previous range or interval partition. Thus, in Example 6-2, value 01-JAN-2011 is in partition p2 .
The database creates interval partitions for data beyond the transition point. An interval partition extends range partitioning by instructing the database to create partitions of the specified range or interval. The database automatically creates the partitions when data inserted into the table exceeds all existing range partitions. In Example 6-2, the p3 partition contains rows with partitioning key time_id values greater than or equal to 01-JAN-2013 .
Example 6-2 Interval Partitioning
Assume that you create a sales table with four partitions of varying widths. You specify that above the transition point of January 1, 2013, the database should create partitions in one month intervals. The high bound of partition p3 represents the transition point. Partition p3 and all partitions below it are in the range section, whereas all partitions above it fall into the interval section.
You insert a sale made on date October 10, 2014:
A query of USER_TAB_PARTITIONS shows that the database created a new partition for the October 10 sale because the sale date was later than the transition point:
List Partitioning
In list partitioning, the database uses a list of discrete values as the partition key for each partition. The partitioning key consists of one or more columns.
You can use list partitioning to control how individual rows map to specific partitions. By using lists, you can group and organize related sets of data when the key used to identify them is not conveniently ordered.
Example 6-3 List Partitioning
Assume that you create list_sales as a list-partitioned table using the following statement, where the channel_id column is the partition key:
Afterward, you load the table with the rows from Example 6-1. The code shows the row distribution in the two partitions. The database chooses the partition for each row based on the channel_id value according to the rules specified in the PARTITION BY LIST clause. Rows with a channel_id value of 2 or 4 are stored in the EVEN_CHANNELS partitions, while rows with a channel_id value of 3 or 9 are stored in the ODD_CHANNELS partition.
Hash Partitioning
In hash partitioning, the database maps rows to partitions based on a hashing algorithm that the database applies to the user-specified partitioning key.
The destination of a row is determined by the internal hash function applied to the row by the database. When the number of partitions is a power of 2, the hashing algorithm creates a roughly even distribution of rows across all partitions.
Hash partitioning is useful for dividing large tables to increase manageability. Instead of one large table to manage, you have several smaller pieces. The loss of a single hash partition does not affect the remaining partitions and can be recovered independently. Hash partitioning is also useful in OLTP systems with high update contention. For example, a segment is divided into several pieces, each of which is updated, instead of a single segment that experiences contention.
Assume that you create the partitioned hash_sales table using the following statement, with the prod_id column as the partition key:
Afterward, you load the table with the rows from Example 6-1. The code shows a possible row distribution in the two partitions. The names of these partitions are system-generated.
As you insert rows, the database attempts to randomly and evenly distribute them across partitions. You cannot specify the partition into which a row is placed. The database applies the hash function, whose outcome determines which partition contains the row.
Oracle Database SQL Language Reference for CREATE TABLE . PARTITION BY examples
Reference Partitioning
In reference partitioning , the partitioning strategy of a child table is solely defined through the foreign key relationship with a parent table. For every partition in the parent table, exactly one corresponding partition exists in the child table. The parent table stores the parent records in a specific partition, and the child table stores the child records in the corresponding partition.
For example, an orders table is the parent of the line_items table, with a primary key and foreign key defined on order_id . The tables are partitioned by reference. For example, if the database stores order 233 in partition Q3_2015 of orders , then the database stores all line items for order 233 in partition Q3_2015 of line_items . If partition Q4_2015 is added to orders , then the database automatically adds Q4_2015 to line_items .
The advantages of reference partitioning are:
By using the same partitioning strategy for both the parent and child tables, you avoid duplicating all partitioning key columns. This strategy reduces the manual overhead of denormalization, and saves space.
Maintenance operations on a parent table occur on the child table automatically. For example, when you add a partition to the master table, the database automatically propagates this addition to its descendents.
The database automatically uses partition-wise joins of the partitions in the parent and child table, improving performance.
You can use reference partitioning with all basic partitioning strategies, including interval partitioning. You can also create reference partitioned tables as composite partitioned tables.
Example 6-4 Creating Reference-Partitioned Tables
This example creates a parent table orders which is range-partitioned on order_date . The reference-partitioned child table order_items is created with four partitions, Q1_2015 , Q2_2015 , Q3_2015 , and Q4_2015 , where each partition contains the order_items rows corresponding to orders in the respective parent partition.
Oracle Database VLDB and Partitioning Guide for an overview of reference partitioning
Composite Partitioning
In composite partitioning , a table is partitioned by one data distribution method and then each partition is further subdivided into subpartitions using a second data distribution method. Thus, composite partitioning combines the basic data distribution methods. All subpartitions for a given partition represent a logical subset of the data.
Composite partitioning provides several advantages:
Depending on the SQL statement, partition pruning on one or two dimensions may improve performance.
Queries may be able to use full or partial partition-wise joins on either dimension.
You can perform parallel backup and recovery of a single table.
The number of partitions is greater than in single-level partitioning, which may be beneficial for parallel execution.
You can implement a rolling window to support historical data and still partition on another dimension if many statements can benefit from partition pruning or partition-wise joins.
You can store data differently based on identification by a partitioning key. For example, you may decide to store data for a specific product type in a read-only, compressed format, and keep other product type data uncompressed.
Range, list, and hash partitioning are eligible as subpartitioning strategies for composite partitioned tables. The following figure offers a graphical view of range-hash and range-list composite partitioning.
Figure 6-1 Composite Range-List Partitioning
The database stores every subpartition in a composite partitioned table as a separate segment . Thus, subpartition properties may differ from the properties of the table or from the partition to which the subpartitions belong.
Oracle Database VLDB and Partitioning Guide to learn more about composite partitioning
Partitioned Tables
A partitioned table consists of one or more partitions, which are managed individually and can operate independently of the other partitions.
A table is either partitioned or nonpartitioned. Even if a partitioned table consists of only one partition, this table is different from a nonpartitioned table, which cannot have partitions added to it.
«Partition Characteristics» for examples of partitioned tables
«Overview of Index-Organized Tables» to learn about the purpose and characteristics of Index-Organized Tables, which can also benefit from partitioning that provides improved manageability, availability, and performance.
Segments for Partitioned Tables
A partitioned table is made up of one or more table partition segments.
If you create a partitioned table named hash_products , then no table segment is allocated for this table. Instead, the database stores data for each table partition in its own partition segment. Each table partition segment contains a portion of the table data.
When an external table is partitioned, all partitions reside outside the database. In a hybrid partitioned table, some partitions are stored in segments, whereas others are stored externally. For example, some partitions of the sales table might be stored in data files and others in spreadsheets.
Compression for Partitioned Tables
Some or all partitions of a heap-organized table can be stored in a compressed format.
Compression saves space and can speed query execution. For this reason, compression can be useful in environments such as data warehouses, where the amount of insert and update operations is small, and in OLTP environments.
You can declare the attributes for table compression for a tablespace, table, or table partition. If declared at the tablespace level, then tables created in the tablespace are compressed by default. You can alter the compression attribute for a table, in which case the change only applies to new data going into that table. Consequently, a single table or partition may contain compressed and uncompressed blocks, which guarantees that data size will not increase because of compression. If compression could increase the size of a block, then the database does not apply it to the block.
«Table Compression» to learn about types of table compression, including basic, advanced row, and Hybrid Columnar Compression
Oracle Database Data Warehousing Guide to learn about table compression in a data warehouse
Partitioned Indexes
A partitioned index is an index that, like a partitioned table, has been divided into smaller and more manageable pieces.
Global indexes are partitioned independently of the table on which they are created, whereas local indexes are automatically linked to the partitioning method for a table. Like partitioned tables, partitioned indexes improve manageability, availability, performance, and scalability.
The following graphic shows index partitioning options.
Figure 6-2 Index Partitioning Options
«Introduction to Indexes» to learn about the difference between unique and nonunique indexes, and the different index types
Oracle Database VLDB and Partitioning Guide for more information about partitioned indexes and how to decide which type to use
Local Partitioned Indexes
In a local partitioned index, the index is partitioned on the same columns, with the same number of partitions and the same partition bounds as its table.
Each index partition is associated with exactly one partition of the underlying table, so that all keys in an index partition refer only to rows stored in a single table partition. In this way, the database automatically synchronizes index partitions with their associated table partitions, making each table-index pair independent.
Local partitioned indexes are common in data warehousing environments. Local indexes offer the following advantages:
Availability is increased because actions that make data invalid or unavailable in a partition affect this partition only.
Partition maintenance is simplified. When moving a table partition, or when data ages out of a partition, only the associated local index partition must be rebuilt or maintained. In a global index, all index partitions must be rebuilt or maintained.
If point-in-time recovery of a partition occurs, then the indexes can be recovered to the recovery time (see Oracle Database Backup and Recovery User’s Guide ). The entire index does not need to be rebuilt.
The example in Hash Partitioning shows the creation statement for the partitioned hash_sales table, using the prod_id column as partition key. The following example creates a local partitioned index on the time_id column of the hash_sales table:
In Figure 6-3, the hash_products table has two partitions, so hash_sales_idx has two partitions. Each index partition is associated with a different table partition. Index partition SYS_P38 indexes rows in table partition SYS_P33 , whereas index partition SYS_P39 indexes rows in table partition SYS_P34 .
Figure 6-3 Local Index Partitions
You cannot explicitly add a partition to a local index. Instead, new partitions are added to local indexes only when you add a partition to the underlying table. Likewise, you cannot explicitly drop a partition from a local index. Instead, local index partitions are dropped only when you drop a partition from the underlying table.
Like other indexes, you can create a bitmap index on partitioned tables. The only restriction is that bitmap indexes must be local to the partitioned table—they cannot be global indexes. Global bitmap indexes are supported only on nonpartitioned tables.
Local Prefixed and Nonprefixed Indexes
Local partitioned indexes are either prefixed or nonprefixed.
The index subtypes are defined as follows:
Local prefixed indexes
In this case, the partition keys are on the leading edge of the index definition. In the time_range_sales example in Range Partitioning, the table is partitioned by range on time_id . A local prefixed index on this table would have time_id as the first column in its list.
Local nonprefixed indexes
In this case, the partition keys are not on the leading edge of the indexed column list and need not be in the list at all. In the hash_sales_idx example in Local Partitioned Indexes, the index is local nonprefixed because the partition key product_id is not on the leading edge.
Both types of indexes can take advantage of partition elimination (also called partition pruning ), which occurs when the optimizer speeds data access by excluding partitions from consideration. Whether a query can eliminate partitions depends on the query predicate . A query that uses a local prefixed index always allows for index partition elimination, whereas a query that uses a local nonprefixed index might not.
Oracle Database VLDB and Partitioning Guide to learn how to use prefixed and nonprefixed indexes
Local Partitioned Index Storage
Like a table partition, a local index partition is stored in its own segment. Each segment contains a portion of the total index data. Thus, a local index made up of four partitions is not stored in a single index segment, but in four separate segments.
Global Partitioned Indexes
A global partitioned index is a B-tree index that is partitioned independently of the underlying table on which it is created. A single index partition can point to any or all table partitions, whereas in a locally partitioned index, a one-to-one parity exists between index partitions and table partitions.
In general, global indexes are useful for OLTP applications, where rapid access, data integrity, and availability are important. In an OLTP system, a table may be partitioned by one key, for example, the employees.department_id column, but an application may need to access the data with many different keys, for example, by employee_id or job_id . Global indexes can be useful in this scenario.
As an illustration, suppose that you create a global partitioned index on the time_range_sales table from «Range Partitioning» . In this table, rows for sales from 1998 are stored in one partition, rows for sales from 1999 are in another, and so on. The following example creates a global index partitioned by range on the channel_id column:
As shown in Figure 6-4, a global index partition can contain entries that point to multiple table partitions. Index partition p1 points to the rows with a channel_id of 2, index partition p2 points to the rows with a channel_id of 3, and index partition p3 points to the rows with a channel_id of 4 or 9.
Figure 6-4 Global Partitioned Index
Oracle Database VLDB and Partitioning Guide to learn how to manage global partitioned indexes
Oracle Database SQL Language Reference to learn about the GLOBAL PARTITION clause of CREATE INDEX
Partial Indexes for Partitioned Tables
A partial index is an index that is correlated with the indexing properties of an associated partitioned table.
The correlation enables you to specify which table partitions are indexed. Partial indexes provide the following advantages:
Table partitions that are not indexed avoid consuming unnecessary index storage space.
Performance of loads and queries can improve.
Before Oracle Database 12c , an exchange partition operation required a physical update of an associated global index to retain it as usable. Starting with Oracle Database 12c , if the partitions involved in a partition maintenance operation are not part of a partial global index, then the index remains usable without requiring any global index maintenance.
If you index only some table partitions at index creation, and if you later index other partitions, then you can reduce the sort space required by index creation.
You can turn indexing on or off for the individual partitions of a table. A partial local index does not have usable index partitions for all table partitions that have indexing turned off. A global index, whether partitioned or not, excludes the data from all partitions that have indexing turned off. The database does not support partial indexes for indexes that enforce unique constraints.
Figure 6-5 shows the same global index as in Figure 6-4, except that the global index is partial. Table partitions SALES_1998 and SALES_2000 have the indexing property set to OFF , so the partial global index does not index them.
Figure 6-5 Partial Global Partitioned Index

Description of «Figure 6-5 Partial Global Partitioned Index»
Overview of Sharded Tables
In an Oracle database, sharding enables you to break up a large table into more manageable pieces called shards that can be stored in multiple databases.
Each database is hosted on a dedicated server with its own local resources — CPU, memory, flash, or disk. Each database in such configuration is called a shard. All of the shards together make up a single logical database, which is referred to as a sharded database.
Horizontal partitioning involves splitting a database table across shards so that each shard contains the table with the same columns but a different subset of rows. A table split up in this manner is also known as a sharded table.
The following figure shows a table horizontally partitioned across three shards.
Figure 6-6 Horizontal Partitioning of a Table Across Shards
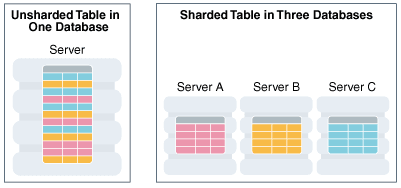
Description of «Figure 6-6 Horizontal Partitioning of a Table Across Shards»
Sharding is based on shared-nothing hardware infrastructure and it eliminates single points of failure because shards do not share physical resources such as CPU, memory, or storage devices. Shards are also loosely coupled in terms of software; they do not run clusterware.
Shards are typically hosted on dedicated servers. These servers can be commodity hardware or engineered systems. The shards can run on single instance or Oracle RAC databases. They can be placed on-premises, in a cloud, or in a hybrid on-premises and cloud configuration.
From the perspective of a database administrator, an SDB consists of multiple databases that can be managed either collectively or individually. However, from the perspective of the application, an SDB looks like a single database: the number of shards and distribution of data across those shards are completely transparent to database applications.
Sharding is intended for custom OLTP applications that are suitable for a sharded database architecture. Applications that use sharding must have a well-defined data model and data distribution strategy (consistent hash, range, list, or composite) that primarily accesses data using a sharding key. Examples of a sharding key include customer_id , account_no , or country_id .
Sharded Tables
A sharded table is a table that is partitioned into smaller and more manageable pieces among multiple databases, called shards.
Partitions are distributed across shards at the tablespace level, based on a sharding key. Examples of keys include customer ID, account number, and country ID. The following data types are supported for the sharding key.
Database table partitioning in SQL Server
Partitioning is the database process where very large tables are divided into multiple smaller parts. By splitting a large table into smaller, individual tables, queries that access only a fraction of the data can run faster because there is less data to scan. The main of goal of partitioning is to aid in maintenance of large tables and to reduce the overall response time to read and load data for particular SQL operations.
Vertical Partitioning on SQL Server tables
Vertical table partitioning is mostly used to increase SQL Server performance especially in cases where a query retrieves all columns from a table that contains a number of very wide text or BLOB columns. In this case to reduce access times the BLOB columns can be split to its own table. Another example is to restrict access to sensitive data e.g. passwords, salary information etc. Vertical partitioning splits a table into two or more tables containing different columns:
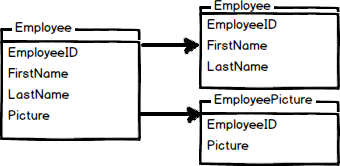
An example of vertical partitioning
An example for vertical partitioning can be a large table with reports for employees containing basic information, such as report name, id, number of report and a large column with report description. Assuming that
95% of users are searching on the part of the report name, number, etc. and that only
5% of requests are opening the reports description field and looking to the description. Let’s assume that all those searches will lead to the clustered index scans and since the index scan reads all rows in the table the cost of the query is proportional to the total number of rows in the table and our goal is to minimize the number of IO operations and reduce the cost of the search.
Let’s see the example on the EmployeeReports table:
If we run a SQL query to pull ReportID , ReportName , ReportNumber data from the EmployeeReports table the result set that a scan count is 5 and represents a number of times that the table was accessed during the query, and that we had 113,288 logical reads that represent the total number of page accesses needed to process the query:
As indicated, every page is read from the data cache, whether or not it was necessary to bring that page from disk into the cache for any given read. To reduce the cost of the query we will change the SQL Server database schema and split the EmployeeReports table vertically.
Next we’ll create the ReportsDesc table and move the large ReportDescription column, and the ReportsData table and move all data from the EmployeeReports table except the ReportDescription column:
The same search query will now give different results:
Vertical partitioning on SQL Server tables may not be the right method in every case. However, if you have, for example, a table with a lot of data that is not accessed equally, tables with data you want to restrict access to, or scans that return a lot of data, vertical partitioning can help.
Horizontal Partitioning on SQL Server tables
Horizontal partitioning divides a table into multiple tables that contain the same number of columns, but fewer rows. For example, if a table contains a large number of rows that represent monthly reports it could be partitioned horizontally into tables by years, with each table representing all monthly reports for a specific year. This way queries requiring data for a specific year will only reference the appropriate table. Tables should be partitioned in a way that queries reference as few tables as possible.
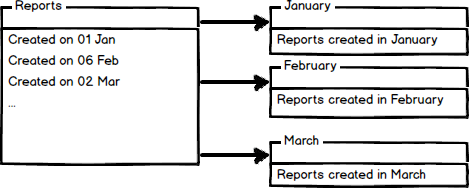
Tables are horizontally partitioned based on a column which will be used for partitioning and the ranges associated to each partition. Partitioning column is usually a datetime column but all data types that are valid for use as index columns can be used as a partitioning column, except a timestamp column. The ntext, text, image, xml, varchar(max), nvarchar(max), or varbinary(max), Microsoft .NET Framework common language runtime (CLR) user-defined type, and alias data type columns cannot be specified.
There are two different approaches we could use to accomplish table partitioning. The first is to create a new partitioned table and then simply copy the data from your existing table into the new table and do a table rename. The second approach is to partition an existing table by rebuilding or creating a clustered index on the table.
An example of horizontal partitioning with creating a new partitioned table
SQL Server 2005 introduced a built-in partitioning feature to horizontally partition a table with up to 1000 partitions in SQL Server 2008, and 15000 partitions in SQL Server 2012, and the data placement is handled automatically by SQL Server. This feature is available only in the Enterprise Edition of SQL Server.
To create a partitioned table for storing monthly reports we will first create additional filegroups. A filegroup is a logical storage unit. Every database has a primary filegroup that contains the primary data file (.mdf). An additional, user-defined, filegrups can be created to contain secondary files (.ndf). We will create 12 filegroups for every month:
Database Partitioning

Partitioning is the database process where tables are split into multiple smaller parts ensuring queries run faster because there is fewer data to scan. The main goal of partitioning is to aid in the maintenance of large tables and to reduce the overall response time to read and load data for particular SQL operations.
Vertical Partitioning
An example of vertical partitioning is where we have a large table for students containing basic information, such as name, id, class, paid fees and a large column with bio information. Assuming that most time, the administration search on the student name, number and the less time is spent on opening the bio field and looking to the description.
We can splitting this into two table, one that has bio data and the other table with the otheer frequestly retrieved data
Horizontal Partitioning
Horizontal partitioning divides a table into multiple tables that contain the same number of columns, but fewer rows. For example, in our students it could be partitioned horizontally into tables by student age, with each table representing certain age.
In MySQL you can partition a table using CREATE TABLE or ALTER TABLE command. See the following CREATE TABLE syntax :
CREATE [TEMPORARY] TABLE [IF NOT EXISTS] tbl_name
(create_definition,…)
[table_options]
[partition_options]
partition_options:
Types of MySQL partitioning
RANGE Partitioning
In MySQL, RANGE partitioning we specify various ranges for which data is assigned. Ranges should be contiguous but not overlapping, and are defined using the VALUES LESS THAN operator.
In our student table we can partition by different age as follows:
CREATE TABLE students
(
atudentId INT NOT NULL,
firstname VARCHAR(15) NOT NULL,
lastname VARCHAR(15) NOT NULL,
age INT NOT NULL
)
PARTITION BY RANGE (AGE(age))(
PARTITION p0 VALUES LESS THAN (AGE(‘14’)),
PARTITION p1 VALUES LESS THAN (AGE(‘14’)),
PARTITION p2 VALUES LESS THAN (AGE(‘14’)),
PARTITION p3 VALUES LESS THAN (AGE(‘14’)));
LIST Partitioning
List partition allows us to segment data based on a pre-defined set of values (e.g. 1, 2, 3). This is done by using PARTITION BY LIST(expr) where expr is a column value and then defining each partition by means of a VALUES IN (value_list), where value_list is a comma-separated list of integers.
We can partitions our table with different students from different classes as follows
CREATE TABLE students
(
atudentId INT NOT NULL,
firstname VARCHAR(15) NOT NULL,
lastname VARCHAR(15) NOT NULL,
age INT NOT NULL,
class VARCHAR(15) NOT NULL,
)
PARTITION BY LIST(class) (
PARTITION pA VALUES IN (1-East,2-East,3-East),
PARTITION pB VALUES IN (1-North,2-North,3-North),
PARTITION pC VALUES IN (1-South,2-South,3-South));
HASH Partitioning
HASH partition is used to distribute data among a predefined number of partitions on a column value or expression based on a column value. This is done by using PARTITION BY HASH(expr) clause, adding in CREATE TABLE STATEMENT.
In PARTITIONS num clause, num is a positive integer represents the number of partitions of the table. The following statement creates a table that uses hashing on the studetn_id column and is divided into 4 partitions :
CREATE TABLE students
(
atudentId INT NOT NULL,
firstname VARCHAR(15) NOT NULL,
lastname VARCHAR(15) NOT NULL,
age INT NOT NULL,
class VARCHAR(15) NOT NULL,
)
PARTITION BY HASH(studentid)
PARTITIONS 4;