# Indexes
Indexes are a data structure that contains pointers to the contents of a table arranged in a specific order, to help the database optimize queries. They are similar to the index of book, where the pages (rows of the table) are indexed by their page number.
Several types of indexes exist, and can be created on a table. When an index exists on the columns used in a query’s WHERE clause, JOIN clause, or ORDER BY clause, it can substantially improve query performance.
# Creating an Index
This will create an index for the column EmployeeId in the table Cars. This index will improve the speed of queries asking the server to sort or select by values in EmployeeId, such as the following:
The index can contain more than 1 column, as in the following;
In this case, the index would be useful for queries asking to sort or select by all included columns, if the set of conditions is ordered in the same way. That means that when retrieving the data, it can find the rows to retrieve using the index, instead of looking through the full table.
For example, the following case would utilize the second index;
If the order differs, however, the index does not have the same advantages, as in the following;
The index is not as helpful because the database must retrieve the entire index, across all values of EmployeeId and CarID, in order to find which items have OwnerId = 17 .
(The index may still be used; it may be the case that the query optimizer finds that retrieving the index and filtering on the OwnerId , then retrieving only the needed rows is faster than retrieving the full table, especially if the table is large.)
# Clustered, Unique, and Sorted Indexes
Indexes can have several characteristics that can be set either at creation, or by altering existing indexes.
The above SQL statement creates a new clustered index on Employees. Clustered indexes are indexes that dictate the actual structure of the table; the table itself is sorted to match the structure of the index. That means there can be at most one clustered index on a table. If a clustered index already exists on the table, the above statement will fail. (Tables with no clustered indexes are also called heaps.)
This will create an unique index for the column Email in the table Customers. This index, along with speeding up queries like a normal index, will also force every email address in that column to be unique. If a row is inserted or updated with a non-unique Email value, the insertion or update will, by default, fail.
This creates an index on Customers which also creates a table constraint that the EmployeeID must be unique. (This will fail if the column is not currently unique — in this case, if there are employees who share an ID.)
This creates an index that is sorted in descending order. By default, indexes (in MSSQL server, at least) are ascending, but that can be changed.
# Sorted Index
If you use an index that is sorted the way you would retrieve it, the SELECT statement would not do additional sorting when in retrieval.
When you execute the query
The database system would not do additional sorting, since it can do an index-lookup in that order.
# Dropping an Index, or Disabling and Rebuilding it
We can use command DROP to delete our index. In this example we will DROP the index called ix_cars_employee_id on the table Cars.
This deletes the index entirely, and if the index is clustered, will remove any clustering. It cannot be rebuilt without recreating the index, which can be slow and computationally expensive. As an alternative, the index can be disabled:
This allows the table to retain the structure, along with the metadata about the index.
Critically, this retains the index statistics, so that it is possible to easily evaluate the change. If warranted, the index can then later be rebuilt, instead of being recreated completely;
# Partial or Filtered Index
SQL Server and SQLite allow to create indexes that contain not only a subset of columns, but also a subset of rows.
Consider a constant growing amount of orders with order_state_id equal to finished (2), and a stable amount of orders with order_state_id equal to started (1).
If your business make use of queries like this:
Partial indexing allows you to limit the index, including only the unfinished orders:
This index will be smaller than an unfiltered index, which saves space and reduces the cost of updating the index.
# Inserting with a Unique Index
This will fail if an unique index is set on the Email column of Customers. However, alternate behavior can be defined for this case:
# Rebuild index
Over the course of time B-Tree indexes may become fragmented because of updating/deleting/inserting data. In SQLServer terminology we can have internal (index page which is half empty ) and external (logical page order doesn’t correspond physical order). Rebuilding index is very similar to dropping and re-creating it.
We can re-build an index with
By default rebuilding index is offline operation which locks the table and prevents DML against it , but many RDBMS allow online rebuilding. Also, some DB vendors offer alternatives to index rebuilding such as REORGANIZE (SQLServer) or COALESCE / SHRINK SPACE (Oracle).
# SAP ASE: Drop index
This command will drop index in the table. It works on SAP ASE server.
Syntax:
Example:
# Unique Index that Allows NULLS
This schema allows for a 0..1 relationship — people can have zero or one driving licenses and each license can only belong to one person
# Clustered index
When using clustered index, the rows of the table are sorted by the column to which the clustered index is applied. Therefore, there can be only one clustered index on the table because you can’t order the table by two different columns.
Generally, it is best to use clustered index when performing reads on big data tables. The donwside of clustered index is when writing to table and data need to be reorganized (resorted).
An example of creating a clustered index on a table Employees on column Employee_Surname:
# Non clustered index
Nonclustered indexes are stored separately from the table. Each index in this structure contains a pointer to the row in the table which it represents.
This pointers are called a row locators. The structure of the row locator depends on whether the data pages are stored in a heap or a clustered table. For a heap, a row locator is a pointer to the row. For a clustered table, the row locator is the clustered index key.
An example of creating a non clustered index on table Employees and column Employee_Surname:
There can be multiple nonclustered indexes on the table. The read operations are generally slower with non clustered indexes than with clustered indexes as you have to go first to index and than to the table. There are no restrictions in write operations however.
# Remarks
Indexes are a way of speeding up read queries by sorting the rows of a table according to a column.
The effect of an index is not noticeable for small databases like the example, but if there are a large number of rows, it can greatly improve performance. Instead of checking every row of the table, the server can do a binary search on the index.
The tradeoff for creating an index is write speed and database size. Storing the index takes space. Also, every time an INSERT is done or the column is updated, the index must be updated. This is not as expensive an operation as scanning the entire table on a SELECT query, but it is still something to keep in mind.
Основы индексов в SQL Server
Одним из важнейших путей достижения высокой производительности SQL Server является использование индексов. Индекс ускоряет процесс запроса, предоставляя быстрый доступ к строкам данных в таблице, аналогично тому, как указатель в книге помогает вам быстро найти необходимую информацию. В этой статье я приведу краткий обзор индексов в SQL Server и объясню как они организованы в базе данных и как они помогают ускорению выполнения запросов к базе данных.
Структура индекса
Индексы создаются для столбцов таблиц и представлений. Индексы предоставляют путь для быстрого поиска данных на основе значений в этих столбцах. Например, если вы создадите индекс по первичному ключу, а затем будете искать строку с данными, используя значения первичного ключа, то SQL Server сначала найдет значение индекса, а затем использует индекс для быстрого нахождения всей строки с данными. Без индекса будет выполнен полный просмотр (сканирование) всех строк таблицы, что может оказать значительное влияние на производительность.
Вы можете создать индекс на большинстве столбцов таблицы или представления. Исключением, преимущественно, являются столбцы с типами данных для хранения больших объектов (LOB), таких как image, text или varchar(max). Вы также можете создать индексы на столбцах, предназначенных для хранения данных в формате XML, но эти индексы устроены немного иначе, чем стандартные и их рассмотрение выходит за рамки данной статьи. Также в статье не рассматриваются columnstore индексы. Вместо этого я фокусируюсь на тех индексах, которые наиболее часто применяются в базах данных SQL Server.
Индекс состоит из набора страниц, узлов индекса, которые организованы в виде древовидной структуры — сбалансированного дерева. Эта структура является иерархической по своей природе и начинается с корневого узла на вершине иерархии и конечных узлов, листьев, в нижней части, как показано на рисунке: 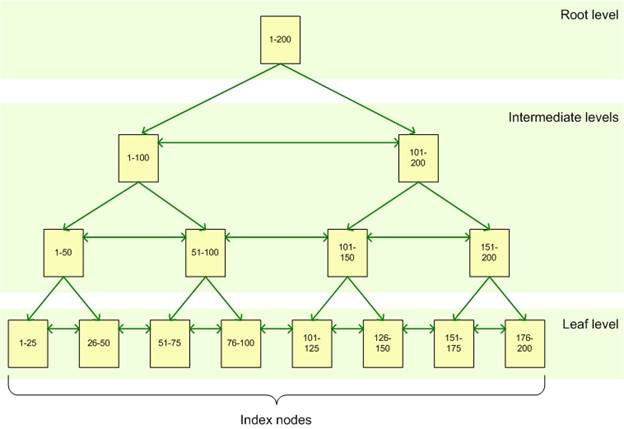
Когда вы формируете запрос на индексированный столбец, подсистема запросов начинает идти сверху от корневого узла и постепенно двигается вниз через промежуточные узлы, при этом каждый слой промежуточного уровня содержит более детальную информацию о данных. Подсистема запросов продолжает двигаться по узлам индекса до тех пор, пока не достигнет нижнего уровня с листьями индекса. К примеру, если вы ищете значение 123 в индексированном столбе, то подсистема запросов сначала на корневом уровне определит страницу на первом промежуточном (intermediate) уровне. В данном случае первой страница указывает на значение от 1 до 100, а вторая от 101 до 200, таким образом подсистема запросов обратится ко второй странице этого промежуточного уровня. Далее будет выяснено, что следует обратиться к третьей странице следующего промежуточного уровня. Отсюда подсистема запросов прочитает на нижнем уровне значение самого индекса. Листья индекса могут содержать как сами данные таблицы, так и просто указатель на строки с данными в таблице, в зависимости от типа индекса: кластеризованный индекс или некластеризованный.
Кластеризованный индекс
Кластеризованный индекс хранит реальные строки данных в листьях индекса. Возвращаясь к предыдущему примеру, это означает что строка данных, связанная со значение ключа, равного 123 будет храниться в самом индексе. Важной характеристикой кластеризованного индекса является то, что все значения отсортированы в определенном порядке либо возрастания, либо убывания. Таким образом, таблица или представление может иметь только один кластеризованный индекс. В дополнение следует отметить, что данные в таблице хранятся в отсортированном виде только в случае если создан кластеризованный индекс у этой таблицы.
Таблица не имеющая кластеризованного индекса называется кучей.
Некластеризованный индекс
В отличие от кластеризованного индекса, листья некластеризованного индекса содержат только те столбцы (ключевые), по которым определен данный индекс, а также содержит указатель на строки с реальными данными в таблице. Это означает, что системе подзапросов необходима дополнительная операция для обнаружения и получения требуемых данных. Содержание указателя на данные зависит от способа хранения данных: кластеризованная таблица или куча. Если указатель ссылается на кластеризованную таблицу, то он ведет к кластеризованному индексу, используя который можно найти реальные данные. Если указатель ссылается на кучу, то он ведет к конкретному идентификатору строки с данными. Некластеризованные индексы не могут быть отсортированы в отличие от кластеризованных, однако вы можете создать более одного некластеризованного индекса на таблице или представлении, вплоть до 999. Это не означает, что вы должны создавать как можно больше индексов. Индексы могут как улучшить, так и ухудшить производительность системы. В дополнение к возможности создать несколько некластеризованных индексов, вы можете также включить дополнительные столбцы (included column) в свой индекс: на листьях индекса будет храниться не только значение самих индексированных столбцов, но и значения этих не индексированных дополнительных столбцов. Этот подход позволит вам обойти некоторые ограничения, наложенные на индекс. К примеру, вы можете включить неидексируемый столбец или обойти ограничение на длину индекса (900 байт в большинстве случаев).
Типы индексов
В дополнение к тому, что индекс может быть либо кластеризованным, либо некластеризованным, возможно его дополнительно сконфигурировать как составной индекс, уникальный индекс или покрывающий индекс.
Составной индекс
Такой индекс может содержать более одного столбца. Вы можете включить до 16 столбцов в индекс, но их общая длина ограничена 900 байтами. Как кластеризованный, так и некластеризованный индексы могут быть составными.
Уникальный индекс
- Первичный ключ
Когда вы определяете ограничение первичного ключа на один или несколько столбцов, тогда SQL Server автоматически создаёт уникальный кластеризованный индекс, если кластеризованный индекс не был создан ранее (в этом случае создается уникальный некластеризованный индекс по первичному ключу) - Уникальность значений
Когда вы определяете ограничение на уникальность значений, тогда SQL Server автоматически создает уникальный некластеризованный индекс. Вы можете указать, чтобы был создан уникальный кластеризованный индекс, если кластеризованного индекса до сих пор не было создано на таблице
Покрывающий индекс
Такой индекс позволяет конкретному запросу сразу получить все необходимые данные с листьев индекса без дополнительных обращений к записям самой таблицы.
Проектирование индексов
Насколько полезны индексы могут быть, настолько аккуратно они должны быть спроектированы. Поскольку индексы могут занимать значительное дисковое пространство, вы не захотите создавать индексов больше, чем необходимо. В дополнение, индексы автоматически обновляются когда сама строка с данными обновляется, что может привести к дополнительным накладным расходам ресурсов и падению производительности. При проектирование индексов должно приниматься во внимание несколько соображений относительно базы данных и запросов к ней.
База данных
- Для таблиц которые часто обновляются используйте как можно меньше индексов.
- Если таблица содержит большое количество данных, но их изменения незначительны, тогда используйте столько индексов, сколько необходимо для улучшение производительности ваших запросов. Однако хорошо подумайте перед использованием индексов на небольших таблицах, т.к. возможно использование поиска по индексу может занять больше времени, нежели простое сканирование всех строк.
- Для кластеризованных индексов старайтесь использовать настолько короткие поля насколько это возможно. Наилучшим образом будет применение кластеризованного индекса на столбцах с уникальными значениями и не позволяющими использовать NULL. Вот почему первичный ключ часто используется как кластеризованный индекс.
- Уникальность значений в столбце влияет на производительность индекса. В общем случае, чем больше у вас дубликатов в столбце, тем хуже работает индекс. С другой стороны, чем больше уникальных значения, тем выше работоспособность индекса. Когда возможно используйте уникальный индекс.
- Для составного индекса возьмите во внимание порядок столбцов в индексе. Столбцы, которые используются в выражениях WHERE (к примеру, WHERE FirstName = ‘Charlie’) должны быть в индексе первыми. Последующие столбцы должны быть перечислены с учетом уникальности их значений (столбцы с самым высоким количеством уникальных значений идут первыми).
- Также можно указать индекс на вычисляемых столбцах, если они соответствуют некоторым требованиям. К примеру, выражение которые используются для получения значения столбца, должны быть детерминистическими (всегда возвращать один и тот же результат для заданного набора входных параметров).
Запросы к базе данных
- Старайтесь вставлять или модифицировать в одном запросе как можно больше строк, а не делать это в несколько одиночных запросов.
- Создайте некластеризованный индекс на столбцах которые часто используются в ваших запросах в качестве условий поиска в WHERE и соединения в JOIN.
- Рассмотрите возможность индексирования столбцов, использующихся в запросах поиска строк на точное соответствие значений.
А теперь, собственно:
14 вопросов об индексах в SQL Server, которые вы стеснялись задать
Почему таблица не может иметь два кластеризованных индекса?
Хотите короткий ответ? Кластеризованный индекс – это и есть таблица. Когда вы создаете кластеризованный индекс у таблицы, подсистема хранения данных сортирует все строки в таблице в порядке возрастания или убывания, согласно определению индекса. Кластеризованный индекс это не отдельная сущность как другие индексы, а механизм сортировки данных в таблице и облегчения быстрого доступа к строкам с данными.
Представим, что у вас есть таблица, содержащая историю операций по продажам. Таблица Sales включает в себя такую информация как идентификатор заказа, позицию товара в заказе, номер товара, количество товара, номер и дату заказа и т.д. Вы создаёте кластеризованный индекс по столбцам OrderID и LineID, с сортировкой в порядке возрастания, как показано в следующем T-SQL коде:
Когда вы запустите этот скрипт все строки в таблице будут физически отсортированы сначала по столбцу OrderID, а затем по LineID, но сами данные останутся в единственном логическом блоке, в таблице. По этой причине вы не можете создать два кластеризованных индекса. Может быть только одна таблица с одними данными и эта таблица может быть отсортирована только один раз в определенном порядке.
Если кластеризованная таблица даёт множество преимуществ, то зачем использовать кучу?
Вы правы. Кластеризованые таблицы отличны и большинство ваших запросов будут лучше выполнятся к таблицам, имеющим кластеризованный индекс. Но в некоторых случаях вы возможно захотите оставить таблицы в их естественном первозданном состоянии, т.е. в виде кучи, и создать лишь некластеризованные индексы для поддержания работоспособности ваших запросов.
Куча, как вы помните, хранит данные в случайном порядке. Обычно подсистема хранения данных добавляет в таблицу данные в той последовательности в которой они вставляются, однако подсистема также любит перемещать строки с целью более эффективного хранения. В результате у вас нет ни единого шанса предсказать в каком порядке будут храниться данные.
Если подсистема запросов должна найти данные без преимуществ некластеризованного индекса, то она сделает полное сканирование таблицы для нахождения нужных ей строк. На очень маленьких таблицах это обычно не проблема, но как только куча растет в своих размерах производительность быстро падает. Конечно, некластеризованный индекс может помочь, используя указатель на файл, страницу и строку где хранятся необходимые данные – обычно это намного лучшая альтернатива сканированию таблицы. Но даже в этом случае трудно сравнивать с преимуществами кластеризованного индекса при рассмотрении производительности запросов.
Однако куча может помочь улучшить производительность в определенных ситуациях. Рассмотрим таблицу с большим количеством вставок, но редкими обновлениями или удалением данных. К примеру, таблица, хранящая лог, преимущественно используется для вставки значений до тех пор пока не будет архивирована. В куче вы не увидите разбиением страниц и фрагментацию данных, как это случается с кластеризованным индексом, потому что строки просто добавляются в конец кучи. Слишком большое разделение страниц может иметь значительное влияние на производительность и в не самом хорошем смысле. В общем, куча позволяет производить вставку данных относительно безболезненно и вам не надо будет бороться с накладными расходами на хранение и обслуживание, как это бывает в случае кластеризованного индекса.
Но отсутствие обновления и удаления данных не должны рассматриваться как единственная причина. Способ выборки данных также является важным фактором. К примеру, вы не должны использовать кучу, если часто выполняете запросы диапазонов данных или запрашиваемые данные часто должны быть сортированы или сгруппированы.
Всё это означает, что вы должны рассматривать возможность использования кучи только когда работаете с особо-маленькими таблицами или всё ваше взаимодействие с таблицей ограничено вставкой данных и ваши запросы чрезвычайно просты (и вы все-равно используете некластеризованные индексы). В противном случае держитесь хорошо спроектированного кластеризованного индекса, к примеру определенного на простом возрастающем ключевом поле, как широко применяемый столбец с IDENTITY.
Как изменить установленное по умолчанию значение коэффициента заполнения индекса?
Изменение установленного по умолчанию коэффициента заполнения индекса это одно дело. Понимание того как установленный по умолчанию коэффициент работает это другое. Но сначала пару шагов назад. Коэффициент заполнения индекса определяет количество пространства на странице для хранения индекса на нижнем уровне (уровень листьев) перед тем как начать заполнять новую страницу. К примеру, если коэффициент выставлен в значение 90, то при росте индекс займет на странице 90%, а затем перейдет на следующую страницу.
По умолчанию, значение коэффициента заполнения индекса в SQL Server равно 0, что равнозначно значению 100. В результате все новые индексы автоматически наследуют эту настройки, если вы специально в коде не укажете отличное от стандартного для системы значения или измените поведение по умолчанию. Вы можете воспользоваться SQL Server Management Studio для корректировки установленного по умолчанию значения или запустить системную сохраненную процедуру sp_configure. К примеру, следующий набор T-SQL команд устанавливает значение коэффициента равное 90 (предварительно необходимо переключится в режим продвинутых настроек):
После изменения значения коэффициента заполнения индекса необходимо перезагрузить сервис SQL Server. Теперь вы можете проверить установленное значение, запустив процедуру sp_configure без указанного второго аргумента:
Данная команда должна вернуть значение равное 90. В результате все вновь создаваемые индексы будут использовать это значение. Вы можете проверить это, создав индекс и запросить значение коэффициента заполнения:
В данном примере мы создали некластеризованный индекс в таблице Person в базе данных AdventureWorks2012. После создания индекса мы можем получить значение коэффициента заполнения из системной таблиц sys.indexes. Запрос должен вернуть 90.
Однако, представим, что мы удалили индекс и снова создали его, но теперь указали конкретное значение коэффициента заполнения:
В этот раз мы добавили инструкцию WITH и опцию fillfactor для нашей операции создания индекса CREATE INDEX и указали значение 80. Оператор SELECT теперь возвращает соответствующее значение.
До сих пор всё было довольно-таки прямолинейно. Где вы реально можете погореть во всём этом процессе, так это когда вы создаёте индекс, использующий значение коэффициента по умолчанию, подразумевая, что вы знаете это значение. К примеру, кто-то неумело ковыряется в настройках сервера и он настолько упорот, что ставит значение коэффициента заполнения индекса равное 20. Тем временем вы продолжаете создавать индексы, предполагая значение по умолчанию равное 0. К сожалению, у вас нет способа узнать значение коэффициента до тех пор как вы не создадите индекс, а затем проверите значение, как мы делали в наших примерах. В противном случае, вам придётся ждать момента когда производительность запросов настолько упадёт, что вы начнёте что-то подозревать.
Другая проблема о которой вам стоит помнить это перестроение индексов. Как и при создании индекса вы можете конкретизировать значение коэффициента заполнения индекса, когда его перестраиваете. Однако, в отличие от команды создания индекса, перестройка не использует серверные настройки по умолчанию, несмотря на то что так может показаться. Даже больше, если вы конкретно не укажете значение коэффициента заполнения индекса, то SQL Server будет использовать то значение коэффициента, с которым этот индекс существовал до его перестройки. К примеру, следующая операция ALTER INDEX перестраивает только что созданный нами индекс:
Когда мы проверим значение коэффициента заполнения мы получим значение равное 80, потому что именно его мы указали при последнем создании индекса. Значение по умолчанию не учитывается.
Как вы видите изменить значение коэффициента заполнения индекса не такое уж сложно дело. Намного сложнее знать текущее значение и понимать когда оно применяется. Если вы всегда конкретно указывается коэффициент при создании и перестройки индексов, то вы всегда знаете конкретный результат. Разве что вам приходится заботиться о том, чтобы кто-то другой снова не напортачил в настройках сервера, вызвав перестройку всех индексов со смехотворно низким значением коэффициента заполнения индекса.
Можно ли создать кластеризованный индекс на столбце, содержащем дубликаты?
И да, и нет. Да вы можете создать кластеризованный индекс на ключевом столбце, содержащем дубликаты значений. Нет, значение ключевого столбца не смогут остаться в состоянии не уникальности. Позвольте объяснить. Если вы создаёте неуникальный кластерный индекс (non-unique clustered index) на столбце, то подсистема хранения данных добавляет к дублирующему значению целочисленное значение (uniquifier), чтобы удостовериться в уникальности и, соответственно, обеспечить возможность идентифицировать каждую строку в кластеризованной таблице.
К примеру, вы можете решить создать в таблице с данными о клиентах кластеризованный индекс по столбцу LastName, хранящим фамилию. Столбец содержит такие значения как Franklin, Hancock, Washington и Smith. Затем вы вставляете значения Adams, Hancock, Smith и снова Smith. Но значение ключевого столбца обязательно должны быть уникальны, поэтому подсистема хранения данных изменит значение дубликатов таким образом, что они будут выглядеть примерно так: Adams, Franklin, Hancock, Hancock1234, Washington, Smith, Smith4567 и Smith5678.
На первый взгляд такой подход кажется нормальным, но целочисленное значение увеличивает размер ключа, что может стать проблемой при большом количестве дубликатов, а эти значения станут основой некластеризованного индекса или ссылкой внешнего ключа. По этим причинам вы всегда должны стараться создавать уникальный кластеризованный (unique clustered indexes) при любой возможности. Если это невозможно, то по крайней мере постарайтесь использовать столбцы с очень высоким содержание уникальных значений.
Как хранится таблица, если не был создан кластеризованный индекс?
SQL Server поддерживает два типа таблиц: кластеризованные таблицы, имеющие кластеризованный индекс и таблицы-кучи или просто кучи. В отличие от кластеризованных таблиц данные в куче не сортированы никоим образом. По сути это и есть нагромождение (куча) данных. Если вы добавите строку к такой таблице, то подсистема хранения данных просто добавит её к концу страницы. Когда страница заполнится данными, то они будут добавлены на новую страницу. В большинстве случаев, вы захотите создать кластеризованный индекс на таблице, чтобы получить преимущества от возможности сортировки и ускорения запросов (попробуйте представить себе найти телефонный номер в адресной книге, не отсортированной по какому-либо принципу). Однако, если вы решите не создавать кластеризованный индекс, то вы по-прежнему можете создать у кучи некластеризованный индекс. В этом случае каждая строка индекса будет иметь указатель на строку кучи. Указатель включает в себя идентификатор файла, номер страницы и номер строки с данными.
Какая взаимосвязь между ограничениями на уникальность значения и первичным ключом с индексами таблицы?
Первичный ключ и и ограничение уникальности обеспечивают, что значения в столбце будут уникальны. Вы можете создать только один первичный ключ у таблицы и он не может содержать значения NULL. Вы можете создать у таблицы несколько ограничений на уникальность значения и каждый из них может иметь единственную запись с NULL.
Когда вы создаете первичный ключ, подсистема хранения данных так же создает уникальный кластеризованный индекс, в случае если уже кластеризованный индекс не был создан. Однако, вы можете переопределить установленное по умолчанию поведение и тогда будет создан некластеризованный индекс. Если кластеризованный индекс существует когда вы создаёте первичный ключ, то будет создан уникальный некластеризованный индекс.
Когда вы создаете ограничение на уникальность, подсистема хранения данных создает уникальный некластеризованный индекс. Но вы можете указать создание уникального кластеризованного индекса, если он не был создан ранее.
В общем случае, ограничение на уникальность значение и уникальный индекс это одно и то же.
Почему в SQL Server кластеризованные и некластеризованные индексы называются сбалансированным деревом?
Базовые индексы в SQL Server, кластеризованные или некластеризованные, распространяются по наборам страниц – узлам индекса. Эти страницы организованы в виде определенной иерархии с древовидной структурой, называемой сбалансированным деревом. На верхнем уровне находится корневой узел, на нижнем, конечные узлы листьев, с промежуточными узлами между верхним и нижним уровнями, как показано на рисунке:
Корневой узел предоставляет главную точку входа для запросов, пытающихся получить данные через индекс. Начиная с этого узла, подсистема запросов инициирует переход по иерархической структуре вниз к подходящему конечному узлу, содержащему данные.
К примеру, представим, что поступил запрос на выборку строк, содержащих значение ключа равное 82. Подсистема запросов начинает работу с корневого узла, который отсылает к подходящему промежуточному узлу, в нашем случае 1-100. От промежуточного узла 1-100 происходит переход к узлу 51-100, а оттуда к конечному узлу 76-100. Если это кластеризованный индекс, то на листе узла содержится данные строки, ассоциированной с ключом равным 82. Если же это некластеризованный индекс, то лист индекса содержит указатель на кластеризованную таблицу или конкретную строку в куче.
Как вообще индекс может улучшить производительность запросов, если приходится переходить по всем этим индексным узлам?
Во-первых, индексы не всегда улучшают производительность. Слишком много неверно созданных индексов превращают систему в болото и понижают производительность запросов. Правильнее сказать, что если индексы были аккуратно применены, то они могут обеспечить значительный прирост в производительности.
Подумайте об огромной книге, посвященной настройке производительности SQL Server (бумажной, не об электронном варианте). Представьте, что вы хотите найти информацию о конфигурировании Регулятора ресурсов. Вы можете водить пальцем постранично через всю книгу или открыть содержание и узнать точный номер страницы с искомой информацией (при условии, что книга правильно проиндексирована и в содержании верные указатели). Безусловно, это сэкономит вам значительное время, не смотря на то, что вам надо сначала обратиться к совершенно другой структуре (индексу), чтобы получить необходимую вам информацию из первичной структуры (книги).
Как и книжный указатель, указатель в SQL Server позволяет вам выполнять точные запросы к нужным данным вместо полного сканирования всех данных, содержащихся в таблице. Для маленьких таблиц полное сканирование обычно не проблема, но большие таблицы занимают много страниц с данными, что в результате может привезти с значительному времени выполнения запроса, если не существует индекса, позволяющего подсистеме запросов сразу получить правильное месторасположение данных. Представьте, что вы заблудились на многоуровневой дорожной развязке перед крупным мегаполисом без карты и вы поймёте идею.
Если индексы настолько замечательны, то почему бы просто не создать их на каждый столбец?
Ни одно доброе дело не должно оставаться безнаказанным. По крайней мере, именно так и обстоит дело с индексами. Разумеется, индексы отлично себя показывают, пока вы выполняете запросы на выборку данных оператором SELECT, но как только начинается частый вызов операторов INSERT, UPDATE и DELETE, так пейзаж очень быстро меняется.
Когда вы инициируется запрос данных оператором SELECT, подсистема запросов находит индекс, продвигается по его древовидной структуре и обнаруживает искомые данные. Что может быть проще? Но все меняется, если вы инициируете оператор изменения, такой как UPDATE. Да, для первой части оператора подсистема запросов может снова использовать индекс для обнаружения модифицируемой строки – это хорошие новости. И если происходит простое изменение данных в строке, не затрагивающее изменение ключевых столбцов, то процесс изменения пройдет вполне безболезненно. Но что, если изменение приведет к разделению страниц, содержащих данные, или будет изменено значение ключевого столбца, приводящее к переносу его в другой индексный узел – это приведёт к тому, что индексу может потребоваться реорганизация, затрагивающая все связанные индексы и операции, в результате будет повсеместное падение производительности.
Аналогичные процессы происходят при вызове оператора DELETE. Индекс может помочь найти месторасположение удаляемых данных, но само по себе удаление данных может привести к перестановке страниц. Касаемо оператора INSERT, главного врага всех индексов: вы начинаете добавлять большое количество данных, что приводит к изменению индексов и их реорганизации и все страдают.
Так что учитывайте виды запросов к вашей базе данных при размышлениях какой тип индексов и в каком количестве стоит создавать. Больше не значит лучше. Перед тем как добавить новый индекс на таблицу просчитайте стоимость не только базовых запросов, но и объем занимаемого дискового пространства, стоимость поддержания работоспособности и индексов, что может привести к эффекту домино для других операций. Ваша стратегия проектирования индексов один из важнейших аспектов внедрения и должна включать в рассмотрение множество соображений: от размера индекса, количества уникальных значений, до типа поддерживаемых индексом запросов.
Обязательно ли создавать кластеризованный индекс на столбце с первичным ключом?
Вы можете создать кластеризованный индекс на любой столбце, соответствующем необходимым условиям. Это верно, что кластеризованный индекс и ограничение первичного ключа созданы друг для друга и их брак заключен на небесах, так что усвойте факт, что когда вы создаете первичный ключ, тогда же будет автоматически создан кластеризованный индекс, если он не был создан ранее. Тем не менее, вы можете решить, что кластеризованный индекс будет лучше работать в другом месте, и часто ваше решение будет вполне оправданным.
Главная цель кластеризованного индекса это сортировка всех строк к вашей таблице на основе ключевого столбца, указанного при определении индекса. Это обеспечивает быстрый поиск и легкий доступ к данным таблицы.
Первичный ключ таблицы может быть хорошим выбором, потому что он однозначно идентифицирует каждую строку в таблицы без необходимости добавлять дополнительные данные. В некоторых случаях лучшим выбором будет суррогатный первичный ключ, обладающий не только признаком уникальности, но и малым размером, а значения которого увеличиваются последовательно, что делает некластеризованные индексы, основанные на этом значении более эффективными. Оптимизатор запросов также любит такое сочетание кластеризованого индекса и первичного ключа, потому что соединение таблиц происходит быстрее, чем при соединении другим способом, не использующим первичный ключ и ассоциированный с ним кластеризованный индекс. Как я и говорил это брак, заключенный на небесах.
В конце стоит, однако, отметить, что при создании кластеризованного индекса необходимо принять во внимание несколько аспектов: как много некластеризованных индексов будет основываться на нём, как часто будут изменяться значение ключевого столбца индекса и на сколько ни большие. Когда значение в столбцах кластеризованого индекса изменятся или индекс не будет обеспечивать должной производительности, тогда все другие индексы таблицы могут быть задеты. Кластеризованный индекс должен быть основан на наиболее устойчивом столбце, значения которого увеличиваются в определенном порядке, но не изменяются в случайном. Индекс должен поддерживать запросы к наиболее часто используемым данным таблицы, таким образом запросы получают все преимущества того, что данные сортированы и доступны на корневых узлах, листьях индекса. Если первичный ключ соответствует этому сценарию, то используйте его. Если же нет, то выберите другой набор столбцов.
А что если проиндексировать представление, то это по-прежнему будет представление?
Представление – это виртуальная таблица, формирующая данные из одной или нескольких таблиц. По сути, это именованный запрос, который получает данные из нижележащих таблиц, когда вы вызываете запрос к этому представлению. Вы можете улучшить производительность запросов, создав кластеризованных индекс и некластеризованные индексы у этого представления, аналогично как вы создаете индексы у таблицы, но основной нюанс состоит в том, что первоначально создается кластеризованный индекс, а затем вы можете создать некластеризованный.
Когда создается индексированное представление (материализованное представление), тогда само определение представления остается отдельной сущностью. Это, в конце концов, всего лишь жестко прописанный оператор SELECT, хранящийся в базе данных. А вот индекс совсем другая история. Когда вы создаете кластеризованный или некластеризованный индекс у предастваления, то данные физически сохраняются на диск, аналогично обычному индексу. В дополнение, когда в нижележащих таблицах изменяются данные, то индекс представления автоматически изменяется (это означает, что вы можете захотеть избежать индексирования представлений тех таблиц, в которых происходят частые изменения). В любом случае, представление остается представлением — взглядом на таблицы, но именно выполненном в данный момент, с индексами ему соответствующими.
Перед тем как вы сможете создать индекс у представления, оно должно соответствовать нескольким ограничениям. К примеру, представление может ссылаться только на базовые таблицы, но не другие представления и эти таблицы должны находиться в той же самой базе данных. На самом деле там множество других ограничений, так что не забудьте обратиться к документации по SQL Server за всеми грязными подробностями.
Зачем использовать покрывающий индекс взамен составного индекса?
Во-первых, давайте убедимся, что мы понимаем различие между ними. Составной индекс это просто обычный индекс, в который включено больше одного столбца. Несколько ключевых столбцов может использоваться для обеспечения уникальности каждой строки таблицы, также возможен вариант, когда первичный ключ состоит из нескольких столбцов, обеспечивающих его уникальность, или вы пытаетесь оптимизировать выполнение часто вызываемых запросов к нескольким столбцам. В общем, однако, чем больше ключевых столбцов содержит индекс, тем менее эффективна работа этого индекса, а значит составные индексы стоит использовать разумно.
Как было сказано, запрос может извлечь огромную выгоду, если все необходимые данные сразу расположены на листьях индекса, как и сам индекс. Это не проблема для кластеризованного индекса, т.к. все данные уже там (вот почему так важно хорошенько подумать когда вы создаете кластеризованный индекс). Но некластеризованный индекс на листьях содержит только ключевые столбцы. Для доступа ко всем остальным данным оптимизатору запросов необходимы дополнительные шаги, что может вызвать значительные дополнительные накладные расходы для выполнения ваших запросов.
Вот где покрывающий индекс спешит на помощь. Когда вы определяете некластеризованный индекс, то можете указать дополнительные столбцы к вашим ключевым. К примеру, представим, что ваше приложение часто запрашивает данные столбцов OrderID и OrderDate в таблице Sales:
Вы можете создать составной некластеризованный индекс на обоих столбцах, но столбец OrderDate только добавит накладных расходов на обслуживание индекса, но так и не сможет служить особо полезным ключевым столбцом. Лучшее решение будет это создание покрывающего индекса с ключевым столбцом OrderID и дополнительно включенным столбцом OrderDate:
При этом вы избегаете недостатков, возникающих при индексации излишних столбцов, в то же время сохраняете преимущества хранения данных на листьях при выполнении запросов. Включенный столбец не является частью ключа, но данные хранятся именно на конечном узле, листе индекса. Это может улучшить производительность выполнения запроса без каких либо дополнительных расходов. К тому же, на столбцы, включенные в покрывающий индекс, накладывается меньше ограничений, нежели на ключевые столбцы индекса.
Имеет ли значение количество дубликатов в ключевом столбце?
Когда вы создаете индекс, вы обязаны постараться уменьшить количество дубликатов в ваших ключевых столбцах. Или более точно: стараться держать коэффициент повторяющихся значений настолько низким, насколько это возможно.
Если вы работаете с составным индексом, то дублирование относится ко всем ключевым столбцам в целом. Отдельный столбец может содержать множество повторяющихся значений, но повторения среди всех столбцов индекса должно быть минимальным. К примеру, вы создаете составной некластеризованный индекс на столбцах FirstName и LastName, вы можете иметь множество значений равных John и множество Doe, но вы хотите иметь как можно меньше значений John Doe, или лучше только одно значение John Doe.
Коэффициент уникальности значений ключевого столбца называется избирательностью индекса. Чем больше уникальных значений, тем выше избирательность: уникальный индекс обладает наибольшей возможной избирательностью. Подсистема запросов очень любит столбцы с высоким значением избирательности, особенно если эти столбцы участвуют в условиях выборки WHERE ваших наиболее часто выполняемых запросов. Чем выше избирательность индекса, тем быстрее подсистема запросов может уменьшить размер результирующего набора данных. Обратной стороной, разумеется, является то, что столбцы с относительно небольшим количеством уникальных значений редко будут хорошими кандидатами на индексирование.
Можно ли создать некластеризованный индекс только для определенного подмножества данных ключевого столбца?
По умолчанию, некластеризованный индекс содержит по одной строке для каждой строки таблицы. Конечно, вы можете сказать то же самое относительно кластеризованного индекса, принимая в расчет, что такой индекс это и есть таблица. Но что касается некластеризованного индекса, то отношение «один к одному» важный концепт, потому что, начиная с версии SQL Server 2008, у вас есть возможность создать фильтруемый индекс, который ограничивает включенные в него строки. Фильтруемый индекс может улучшить производительность выполнения запросов, т.к. он меньше по размеру и содержит отфильтрованную, более аккуратную, статистику, чем вся табличная — это приводит к созданию улучшенных планов выполнения. Фильтруемый индекс также требует меньше места для хранения и меньших затрат на обслуживание. Индекс обновляется только когда изменяются подходящие под фильтр данные.
В дополнение, фильтруемый индекс легко создать. В операторе CREATE INDEX просто необходимо указать в WHERE условие фильтрации. К примеру, вы можете отфильтровать из индекса все строки, содержащие NULL, как показано в коде:
Мы можем, фактически, отфильтровать любые данные, которые не важны в критических запросах. Но будьте внимательны, т.к. SQL Server накладывает несколько ограничений на фильтруемые индексы, такие, как невозможность создать фильтруемый индекс у представления, так что внимательно читайте документацию.
Также, может случиться, что вы можно достичь подобных результатов созданием индексированного представления. Однако, фильтруемый индекс имеет несколько преимуществ, таких как возможность уменьшить стоимость обслуживания и улучшить качество ваших планов выполнения. Фильтруемые индексы также допускают перестройку в онлайн-режиме. Попробуйте это сделать с индексируемым представлением.
Целью появления данного перевода на страницах Хабрахабра было рассказать или напомнить вам о блоге SimpleTalk от RedGate.
В нём публикуется множество занимательных и интересных записей.
Я не связан ни с продуктами фирмы RedGate, ни с их продажей.
Введение

Вы любите SQL и хотите улучшить свои навыки выполнения SQL-запросов? Вы знаете, что индексация — отличный инструмент для оптимизации запросов, но при этом не уверены, что она из себя представляет, с какой целью и как используется?
Добро пожаловать! Вы оказались именно там, где нужно. Сейчас объясним суть индексации на простом и понятном языке.
Представьте, что вы состоите в команде по аналитике электронной коммерции на Amazon и работаете с огромным объемом данных, включающих миллионы строк. Для наглядности воспользуемся условной таблицей с именем product , содержащей 12 миллионов товаров. Кстати, именно такое количество и продается на Amazon, не считая книг, аудио и видеотехники, алкогольной продукции и услуг.
Начнем с простого запроса:
Для его выполнения база данных (БД) должна просканировать все 12 миллионов строк, чтобы проверить каждую запись на соответствие. Предположим, что время этой операции составляет 4 секунды.
Можно ли быстрее? Конечно. А Как? С помощью индексации.
Индексация
Понятие индексации
Свое название индексация получила по образу и подобию книжного индекса. Если, читая книгу по статистике, вы ищите информацию о “линейной регрессии”, то, вряд ли, станете поочередно перелистывать сотни страниц, чтобы добраться до главы с интересующим вас материалом.
Вы просто откроете страницу индексов, найдете “линейную регрессию” и сразу перейдете на нужную страницу.
Индексация позволяет задействовать данный метод и в работе БД, которая с помощью созданного индекса быстро находит данные по запросу. А как именно это происходит, разберемся далее.
Создание индексов
Давайте создадим индекс для таблицы product и включим в него ‘category’:
В отличии от обычного запроса выполнение вышеуказанного займет гораздо больше времени. БД просканирует 12 миллионов строк и с нуля создаст индекс category . Допустим, на это уйдет 4 минуты.
Теперь же задействуем индекс и протестируем выполнение самого первого нашего запроса:
Как видно, в этот раз он будет выполняться намного быстрее и, вероятно, займет 400 миллисекунд.
Даже расширенные запросы, содержащие в качестве условия не только category , станут более эффективными благодаря созданному индексу. Рассмотрим пример:
Выполнение этого запроса займет меньше времени, чем обычно — около 600 миллисекунд. С помощью индекса БД быстро найдет все товары ‘electronics’ и из небольшого списка записей выберет ‘headphones’.
А сейчас изменим порядок условий в пункте WHERE .
Несмотря на упоминание product_subcategory до category , БД тем не менее сначала выберет столбец с индексом, а именно category , после чего просканирует строки в поиске указанной product_subcategory из числа имеющихся записей.
Какова же внутренняя суть процесса?
БД анализирует все возможные пути выполнения запроса, выбирая самый оптимальный из них.
Теперь пора познакомиться с некоторыми терминами БД. Каждый возможный путь называется планом выполнения запроса. По сути, это последовательность операций для получения результата SQL-запроса в реляционной системе управления базами данных (СУРБД).
А компонент СУРБД, определяющий наиболее эффективный способ выполнения запроса с учетом анализа всех возможных планов, называется оптимизатором запросов.
Индексация по нескольким столбцам
Теперь рассмотрим индексацию по нескольким столбцам.
Индекс можно создать более чем для одного столбца.
Итак, теперь у нас есть индекс для обоих столбцов: category и product_subcategory . Обратите внимание, что здесь важна очередность — сначала сортируются данные в category , после чего в product_subcategory .
Данный тип индекса еще больше ускорит выполнение запроса, предположительно до 60 миллисекунд.
Более того, БД может включать более одного индекса.
В каких случаях следует применять индексацию?
Индексы ускоряют работу БД, а по мере ее разрастания их эффективность становится очевиднее.
При этом важно помнить о том, что:
- Индексам необходимо место для хранения.
- При добавлении данных в БД сначала обновляется исходная таблица, а затем все ее индексы.
В связи с этим, лучше использовать индексы для БД в хранилищах данных, получающих плановые обновления, т. е. в часы наименьшей нагрузки, а не для производственных, которые обновляются постоянно. Это объясняется тем, что при постоянных обновлениях БД индексы обновляться не будут, а следовательно станут бесполезны.
Типы индексов
Здесь мы кратко рассмотрим 2 типа индексов БД для лучшего понимания темы:
1. Кластеризованные индексы
2. Декластеризованные индексы
Кластеризованные индексы
Кластеризованные называется особый индекс, который использует первичный ключ для структуризации данных в таблице. Он не требует явного объявления и создается по умолчанию при определении ключа. Отсортированный же в порядке возрастания первичный ключ по умолчанию применяется в качестве кластеризованного индекса.
Продемонстрируем вышесказанное на простом примере:
Для таблицы product будет автоматически создан кластеризованный индекс product_pkey , сформированный вокруг первичного ключа product_id .
В этом случае при выполнении в таблице поискового запроса по product_id , как показано ниже, кластеризованный индекс поможет БД оптимально справиться с задачей и быстрее вернуть результат.
Интересно, как же именно это происходит?
Индексы используют оптимальный метод поиска, известный как двоичный поиск.
Двоичный поиск — это эффективный алгоритм поиска записи в сортированном списке. Принцип его работы основан на повторяющемся делении данных пополам и определении того, находится ли искомая запись до или после записи в середине структуры данных. Если значение искомой записи меньше срединного, то поиск продолжается в первой половине, иначе — во второй. Эта процедура повторяется вплоть до нахождения значения. Благодаря данному методу уменьшается число требуемых поисков и, следовательно, ускоряется выполнение запросов.
Следующая таблица отражает соотношение записей данных и максимальное число поисков:
Аналогичным образом для нашего датасета с 12 миллионами строк понадобится не 12 миллионов, а всего лишь 24 поиска — и всё благодаря двоичному поиску. Думаю, теперь вы осознаете супер силу индексов.
Некластеризованный индекс
Теперь узнаем, как применить преимущества индексации к столбцами, отличающимися от первичного ключа. Для этого существуют некластеризованные индексы.
Их примеры уже встречались в начальных разделах статьи во время написания оптимизированных запросов — это индексы, которые требуют явного определения.
Некластеризованный индекс хранится в одном месте, а физические данные таблицы — в другом. Опять нам на ум приходит сравнение со страницей индексов, которая размещается отдельно от содержимого книги. Благодаря этой особенности для каждой таблицы можно создавать более одного некластеризованного индекса, как было показано ранее.
Как именно это происходит?
Предположим, вы уже создали некластеризованный индекс для столбца и теперь пишите запрос для поиска в нем записи. Этот индекс содержит следующее:
- записи столбца, для которых был создан индекс;
- адреса соответствующей строки (в основной таблице), в которой находится запись столбца.
Это наглядно отображено в таблице слева на рис.6:
Давайте рассмотрим этот запрос более подробно:
БД совершает 3 шага:
- Во-первых, она переходит по некластеризованному индексу ( product_category_index ) и методом двоичного поиска находит искомую запись столбца ( category = ‘electronics’ ).
- Во-вторых, в основной таблице она ищет адреса соответствующей строки, в которой находится запись столбца.
- В-третьих, она переходит к этой строке в основной таблице и выбирает другие значения столбца в соответствии с требованиями запроса ( product_name, price ).
Как видим, работа с некластеризованным индексом предполагает дополнительный шаг, включающий поиск адреса строки и переход к ней в основной таблице. Следовательно запрос с таким индексом выполняется медленнее в отличие от кластеризованного аналога.
Заключение
Итак, мы выяснили, что такое индексы и какую роль они играют в оптимизации выполнения SQL-запросов, особенно при работе с огромными датасетами.
В завершении приведу вам высказывание Тайгера Вудса, лучшего гольфиста всех времен:
“Независимо от того, насколько хорошо вы играете, вы всегда можете стать лучше, и это вдохновляет”.
Все, что необходимо знать про индексы MS SQL
Предлагаем расширить знания об индексах в MS SQL Server. Получите полное представление о них, преимуществах использования, структуре. Узнаете, как создавать индексы, оптимизировать и удалять. Все самое полезное читайте в одной статье.
Что такое индексы в sql server
Разберемся в понятии индексов (indexes) – это особые таблицы, используемые поисковыми системами для поиска данных. Их активное использование играет важнейшую роль в повышении производительности sql серверов.
Словно указатель в грамотно составленной книге, индекс помогает быстро получить доступ к строкам требуемых данных в таблице, соответствующих запросу. Таким образом, их использование позволяет ускорить выполнение требуемого запроса.
К примеру, для получения всех страниц в книге, касающихся выбранной тематики, сначала нужно обратиться к перечню тем, а затем выбрать нужные страницы. Для этого следует создать индекс по выбранной теме. На ее основе и будут выбираться ссылки на страницы книги по затронутой теме. Используя значения, заданные первичным ключом, sql server найдет нужный индекс и с его помощью быстро выберет все строки с необходимыми данными. Если не использовать индекс, то для поиска информации будет произведено сканирование каждой строки таблицы. Это значительно понизит производительность и увеличит время поиска.
Благодаря индексу процесс поиска данных сокращается за счет их упорядочивания как физического, так и логического. Таким образом, он выглядит как набор ссылок на данные, которые упорядочены по выбранному столбцу таблицы. Такой столбец называется индексированным. Индексы находятся в таблице и по сути выступают полезными внутренними механизмами системы sql-сервера, которые помогают сделать доступ к данным наиболее оптимальным.
Создать стандартный индекс можно на всех столбцах данных, кроме:
- столбцов, которые используются для хранения данных объектов, имеющих большие размеры, (LOB): TEXT, IMAGE, VARCHAR (MAX);
- представленных в XML. Для работы с данными, представлены в таком формате используются xml-index, которые отличаются от стандартных. О них рассказано ниже.
Об индексах и кучах
Как только таблица создана и в ней еще нет индексов, она выглядит как куча данных (Heap). В ней все записи хранятся хаотично, без определенного порядка. Потому их и называют «кучами».
Если в таблице необходимо найти определенные данные, sql server просканирует ее (Table scan). Пока в таблице не заданы индексы, поддерживающие ограничения (UNIQUE CONSTRAINT, UNIQUE INDEX или PRIMARY KEY), сервер прочитает все табличные записи (с первой до последней) и выберет те, которые удовлетворяют условиям поиска.
Это демонстрирует базовые функции indexes:
- повышение скорости поиска информации и производительности запросов;
- сохранение целостности данных через обеспечение уникальности строк таблицы.
Но не всегда индекс помогает ускорить поиск информации. Для таблиц небольших размеров обычный перебор данных может оказаться намного эффективнее выборки данных по индексам.
Indexes имеют и недостатки:
- требуется много места на дисковом пространстве и в оперативной памяти. Чем длиннее ключ, тем большего размера индекс и место для его хранения;
- замедляется производительность системы (медленнее выполняются операции вставок, обновления либо удаления записей).
Но современные методы их создания позволяют не только снижать негативный эффект для вышеперечисленных операций, но и увеличивать скорость выполнения.
Структура
Все индексы имеют одинаковую структуру (structure). Они состоят из:
- наборов страниц;
- узлов, имеющих древовидную структуру, иерархическую по природе.
Все они хранятся в виде сбалансированных B-деревьев (B-tree). Начало такого дерева расположено в корневом узле (находящимся на вершине иерархии) и по сути является «входной дверью». Этот узел имеет одну страницу, в которой содержатся указатели на ключи последующих уровней.
В нижней части иерархии расположены листья дерева (являющиеся конечными узлами). Длины веток одинаковы.
В таком дереве сбалансирована каждая ветка. Благодаря внутреннему механизму при любых изменениях в таблице дерево снова становится сбалансированным.
При формировании запроса к индексированному столбцу подсистема начинает процесс поиска с верхнего узла к нижним, проходя промежуточные и обрабатывая их. На каждом уровне располагается все более развернутая информация о запрашиваемых данных. Как только достигается нижний уровень листьев (leaf level) поиск прекращается, т.к. подсистема запросов находит необходимое значение.
Типы индексов
В Microsoft SQL Server используются следующие индексы: кластерные и некластерные. Рассмотрим их подробнее.
Кластерный индекс
Основная его задача — сохранение табличных данных в виде, отсортированном по значению ключа. Таблице или представлению может быть присущ лишь единственный кластеризованный индекс (Clustered index), потому что табличные данные могут отсортировываться в едином возможном порядке – либо возрастания, либо убывания. По возможности, у каждой таблицы должен быть Clustered index.
Табличные данные будут храниться отсортированными лишь в том случае, когда таблица имеет кластеризованный индекс. Строки табличных данных Clustered index хранит в уровнях листьев.
Если у таблицы нет Clustered index, в момент формирования ограничений PRIMARY KEY и UNIQUE, он формируется автоматически. Когда для таблиц/ куч созданы Nonclustered indexes, то в процессе создания Clustered index все некластеризованные должны быть перестроены.
Содержание листьев зависит от того, индекс кластерный или некластерный. Они могут содержать как табличные данные, так и ссылки, указывающие на строки с ними.
Некластерный индекс
Некластеризованными (Nonclustered) называют такие индексы, которые содержат:
- значения ключей – ключевые столбцы, по которым они определены;
- указатели на строки в таблице, содержащие реальные данные (значения ключа).
Чтобы обнаружить и получить запрашиваемые данные, для системы подзапросов потребуется совершение дополнительных операций. Содержимое указателей на запрашиваемые данные полностью зависит от того, как они хранятся.
Он может указывать на:
- кучу и тем самым приводить к идентификатору строки с искомыми данными;
- таблицу с Clustered index, указывая, что именно он используется что для поиска действительных данных.
Nonclustered indexes могут быть расширены дополнительными столбцами (included column). А значит, листья будут сохранять значения индексированных и дополнительных неиндексированных столбцов. Это свойство дает возможность обойти определенные ограничения, возложенные на индекс. Данный подход позволяет включать неиндексируемые столбцы либо обходить ограничения на длину индекса.
Главные свойства Nonclustered indexes:
- их нельзя отсортировать;
- на таблицу или представление можно сформировать свыше одного (до 999) некластеризованных индексов. Но не стоит создавать максимальное количество Nonclustered indexes. Нужно помнить, что они способны как повысить, так и понизить производительность.
Nonclustered indexes могут создаваться на любых таблицах, в том числе и имеющих кластерный индекс.
Специальные типы индексов
Существует большое число специальных индексов, которые могут быть как кластерными, так и некластерными. Рассмотрим некоторые из них.
Фильтруемый
Фильтруемым (Filtered) индексом называют оптимизированный Nonclustered index, в котором задействован предикат фильтра для индексации части строк в таблице.
Тщательно спроектированный Filtered index способен:
- увеличить производительность;
- уменьшить затраты на обслуживание и хранение индексов.
Составной
Составным называют индекс, который:
- может включать более одного (до 16) столбцов, выступающих ключевыми значениями;
- ограничивается общей длиной (не превышающей 900 байт);
- содержит поля, которые принадлежат единой таблице.
Простые индексы, в отличие от составных, создаются лишь по единственному столбцу.
Создание составных индексов целесообразно, когда:
- для поискового запроса ключами выступают два и более столбцов;
- в поисковом запросе используются все поля составного индекса. Поисковый запрос, в котором не задействованы все поля, вероятнее всего, использоваться не будет.
Отличным примером может служить телефонный справочник. Он сформирован по фамилии и имени, т.к. много людей имеют одинаковую фамилию. Следовательно, логично будет создать индекс одновременно и по фамилии, и по имени.
Отметим, что наивысший приоритет в процессе сортировки принадлежит первым колонкам, описываемым в CREATE INDEX. Потому, в числе первых должны указываться колонки уникальные. Чтобы индекс был задействован при выборке данных в таблице, сам запрос обязательно должен ссылаться именно на колонку, указанную первой.
Использование составных индексов поможет увеличить производительность за счет того, что для выполнения поиска данных сервер будет сканировать только его, что поможет снизить в таблице число индексов.
Query Optimizer использует их в зависимости от структуры запроса.
Уникальный
Уникальным (Unique) называют индекс, обеспечивающий уникальное значение всех строк по определенному ключу и гарантирующий, что в ключе индекса не будет значений одинаковых, повторяющихся. Для составного ключа понятие уникальности касается всех index columns, но не распространяется на каждый столбец в отдельности.
Если в таблице формируется Unique index одновременно по ряду столбцов, это означает, что абсолютно каждая вариация значений в ключе будет уникальной.
SQL сервером создается автоматически Unique index для ключевых столбцов при формировании ограничений UNIQUE либо PRIMARY KEY. Но он формируется лишь при выполнении условия отсутствия дублей в ключевых столбцах таблицы.
Уникальный индекс создается автоматом при определении ограничений столбца:
- первичным ключом (на один столбец либо сразу на несколько), при условии, что кластерный индекс ранее не создавался. В том случае, когда он все-таки уже создан, сервер создаст уникальный некластерный индекс по первичному ключу;
- ограничением на уникальность значений – сервером создается Unique Nonclustered index. Когда кластерный индекс не был сформирован заранее, есть возможность создания именно Unique Clustered index.
Колоночный
Колоночным (Columnstore) называют индекс, в котором данные хранятся в столбцах. Использование Columnstore indexes наиболее целесообразно применять для крупных хранилищ, т.к. они помогут:
- производительность запросов увеличить в несколько раз;
- размеры данных уменьшить (благодаря их сжатию).
Пространственный
Пространственным (Spatial) называют тип расширенного индекса, позволяющего индексировать столбцы с пространственными данными (представленные в типах Geography или Geometry). Spatial index позволяет наилучшим образом использовать определенные операции запросов относительно пространственных столбцов и может создаваться только для них.
Основное условие создания пространственного индекса – наличие PRIMARY KEY для таблиц.
Полнотекстовый
Полнотекстовые (Full-text) индексы применяются для повышения эффективности поиска определенных слов в строках, где данные представлены в символах.
Действия по созданию и обслуживанию Full-text indexes называются «заполнениями». Встречаются заполнения:
- полное – осуществляется SQL сервером после создания нового Full-text index. Размер таблицы влияет на затребованный объем ресурсов. При увеличении размера на операцию требуются ресурсы большего размера. Потому предусмотрена возможность откладывания этого процесса;
- основанное на отслеживании изменений – применяется для того, чтобы обслуживать Full-text index после полного заполнения (первоначального).
Покрывающий
Покрывающим (Covering) называют индекс, позволяющий на конкретный запрос получать запрашиваемую информацию в полном объеме с листьев индекса, не обращаясь к записям таблицы. А значит, в Covering index хранится достаточный объем данных для полноценного ответа на запрос. Потому нет необходимости обращаться к таблице.
Благодаря тому, что ответ можно получить без использования таблицы, покрывающие индексы быстрее остальных. Однако, они становятся достаточно большими, потому злоупотреблять ими не стоит.
XML-индекс
XML – специфический тип индекса, предназначенный для работы с данными в столбцах таблицы, представленными в соответствующем формате. Он делает более эффективной обработку поисковых запросов к ним.
- первичные – индексируют, хранят в столбцах XML теги, пути, значения. Целесообразно создавать, когда таблица по первичному ключу имеет кластерный индекс;
- вторичные – создаются лишь для таблиц с первичным XML-index. Применяются для увеличения производительности системы по определенному типу обращения к XML-столбцам. Встречаются типы XML-indexes: PATH, VALUE, PROPERTY.
Индексы, используемые в оптимизированных таблицах
Активно используются специальные индексы для таблиц данных:
- оптимизированные для памяти (In-Memory OLTP). К таковым относятся Хэш индексы (Hash);
- Nonclustered indexes, которые специально создаются для сканирования (как упорядоченного, так и диапазонного) и оптимизируются для памяти.
Создание и проектирование индексов в ms sql server
Польза индексов очевидна, потому и проектироваться они должны крайне аккуратно. Созданные тщательным образом способны улучшить производительность, а непрофессионально – понизить.
Индексы занимают достаточно много дискового места, потому не имеет смысла создавать их больше, чем нужно. Более того, при каждом обновлении строк, автоматически обновляются и индексы. Это в свою очередь может потребовать увеличения ресурсов и грозить снижением производительности.
Очень важно при проектировании соблюдать ряд требований как к базам данных, так и к запросам направленным к ним.
Базы данных
Как сказано выше, производительность системы напрямую зависит от индексов. При поступлении запроса они могут увеличивать ее, обеспечивая быстрый поиск данных либо снижать, т.к. при каждой операции с данными будут изменяться и они, дабы отражать действия, производимые над данными. И не важно, что происходит с ними – добавление, удаление или обновление.
Потому, при разработке плана стратегии по индексированию, необходимо придерживаться советов специалистов:
- Если предполагается частое обновление данных в таблице, то для нее нужно применять минимум индексов.
- Для таблицы со значительным количеством данных, которые предположительно будут редко изменяться, можно использовать то число индексов, которое улучшит производительность запросов. Но для таблиц небольшого объема не всегда целесообразно вообще их использовать. Такой поиск может выполняться дольше, чем обычное сканирование таблицы.
- Для Clustered indexes используйте самые короткие поля, которые только допустимы. Лучше всего их применять на столбцах с уникальными значениями и в которых не допускается использование NULL. По этой причине чаще всего PRIMARY KEY выступает в роли Clustered index.
- Производительность индекса напрямую зависит от того, насколько уникальны значения в столбце. Она снижается с увеличением дублей если в столбце и растет с уменьшением. Потому, при каждой возможности следует использовать уникальный индекс.
- Если используется составной индекс, то в нем нужно учитывать порядок столбцов. Первыми идут те, в которых в выражениях используется WHERE. За ними – столбцы с наивысшими показателями уникальных значений. Остальные выстраиваются по мере понижения этого показателя.
- Допускается использование индекса на вычисляемых столбцах таблицы, но лишь при условии соблюдения определенных требований (для вычисления значений такого столбца могут использоваться только детерминистические выражения, т.е. результат для определенного набора входящих параметров всегда должен быть одинаковым).
Запросы к базе данных
При проектировании вторым важным пунктом является понимание и учет того, какие выполняются запросы к базе данных. Необходимо учитывать частоту изменения данных, а также требуется соблюдение определенных принципов:
- Предпочтительнее, чтобы один запрос содержал наибольшее число строк, нежели разбивать их на соответствующее число отдельных запросов.
- На столбцах, используемых в запросах с WHERE чаще всего, предпочтительнее создавать Nonclustered index в качестве условия поиска и соединения в JOIN.
- Следует воспользоваться возможностями индексирования столбцов, используемых в поисковых запросах на соответствие конкретным значениям.
Способы создания индексов
Предусмотрено создание индексов ms sql server с помощью двух инструментов. В этом помогут:
- SSMS (MSSQL Management Studio);
- специальный язык Transact-SQL (T-SQL, поддерживающий Paging Queries).
Как создать кластеризованный индекс
Как отмечалось выше, создание кластеризованного индекса sql сервером происходит автоматически, когда определенный столбец выбирается в качестве первичного ключа (PRIMARY KEY). Когда такого не происходит, следует создать кластерный индекс своими руками.
Чтобы создать Clustered index воспользуемся Management Studio. Для этого следует:
- Открыть SSMS.
- Воспользовавшись обозревателем выбрать соответствующую таблицу.
- Остановившись на пункте «Индексы» кликнуть мышкой.
- Выбрать «Создать индекс» и соответствующий тип (выбираем «Кластеризованный»).
- В новом окне появится форма «Новый индекс». Здесь потребуется вписать наименование нового создаваемого индекса (в рамках одной таблицы требуется, чтобы оно было уникальным). Поставить галочку, что он уникальный.
- Выбрать столбец, который будет являться ключом индекса. Он ляжет в основу создаваемого Clustered index. Провести сортировку строк табличных данных кнопкой «Добавить».
- После ввода всех необходимых параметров кликнуть «ОК».
Результатом действий станет кластерный индекс.
Он может быть создан и с помощью инструкций Transact-SQL CREATRE INDEX.
Как создать некластеризованный индекс
Для создания Nonclustered index можно воспользоваться Management Studio либо инструкциями T-SQL.
Создание Nonclustered index с включенными столбцами
Коснемся вопроса, как создать Nonclustered index с условием, что в индекс включены столбцы, которые не являются ключевыми. Такой индекс принято использовать в тех случаях, когда индекс создается под конкретный запрос. К примеру, чтобы индексом покрывался запрос полностью, т.е. включал все столбцы. Вследствие того, что запрос покрыт, увеличивается производительность. Это становится возможным благодаря тому, что оптимизатор запросов может получить все значения столбцов в индексе без обращения к табличным данным. Это ведет к уменьшению числа операций ввода-вывода на диске.
Однако стоит учитывать, что с включением в индекс неключевых столбцов размер его увеличивается. А значит, для его хранения понадобится больше дискового пространства. Это также может снизить производительность операций INSERT, UPDATE, DELETE и MERGE в базовой таблице данных.
Для его создания также воспользуемся Management Studio:
- Открыть SSMS.
- Воспользовавшись обозревателем выбрать требуемую таблицу и щелкнуть мышкой по пункту «Индексы».
- Выбрать «Создать индекс», а затем «Некластеризованный» (не ставить галочку на уникальности).
- В открывшейся форме «Новый индекс» вписать наименование нового индекса, добавить один или несколько ключевых столбцов, воспользовавшись кнопкой «Добавить».
- Перейти во вкладку «Включено столбцы». Добавить все столбцы, которые должны быть включены в индекс, воспользовавшись кнопкой «Добавить».
- Когда введены все нужные параметры кликнуть «ОК».
При необходимости, можно легко создать фильтруемый Nonclustered index. Для этого следует воспользоваться T-SQL и в операторе CREATE NONCLUSTERED INDEX в WHERE указать условие фильтрации. Так можно отфильтровать практически любые данные, не важные в запросах.
Удаление индекса
Пришло время узнать о том, какими способами могут удаляться индексы. Для начала воспользуемся Management Studio. Для этого необходимо:
- Открыть SSMS.
- Выбрать индекс, подлежащий удалению.
- Щелкнуть мышкой по нему и из списка выбрать «Удалить».
- Выполненное действие подтвердить нажатием «ОК».
Удаление индексов выполняется и с помощью инструкций T-SQL DROP INDEX (DROP INDEX IX_NonClustered ON TestTable). Однако ею нельзя воспользоваться для удаления тех индексов, которые создавались через формирование ограничений PRIMARY KEY и UNIQUE. Чтобы удалить их, следует воспользоваться инструкцией ALTER TABLE с предложением DROP CONSTRAINT.
Как выполнить изменение значений коэффициента, который установлен по умолчанию
Чтобы внести изменения в значения коэффициента, которые установлены по умолчанию, следует воспользоваться:
- SSMS;
- инструкцией T-SQL, выполнив запуск системной сохраненной процедуры;
- sp configure.
Особенности индексов и условий предложения WHERE
Если предложение WHERE инструкции SELECT содержит условие поиска данных с одним столбцом, то необходимо для него создать индекс. Это условие очень важно при высокой селективности (selectivity) условия.
Но он будет абсолютно бесполезным при постоянном уровне селективности от 80% и выше. Простое сканирование табличных данных потребует меньше времени.
Если в часто применяемом запросе условие поиска включает оператор AND, то лучше всего – создать составной индекс, включив в него сразу все табличные столбцы, которые указывались в предложении WHERE инструкции SELECT.
Оптимизация индексов
После выполнения любых действий с табличными данными sql сервером в тот же момент производятся соответствующие правки в индексах. Спустя некоторое время все подобные исправления могут спровоцировать фрагментацию данных. В результате, их может разбросать по всей базе.
Подобная фрагментация данных может стать причиной понижения производительности. Потому крайне важно время от времени проводить дефрагментацию. К подобным операциям по обслуживанию индексов относят реорганизацию и перестроение индексов.
Чтобы понять, какую именно операцию требуется провести – реорганизацию или перестроение, следует выяснить степень фрагментации данных. Она поможет понять, какой способ дефрагментации будет наиболее эффективным и что выбрать.
Чтобы выяснить уровень фрагментации следует воспользоваться системной табличной функцией sys.dm_db_index_physical_stats. Для определения уровня фрагментации всего перечня таблиц для выбранной базы, можете воспользоваться следующим запросом:
SELECT OBJECT_NAME(T1.object_id) AS NameTable,
T1.index_id AS IndexId,
T2.name AS IndexName,
T1.avg_fragmentation_in_percent AS Fragmentation
FROM sys.dm_db_index_physical_stats (DB_ID(), NULL, NULL, NULL, NULL) AS T1
LEFT JOIN sys.indexes AS T2 ON T1.object_id = T2.object_id AND T1.index_id = T2.index_id
Согласно рекомендациям Microsoft, последующие действия будут зависеть от уровня фрагментации:
- меньше 5% – о дефрагментации следует пока забыть;
- от 5 до 30% – требуется выполнить реорганизацию индекса. Это потребует минимального количества ресурсов системы и ее можно провести без долговременной блокировки;
- свыше 30% – следует выполнить перестроение индекса. При значительном уровне фрагментации это наиболее эффективно.
Реорганизация индекса
Реорганизацией называют процесс устранения фрагментации индекса. В его ходе происходит дефрагментация конечного уровня кластерных и некластерных индексов по таблицам и представлениям. Говоря простым языком – выполняется простое переупорядочивание страниц. В основе переупорядочивания лежит логический порядок конечных узлов (выполняете слева направо).
Если хотите провести реорганизацию – воспользуйтесь:
- MSSQL Management Studio. На выбранном индексе следует щелкнуть мышкой, из списка выбрать и нажать «Реорганизовать»;
- соответствующими инструкциями T-SQL.
Перестроение индекса
Перестроением называется операция по устранению фрагментации индекса. Он заключается в устранении старого и формировании нового.
Перестроение индекс выполняется несколькими способами. В этом поможет:
- Management Studio. Для этого необходимо выбрать нужный индекс, мышкой кликнуть по нему и выбрать «Перестроить»;
- инструкция ALTER INDEX ix с предложением REBUILD, которая по сути является заменой инструкции DBCC DBREINDEX. Ею пользуются, когда возникла потребность в масштабной операции;
- инструкция CREATE NONCLUSTERED INDEX (CREATE INDEX) с предложением DROP_EXISTING. Подходит, чтобы перестроить индекс и изменить его определения (удалить либо добавить ключевые столбцы).
Это вся полезная информация по индексам в Microsoft SQL Server. Изучайте их, а если возникнут вопросы – задавайте. Удачи в изучении и применении indexes ms sql.